是石科技发布多模态服务:视频生成提速2.48倍且画质无损
AI视频批量生产面临速度与质量的矛盾。是石科技新推出的多模态模型服务,通过自适应缓存加速、显存协同优化及Token压缩技术,在保持画质的前提下将推理速度提升2.48倍。同时引入Context Engine解决多素材结构化衔接难题,旨在降低企业级视频生成的算力成本并提高并发处理能力。
视频生成里那个“不可能三角”,眼下有了新解法。
做AI视频的人都清楚一个难处:求快,画质容易崩;求稳,算力和时间又贵得离谱。
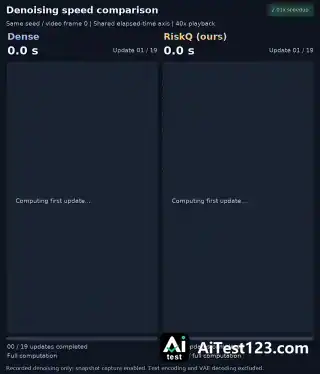
单次尝鲜的时候,等上几十秒甚至几分钟,大家还忍得住。可一旦进了批量生产,比如短剧制作、营销素材成批产出,这事就从“体验不好”变成“成本不可控”。砍掉计算步骤确实能让时间短下来,但误差会一层层累积,画面容易闪烁、变形;把完整计算过程保留下来倒是稳妥,代价是昂贵的显卡集群得长时间满负荷跑。
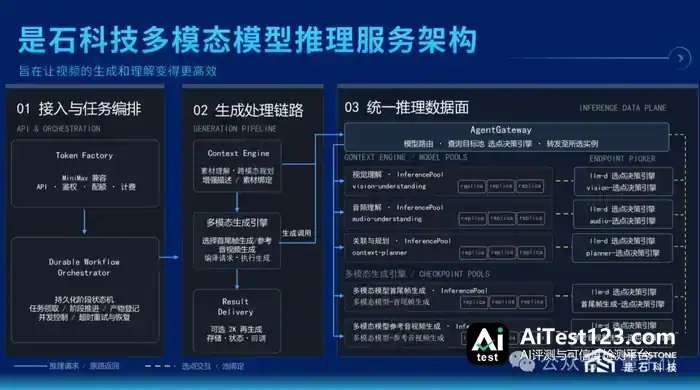
质量、速度、成本之间怎么找平衡?是石科技新发布的「多模态模型服务」想给一个工程化的答案。他们没在模型参数上单纯堆量,而是把力气花在推理加速、缓存管理、Token压缩以及素材理解链路这几个常被忽略的“基础设施”环节。
方案的核心逻辑很直白:不该算的不算,该存的存好,该压缩的压缩。官方测试数据显示,同等实验设置下,其端到端推理速度比传统Dense基线方案提升2.48倍,生成质量没有明显下降。
不盲目跳步:自适应缓存加速
视频生成模型一般走迭代式计算,从噪声一点点还原出清晰画面。这个过程中,相邻帧或相邻步骤之间往往存在大量重复、相似的信息。
传统加速办法,要么粗暴减少迭代步数,要么简单复用历史缓存。前者拿质量换速度,后者则要面对“误差累积”的风险——某一步复用了错误缓存,后面所有步骤就跟着错下去,视频于是出现诡异的扭曲或闪烁。
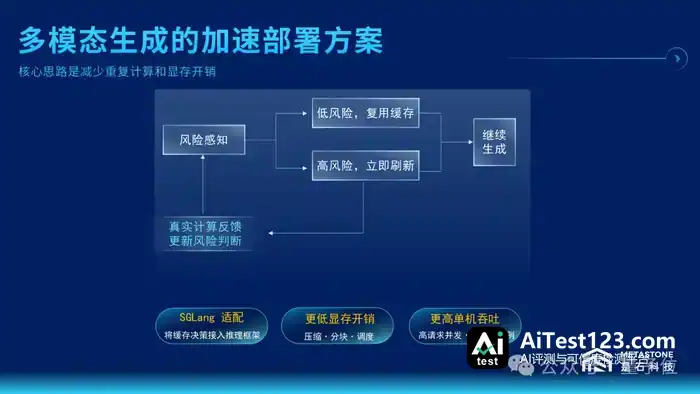
是石科技的做法是“动态判断”。他们引入一种基于历史缓存残差的自适应加速技术。说白了,系统在每一步计算时都会评估:眼下这份缓存结果靠不靠谱?
画面变化不大、历史残差显示复用风险低,系统就直接沿用之前的计算结果,省掉重复劳动;一旦检测到关键区域变化剧烈,或者误差风险偏高,系统马上触发重新计算和校准。这套机制好比一位经验丰富的剪辑师,清楚哪些镜头可以偷懒复用,哪些必须精修。
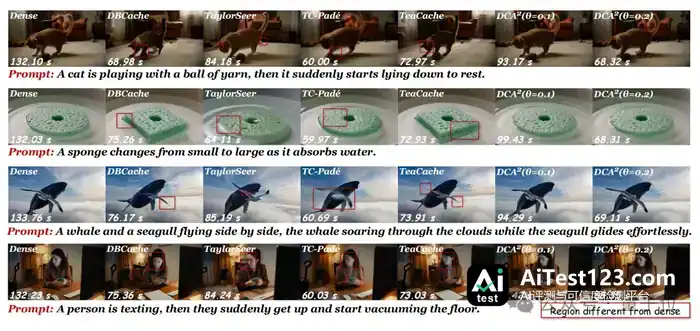
这种动态刷新策略避开了“一刀切”造成的质量损失。可视化样例里能看到,相比单纯的Dense端到端加速,该方案在保持人物面部细节、动作连贯性上更稳。2.48倍的提速不是靠削减必要计算换来的,而是精准剔除了冗余计算。
显存也是瓶颈:与SGLang结合的缓存管理
除了计算速度,显存占用是卡住并发能力的另一道坎。
多个视频生成任务同时跑起来时,缓存数据的存储、读取和更新会大量吃掉显存。管理不当的话,单个任务跑得再快,整体吞吐量也上不去——显存很快就被碎片化的缓存数据填满。
是石科技把智能缓存决策与SGLang推理框架做了深度结合。SGLang本身是高效的LLM推理引擎,擅长处理复杂调度。在此基础上,他们引入了分块处理、压缩及智能调度机制。
关键在于“风险感知”。系统不只盯着缓存命中率,也盯着缓存带来的显存压力。靠动态调整缓存策略,系统在提高复用效率的同时严格控制显存开销。这意味着同样的硬件资源下,能同时处理更多视频生成请求。
对企业用户来说,这比单纯的“单任务加速”更有意义。生产环境看重的是单位时间内的总产出(Throughput),而不只是单个视频的生成时间。降低冗余计算和缓存开销,直接换来更高的并发能力和更灵活的部署方案。
听懂音视频:免训练的Token压缩
视频生成不只是“画出来”,还得先“看懂”输入素材。
如今的多模态模型要处理图片、音频、视频片段和文字指令。视频和音频里含着高密度的时序信息。把每一帧、每一段音频都原封不动转成Token,计算量会爆炸式增长。可问题是,这些输入中有不少冗余信息——比如背景静止的画面、音频里的静音片段。
对所有Token一视同仁,既费算力又拖速度;统一压缩,又可能丢掉关键语义,比如人物口型的变化或背景音的细节。
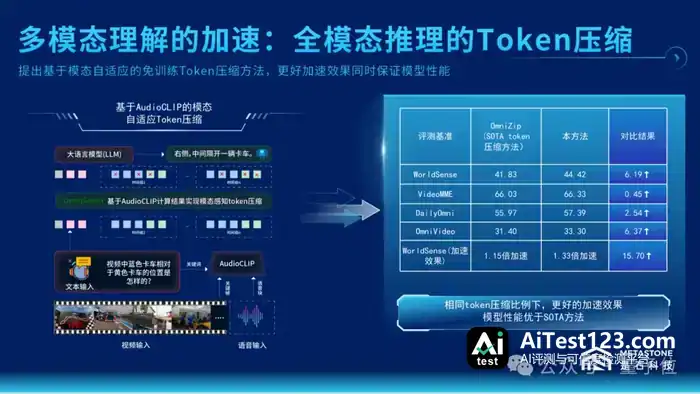
是石科技提出一种基于模态自适应的免训练Token压缩方法。借助AudioCLIP等模态感知技术,系统能识别不同模态中的有效信息密度。信息量低的片段,大幅压缩Token数量;关键语义部分,则保留高精度表示。
这套方法不用额外训练模型,即插即用。在WorldSense评测中,该方法实现1.33倍加速。在VideoMME、DailyOmni等多模态理解基准测试中,性能表现也保持稳定。这说明,通过更聪明的数据预处理,可以在不损失理解能力的前提下,显著降低多模态理解的计算负担。
Context Engine:让素材“说人话”
速度和资源这两道坎迈过去之后,实际业务里还横着一个难题:怎么让模型真正读懂创作者那些复杂的意图?
真实的视频生成需求常常很绕。用户可能一次丢来一张人物照片、一段参考音频、几段参考视频,再配一段文字描述,要的是一段口型特定、动作特定的对白视频。这些素材彼此咬得很紧:人物身份得前后一致,口型得跟音频对得上,动作还得符合镜头逻辑。
这么一堆素材直接塞给生成模型,模型就容易顾此失彼——人物长相变了,口型对不上,或者镜头乱切。过去常见的办法是写一套极其复杂的Prompt,可门槛高不说,效果也不稳。
是石科技为此搭了一个Context Engine(上下文引擎),底座是全模态模型。它的任务,就是在看懂素材和生成视频这两步之间架起一座桥。
系统先把所有输入素材解析一遍,把人物身份、声音特征、动作约束、镜头语言这些信息提取成结构化的内容。接着再把这些内容组织成模型能执行的指令,比如明确的分镜脚本、时轴校验规则。
拿人物对白视频来说,Context Engine给出的不只是一段文字提示,它会把人物图片ID、音频时间戳、唇形同步参数绑到一块,拼成一个完整的执行上下文。后面的生成模型由此能看明白:第几秒、谁、说什么话、做什么动作。
素材绑定、分镜结构化、时轴校验加上错误修正,这套结构化衔接机制把多模态生成的不确定性压下去不少。AI视频生成也因此从“抽卡”变得可控、可校验。
从“能生成”到“好生产”
把这次发布的技术细节捋一遍,能看出来石科技盯的已经不只是单个模型的能力,而是整条生产链路。
以前大家比的是模型能不能画出逼真的手、能不能生成连贯的动作。应用落地之后,竞争焦点换了:在给定的算力预算下,谁能在批量产出合格视频这件事上更稳、更快。
这条链路上的每个环节,眼下都在被优化:
- 理解端:靠Token压缩,把多模态输入的解析成本降下来;
- 衔接端:靠Context Engine,把创作意图准确传到生成模型那里;
- 生成端:靠自适应缓存加速,砍掉冗余计算,把推理速度提上去;
- 资源端:靠与SGLang结合的缓存管理,把显存利用率和并发能力抬起来。
单拎出来看,这些技术可能都只是局部优化;凑到一起,就成了一套面向生产环境的解决方案。对视频制作公司、广告代理商或者内容平台来说,这意味着AI视频生成的边际成本正在快速往下走。
技术落地当然还有难关。不同风格视频里的泛化能力、极端复杂场景下的纠错机制,都得在实际业务里慢慢磨。但方向已经清楚了:AI视频的下半场,比的不是谁生成的视频更惊艳,而是谁能让视频生成变得像水电一样稳定、便宜、好用。
是石科技这次出手,就是朝这个方向走的一步。对行业而言,这不只是一款新产品的发布,更像一个信号:AI视频正从实验室走向流水线。