是石科技发布多模态模型服务:视频生成提速2.48倍,画质不降
AI视频生成中,推理速度提升与生成质量下降,可能同时发生。
是石科技近日推出多模态模型服务。
允中 发自 凹非寺
AI视频生成过程中,推理变快和画质变差有可能一起出现。
计算步骤少了,出片时间能缩短,可误差也会一步步攒起来;把完整计算过程全保留,画质稳住了,算力和显存的开销却跟着上去。
视频生成一旦从单次尝鲜走向批量生产,摆在面前的问题就不只是模型能不能出片,而是画质、推理时延和资源成本三者怎么摆平。
是石科技这次发布的新品叫「多模态模型服务」,优化重点落在几处:视频生成推理加速、缓存与显存管理、多模态Token压缩,以及素材理解与生成链路之间的衔接。
其中:
- 其中,基于历史缓存残差的自适应加速技术,管的是视频生成里那些冗余计算;缓存管理机制借助SGLang来优化资源使用;模态自适应Token压缩则压低多模态理解的开销;基于全模态模型的Context Engine,把素材理解的结果转成视频生成模型能执行的结构化信息。
几项技术各管一段,指向的目标却一致:画质和服务稳定性不能丢,同时把多模态模型的推理效率、算力利用率提上去。
视频生成加速:砍掉冗余计算,同时压住误差累积
视频生成模型一般要跑多轮迭代,从最初的信息一点点算出视频内容。这个过程中,相邻的计算步骤之间有信息可以复用。
每一步都完整算一遍,推理开销会很高;可要是直接跳过某些步骤、或者拿历史结果顶替,缓存误差又会在迭代中越积越多,最后拖累画质。
所以视频推理加速的要害不在于少算几次,而在于分辨哪些计算能安全复用、什么时候必须重算来把误差压住。
是石科技用的是基于历史缓存残差的自适应加速技术:靠历史计算信息评估缓存复用的风险,再动态调整计算和刷新策略。
变化不大的计算部分,系统直接复用历史结果,省掉重复计算;误差风险高的关键部分,则触发重算和校准,让缓存误差少影响后面的生成。动态刷新加上误差校准,系统在砍计算开销的同时,尽量保住视频生成轨迹的一致性。
 △相同实验设置下,是石科技缓存复用方案相对Dense端到端加速的可视化样例
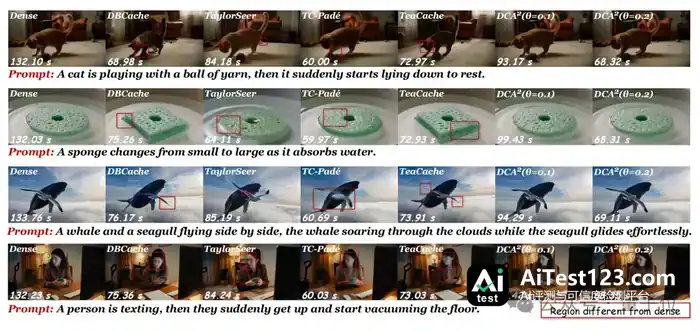
按发布方案给出的测试条件,对比Dense基线方案,这项技术做到端到端平均2.48倍加速,画质也保持住了。
换句话说,推理加速不必再靠砍生成步骤来实现,改用更细的计算复用策略,就能在效率和质量之间动态找平衡。
缓存与显存协同优化:让单位算力扛更多任务
视频生成的开销,一部分来自计算量,另一部分来自推理时的显存占用。
并发跑多个视频任务时,缓存数据怎么存、怎么读、怎么更新,都会左右显存的利用效率。哪怕单个任务已经跑得更快,只要缓存管理本身吃掉额外资源,整体能扛的任务量照样会被拖住。
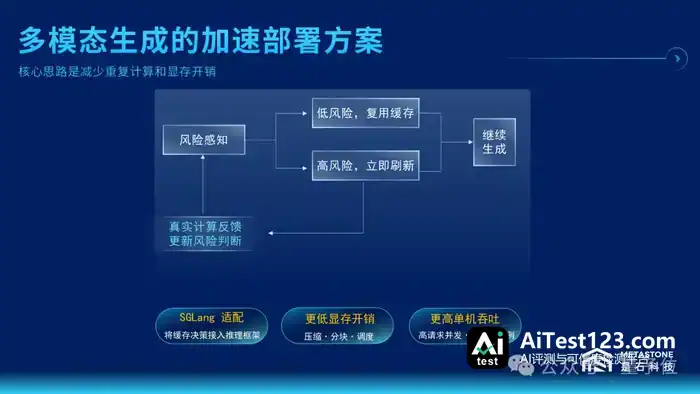
所以单任务加速和多任务资源利用得放在一起调。是石科技的做法,是把智能缓存决策接进SGLang推理框架,靠缓存复用、分块处理、压缩和智能调度这几套机制,把重复计算和不必要的显存开销压下去。
系统还加了风险感知机制,依据实际计算反馈动态调整缓存策略,复用效率往上走,误差风险同时被控制住。优化的范围也因此从一次推理的计算,扩到了资源管理这一层。
对企业级视频生产来说,生成速度、显存占用和任务并发能力三者共同决定算力资源的实际产出。冗余计算和缓存开销降下来,更高并发、更灵活的任务部署才有腾挪空间。
模态自适应Token压缩:压低音视频的理解开销
视频生成之外,多模态理解同样卡在计算效率上。视频和音频的时序信息密度比文本高得多,模型处理连续视频帧、声音片段这类输入时,得把它们转成大量Token,计算和存储负担随之增加。可不同模态、不同片段的信息密度并不一样:有的Token带着关键语义,有的冗余度很高。
所有Token一视同仁地处理,容易白算;直接统一压缩,又可能把影响理解结果的重要信息弄丢。
是石科技给出的方案,是模态自适应的免训练Token压缩方法,借助基于AudioCLIP的模态感知技术分辨不同模态里的有效信息,再据此决定Token保留多少、压缩多少。核心思路一句话:按模态特征和信息价值分配计算资源,而不是对全部输入等比例处理。
这个方法不用额外训练,靠减少冗余Token来降低多模态理解阶段的计算负担,关键语义信息则尽量保住。
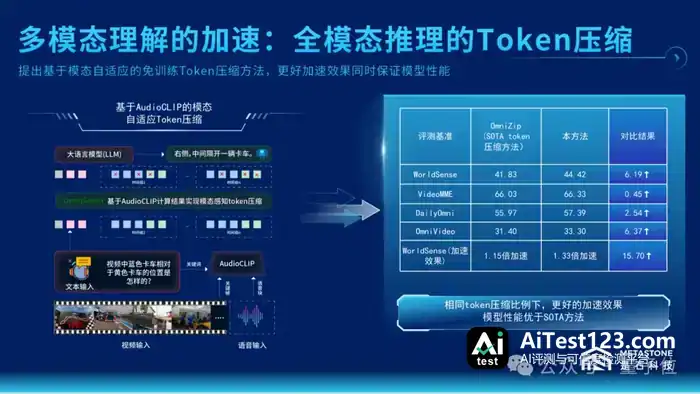
WorldSense评测里,该方法拿到1.33倍加速;VideoMME、DailyOmni等多个多模态理解基准测试中,性能表现同样不错。多模态推理优化由此从视频生成端延伸到素材理解端,处理复杂视听输入多了一条更高效的路径。
基于全模态模型的Context Engine解决方案
推理效率之外,多模态视频创作还有个问题:理解结果怎么进到生成流程里去。实际业务里的视频生成请求,往往人物图片、参考视频、音频、文字要求一起上。
这些输入形式各异,还夹着人物身份、动作、声音、镜头、时间顺序等约束。复杂素材和自然语言指令直接丢给生成模型,素材之间的关联和执行要求未必能表达得一致。
是石科技为此搭了基于全模态模型的Context Engine解决方案,在多模态理解与视频生成之间架起结构化的信息衔接机制。
系统先读懂输入素材和创作需求,把人物、声音及相关约束提取出来,再组织成含镜头、动作、对白等内容的结构化信息,交给后续视频生成模型执行。比如用户给了人物图片和参考音频,要求生成一段人物对白视频,系统得把人物信息、声音内容和镜头安排关联起来,而不只是吐出一段文字提示词。
素材绑定、结构化分镜、时轴校验、错误修正等机制一起作用,不同模态的信息在生成流程里能形成相对明确的对应关系。优化的重点,就是把复杂的多模态输入变成更清晰、可校验、可执行的生成上下文。
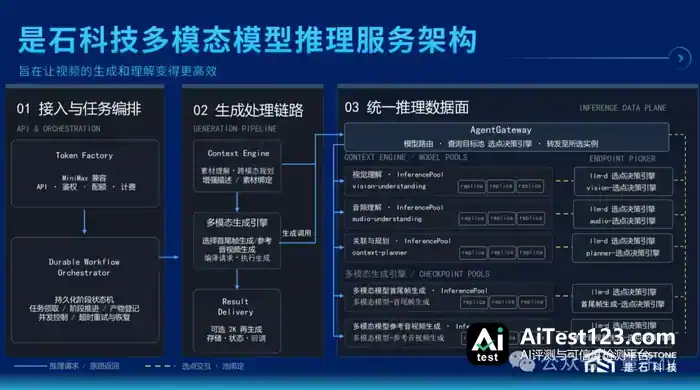
服务层面,是石科技进一步搭起覆盖API接入、任务编排、模型路由、推理执行与结果交付的多模态推理架构,并借任务状态管理、并发控制、超时重试与恢复机制,支撑实际业务中的任务运行和交付。
从模型推理效率到完整生产链路
多模态模型一旦进入生产环境,生成质量、推理时延、显存成本与任务稳定性这几项指标就不再各自为政。
视频生成这一端,要把冗余计算和误差累积压下去;多模态理解这一端,得减少无效Token的处理量;生成链路则要确保素材信息与创作约束能顺利传递到位。
是石科技此次发布的多模态模型服务,正是把这些优化能力放到同一条生产链路里通盘考虑。
自适应缓存加速、显存资源管理,加上模态感知Token压缩、基于全模态模型的Context Engine解决方案的结构化衔接,再到推理服务架构,优化对象一步步从单个模型的计算过程,延伸到多模态任务的执行与交付环节。
AI视频要规模化落地,关键并不在于把单次生成的等待时间压短,而是在算力资源既定的前提下,持续完成更多符合质量要求的生成任务。
从“能生成”迈向“好生产”,是石科技后续将围绕多模态推理效率、资源利用与服务稳定性持续做技术优化,为AI视频从模型能力走向实际生产提供基础支撑。
*本文系量子位获授权刊载,观点仅为原作者所有。