Qwen4-Max发布背后:AI数据这门矿生意,谁能挖到最后?
今天,阿里发布了 Qwen4-Max。发布材料所展示的,除了回答问题、生成文字,还有制作金融投研底稿、整理法律尽调材料、规划汽车产线。团队同时公布了Work360行业基准,评估模型完成复杂专业任务的能力。 这些演示仍需在真实场景中检验,但它们提出了一个共同问题:要让AI交付专业成果,该拿什么教它,又该如何判断它做得对不
阿里今天推出Qwen4-Max。发布材料里亮出的本事,不光是答题、写文章,还包括做金融投研底稿、梳理法律尽调材料、规划汽车产线。团队一并公布了Work360行业基准,用来评估模型完成复杂专业任务的水平。
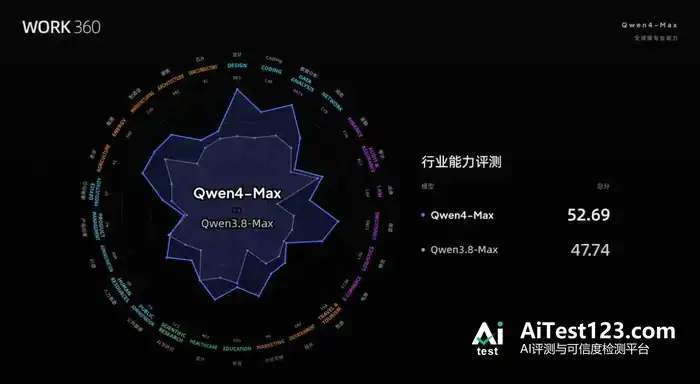
这些演示能不能经得住真实场景的检验,现在还不好说。但它们指向同一个问题:要让AI交出专业成果,该拿什么教它,又该怎么判断它干得对不对?
大洋彼岸的一笔买卖,给这个问题标出了具体价码。Google掏出1000万美元,竞购停飞航空公司Spirit留下的部分内部数据,涵盖邮件、聊天、文档以及部分软件。这家航空公司没能撑下去,可员工多年处理订单、协调业务、解决问题攒下的记录,却迎来了新买家。
这恰恰是AI学干活时缺的那块料。不过,买下邮件不等于买下经验:哪些记录能合法使用,怎样从中提炼出任务,如何判断模型做得对不对,每一环都得重新处理。
互联网是人类“读过的书”,Agent要学的,却是人类“做过的事”。
这几年,科技巨头砸下重金买GPU、建计算集群。如今,它们还得给机器找新的学习材料。算力投入看不到头,可光有更强的计算能力,已经答不了下一个问题:怎么让AI真正学会工作?
铲子之外,还得找矿
淘金热的故事,被拿去解释过的科技生意太多了。淘金的人未必发财,卖铲子、卖牛仔裤的反倒赚了钱。可铲子卖得再火,撑起这门生意的,终究还是矿里有金子可挖。
个人端着淘金盘碰运气的年月过去之后,手握矿权、资金和设备的大型矿业公司慢慢接过了这门生意。一百多年后,上世纪初成立的纽蒙特,已是全球最大的黄金生产商之一。2025年,公司净利润约72亿美元。淘金热总会退潮,金矿生意却能一直做下去。
眼下,英伟达已经证明了卖铲子能赚多少。AI数据公司(也就是专门给模型公司供应训练数据、训练任务和评测服务的第三方)盯上的,是模型训练离不开的矿源。
2020年,OpenAI发表Scaling Laws研究:参数、数据、算力同步放大,模型表现就会沿着一条可预测的曲线往上走。
这给AI产业带来了一种此前不多见的确定性——只要资金和计算资源够,就有机会朝着相对明确的方向把模型能力推上去,这就是AI时代的新矿脉。此后几年,英伟达靠着GPU、CUDA和配套软件生态,成了最重要的受益者之一。去年10月,英伟达成为首家市值触及5万亿美元的公司,也因此常被叫作AI时代的卖铲人。
可铲子能卖多久,说到底还得看金矿能挖多久。
2022年,DeepMind训练的Chinchilla只有700亿参数,吃了1.4万亿token,却打赢了2800亿参数的Gopher。这说明,GPU多,不代表训练效率一定高。数据量不够、配比不合理,一样会把昂贵的算力白白浪费掉。
Epoch AI在2024年估算,按当时的扩张趋势,模型训练可能在2026至2032年间把现有公开人类文本资源用尽。2024年底,Ilya Sutskever在NeurIPS上把数据称作AI的“化石燃料”,而互联网只有一个。
2026年的互联网,每天仍有新的网页、代码、视频和音频冒出来。模型可以反复使用已有数据,也能靠合成数据和新的训练方法继续往前走。但容易获取、质量够高、又能明显提升前沿模型能力的公开文本,不会永远按过去的速度增长。
中文语料这块更不好办。微信、抖音、小红书的账号体系各自封闭,好内容基本都沉在里面,爬虫根本进不去;要拿授权、做清洗、再整理成可用的数据,每一步都得另外砸钱。有行业人士提到,早些年为了攒够高质量文本,有人整批买回旧书,把装订拆开,一页一页扫。
萨顿比多数人看得更远。2019年,强化学习之父理查德·萨顿写下《苦涩的教训》,劝同行别再手工灌输人类知识,转而押注通用算力。2025年,他和DeepMind的大卫·席尔瓦合写《欢迎来到经验时代》:人类数据这口井快抽干了,下一阶段的智能,得从AI自己在环境里的行动与反馈中长出来。
o1和DeepSeek-R1先啃下数学与代码,是因为数学题有答案,代码能跑测试,模型在反复试错里拿分、涨分。Andrej Karpathy去年11月说得更直白:传统软件自动化的是能写出规则的事,神经网络自动化的则是能验证结果的事。
可经验不会凭空冒出来。
AI要反复练,先得有能操作的环境、明确的任务目标,还有判断结果好坏的标准。数学和代码相对好办,企业工作却很难整理成这种形式。
比如一名采购经理收到供应商的延期通知,得判断会不会影响生产计划、要不要换供应商、是否调整付款条件。同一份合同,法务、财务和销售部门的要求可能各不相同。
头部实验室正在补这个缺口。10月6日,OpenAI宣布GPT-6 Astra是“第一个用Ironclad任务训练的前沿模型”。合同管理软件公司Ironclad提供了产品的托管环境,合同审批、条款配置这类流程,被做成模型能反复练习、按评分标准打分的任务。
加工之后,这些数据就变成了模型可以反复练的任务、环境和评分标准。那接下来,谁来挖这座矿?路子有两条:模型公司自己动手,也就是“自建”;或者找第三方数据公司买,也就是“外采”。后一条路,正是这两年热起来的新行当。
数据公司怎么突然变得这么值钱?
用户点一下、停一会儿、下一单,推荐平台就能持续拿到训练反馈。刷一次抖音、搜一次百度,等于顺手替平台标好了兴趣,轮子自己就转起来了。推荐算法时代的字节,大概是最不依赖向外采买数据的公司。
可到了AI时代,这套打法不总灵了。一位办公Agent产品经理对《新立场》说,用户留下的任务记录数量不少,能真正拿去训练模型的却不多,“有的时候,几万条里才可能用到几条”。
越复杂的专业任务,越不是一次成功操作就能教会模型。中间做过哪些判断、哪里出过错、最后结果为什么对,这些它都得知道。
用户顺手留下的数据不够使,那就得掏钱请人来做。
2009年,斯坦福大学李飞飞团队发表ImageNet研究。要让计算机认出猫、狗、汽车这些物体,研究人员先从互联网收集图片,再通过Amazon Mechanical Turk等众包渠道雇人逐张核对、标注。项目前后动用近5万名众包工人,数据集后来扩到约1400万张图片。
那会儿是人告诉机器一张图里有什么。十几年过去,AI公司花钱请人干的事,变成了教机器怎么把一份工作做完。
以前互联网上的文章、图片和代码,足够提供大量训练材料。现在AI要学的是怎么完成专业工作。员工怎么处理例外、专家怎么下判断、任务做完怎么验收,这些内容很少完整地出现在公开网页上。
机器人是另一条战线。“纸上得来终觉浅”,互联网能教机器人看图说话,教不会它拧一颗螺丝。物体处于什么状态、动作按什么顺序、操作结果如何、失败之后怎么重来,这些材料很难像普通网页那样成批获取。
需求摆在那儿,钱也就花出去了。
美国专家数据平台Mercor帮AI实验室对接各行业专业人士,承接训练和评测任务。它曾花超过50万美元,请来出身高盛、摩根大通、麦肯锡的专业人士做了200道任务,平均每道超过2500美元。
同在加州的Surge AI主要给头部模型实验室供应高质量人工标注和评测数据,手下养着数百人规模的专家顾问团。据报道,需求最旺时,一些模型厂在编程数据上一天的投入就能超过1000万美元。
不过这门生意眼下没有统一的计价单位,价差极大。
给一张图片做分类,或者标一段文本,报酬只有几美分;可要是数学家给AI抛出一道难题,价格就能到数千美元。Mercor在招放射科医生,开出的时薪是200到400美元,肿瘤学专家部分能拿到450美元。还有一家破产航空公司,它的邮件和聊天记录被叫价1000万美元。
数据的价格千差万别,做数据生意的公司,身价却在普遍上涨。
国内做专家数据的平台Humanlaya,手上聚了10万多名专家,横跨各个行业和学科。鼎晖、红杉中国、今日资本今年都投了它,估值接近10亿美元。另一家做评测与合成数据的UniPat,成立还不到一年,估值已到二三十亿美元。
海外的例子更极端。去年6月,Meta以约143亿美元取得 Scale AI 49%的股权。Scale成立于2016年,是美国最大的数据标注公司之一,最早做自动驾驶图像标注,后来成为头部模型公司的重要数据供应商。
资本肯出这个价,除了前面说的需求变化,还有一个原因:模型要学的东西变了。
眼下各家在技术路线、数据处理和质量上越来越难拉开明显差距,模型发布节奏又很快。谁能拿到别人没有的训练材料,无疑就多了一点优势。
数据越来越贵,卖数据却未必是门好生意
搜索和推荐的年代,数据是流量的副产品,多半挂在中台之下。现在,越来越多公司开始让模型负责人直接参与数据决策。
7月到9月,国内几家大厂的数据负责人接连调整。7月,小红书从DeepSeek挖来早期核心成员陈官厅,出任预训练数据负责人。8月,字节把AI数据升格为与Seed、Flow、抖音平行的一级部门,统管寻源、评测与交付,Seed内部另设Pretrain Data部门。
9月23日的云栖大会上,阿里把训练数据、专家生态、评测、具身数据四位负责人推到台前,并宣布“认知原点计划”在医学、先进制造、金融合规三个方向开放1万个专家协同席位。到了9月28日,腾讯首席AI科学家姚顺雨又兼起AI Data部负责人,模型、基础设施、数据三个部门,就此归到一个人手上。
2025年,姚顺雨写过一篇《The Second Half》。文章的中心意思是:强化学习的配方越来越成熟,进入下半场后,真正拉开差距的是怎么定义任务、怎么搭建环境、怎么设计评测。
DeepSeek 则走向另一个方向。据《晚点》报道,梁文锋曾安排一半核心研究员亲身投入数据清洗、合成和标注。他算过:模型结构若差一倍,数据效率再差一倍,叠加起来就要多花 4 倍算力。
智谱同样把数据生产纳入内部流程。2024 年,智谱已在海外组建数据采购团队,内部由张笑涵牵头搭建标注平台“狂标”。语言模型和多模态模型团队轮训时,待训团队也要参与标注。每次模型发布之前,还要过两道关:AI 院测通用能力,交付团队按真实客户场景做测评。
字节选择自研。7 月底的 Seed 全员会上,张一鸣明确表示不蒸馏竞争对手的模型,要走自研到底的路。不靠蒸馏对手的输出,就意味着 Seed 得更多依赖自身研发、真实任务和数据生产体系来攒能力。
不过,自研不等于不买。
字节一边坚持自研,一边也是外采的大买家:世界模型、影视母带、编程数据、专家网络是几条主要外采方向。有数据供应商透露,字节在世界模型数据上的投入达到同行的 3 到 4 倍。
大厂外采的对象正是第三方数据公司。按提供的数据类型,大致能分成三类:传统训练数据服务商、专家与专业任务数据公司、具身数据公司。
先看传统训练数据服务商。这类公司从语音、图像、文本标注等业务起步,客户面较广。海天瑞声成立于 2005 年,长期做语音、视觉和自然语言等 AI 训练数据服务。2026 年上半年,公司营业收入 1.92 亿元,同比增长 22.45%。它披露的客户和合作伙伴有阿里、腾讯、百度、字节,也包括海外多家大型科技公司。
再看专家与专业任务数据公司。前文提到的 Mercor、Surge AI 都归此类,它们不只做标注,还组织各行业专家,产出模型练习专业工作所需的业务资料、操作步骤、任务环境和评分标准。比如训练模型做投资分析,供应商不光要交最终报告,还得请专家备好原始业务资料、参考操作步骤,以及评价结果的评分清单。
第三类是具身数据公司,面向机器人训练,采集人和设备在真实环境中的操作数据。今年 2 月才成立的觅蜂科技由国内人形机器人公司智元孵化,6 月量产一种穿戴式无本体数据采集设备,8 月 31 日第 20000 套下线,交到京东手里。问题是,这些数据没法像网页那样自动抓取。机器人要学一个动作,往往得靠人和设备在现场一遍遍演示、采集。
但在《新立场》看来,价格高、估值高,不代表这门生意就好做。
第三方数据公司的难处,恰恰来自“自建”与“外采”两条路同时存在。模型公司一旦自己生产数据、设计任务、搭建评测环境,外部数据公司的生意就会遇到新考验。大客户既是收入来源,也可能变成竞争对手。
大厂自己造数据,外部供应商的订单可能被挤压。可跟某家大厂走得太近,同样有风险。去年 6 月,Meta 以约 143 亿美元取得 Scale AI 49% 的股权。据报道,Google 等大客户随后调整了与 Scale 的合作,Google 原本计划当年向其支付约 2 亿美元。即便没有实际的数据泄露,当一家服务多家竞争对手的供应商与其中一家建立深度资本关系,其他客户也不得不重新掂量合作风险。
数据公司既要防着客户自己造数据,又得避免绑死一个客户而丢掉其他客户。很多标注任务、合成数据和自动评分工具,模型公司自己就能建。一家外部供应商如果只按客户要求组织专家、交付数据,生意做得再大,也可能只是一家更高级的人力外包公司。
真正该砸钱的地方,其实是那套能在不同客户之间反复用的生产体系。专业任务怎么设计、训练环境怎么反复跑、评分工具怎么验证过、专家网络怎么长期攒——这些不必每接一单就重新搭一遍。能力沉下来了,数据公司才有可能不再是做一单算一单的交付方,而变成模型公司离不开的基础设施。
写在最后
洛克菲勒就没在油井上取胜。1870 年创办标准石油时,宾夕法尼亚的油井主们正在暴富和破产之间来回打转,原油价格大起大落。他押的是炼油和运输,靠规模压低成本,靠铁路运价折扣压垮对手,十年后控制了美国约九成的炼油能力。钻井的人来了又走,标准石油拿走的,是把原油变成产品的那一环。
数据卖得贵,也未必是好生意。客户可能自己生产,独家授权会限制复用,一批昂贵任务也可能很快不再稀缺。
数据有保质期,买家自己也能造,偏偏买主还高度集中:Mercor 上半年 6.14 亿美元收入里,约 91% 来自基础模型公司。Meta 拿下 Scale 近半股权,据报道大客户跟着走了。一口井的中立性,就这么在一纸交易公告里没了。
这也是数据产业很难照搬英伟达的原因。
英伟达的优势不只在 GPU,也在 CUDA 和它的开发者生态。2007 年 CUDA 发布时,GPU 还是用来打游戏的;2012 年 AlexNet 用两块游戏显卡训练出来,这套软件才等到自己成为行业标准的时刻。此后十几年,一代代开发者都在 CUDA 上写代码,换掉它的代价越来越高。
数据时代的 CUDA 不是一堆文件,而是一套由任务、环境、评分标准撑起来的验证体系:能重来,能反复试,能自动给分。行业知识要有,环境工程、质量控制、独立评测也一样不能少。自动评分能把规模铺开,可评分本身照样得被人检验。
能拿走训练数据的人很多,能决定“什么才算做对了”的人很少。
*题图及文中配图来源于网络。