阿里发布Qwen4-Max:2.4T参数,编程盲测全球第六

资讯 量子位 全文 2183 字 · 约 6 分钟读完 配图 2 张 分类阿里模型发布AI 编程智能体

11月16日,阿里巴巴发布全新一代基座大模型Qwen4-Max

所属频道 大厂动态模型发布智能体与 AgentAI 编程与开发

11月16日,阿里巴巴推出新一代基座大模型Qwen4-Max,总参数2.4T,原生支持视觉,上下文可达百万级。依靠新架构和训练优化,这款模型用更少的Token换来更高性能,智能体与编程能力继续走强:在全球前端编程盲测CodeArena中排到第六;在Agents’ Last Exam(ALE)、Vals Index等智能体能力和专业任务第三方评测里,Qwen4都处在领先梯队。该模型针对全领域真实任务做了深度优化,能更顺手地调用专业工具处理长周期任务,推动AI在汽车制造、游戏开发、金融投研及科学研究等专业领域落地。

Qwen4-Max已在千问AI平台上线,对外提供API服务,缓存命中价格每百万Tokens低至0.5元,完成单任务的平均花费比上代模型降了6成;用户也能通过阿里Token Plan调用新模型,或者直接在千问办公、Qoder、千问APP等应用里体验。据了解,Qwen4系列的中小尺寸模型后续将陆续开源。
阿里发布Qwen4-Max:2.4T参数,编程盲测全球第六(配图 1)

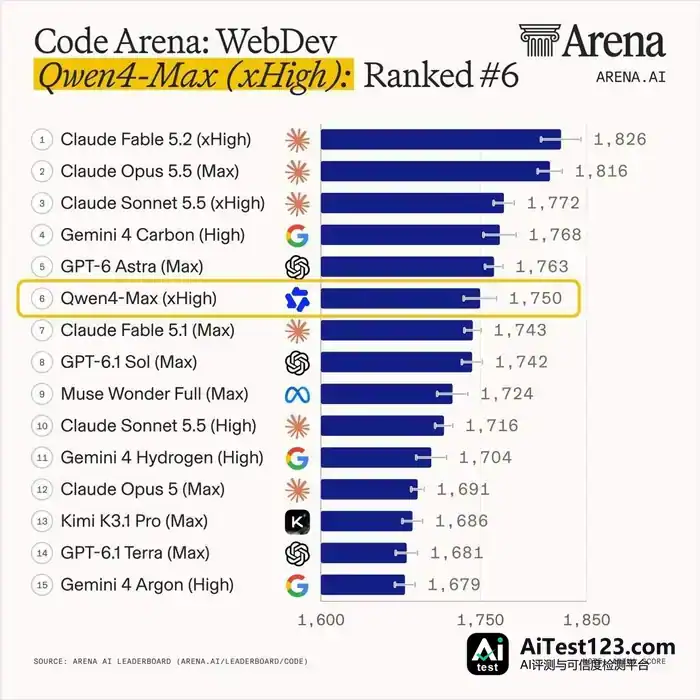
图说:CodeArena前端编程全球榜上,Qwen4-Max位列第6

Qwen4-Max用的是基于Qwen稀疏注意力(QSA)的新MoE架构,2.4T总参数只激活71B,每个Token激活的参数比上代少25%,思考效率也更高:Terminal-Bench 4.0专业编程评测中,同样处在Xhigh思考档位,Qwen4-Max每次尝试的平均Token用量从Qwen3.8-Max的289K降到151K,少了近50%,得分则从38.9分升到48.5分,提高近25%。缓存命中价格大幅下降之后,评测结果显示,Qwen4-Max完成单个任务的平均费用(Cost per Task)比Qwen3.8-Max低58%。

新架构加上高效的训练优化,让Qwen4-Max的性能整体上了一个台阶。聚焦编程的CodeArena全球盲测权威榜单里,Qwen4-Max前端(Webdev)排全球第6,夹在GPT6-Astra和Claude Fable5.1之间,刷新了中国模型的最好成绩;在“智能体最后的考试”Agents’ Last Exam(ALE)中拿到46.7的最高分,比Qwen3.8-Max高出18.8分;评估大模型理解专业图表与推理能力的Chartography评测中,Qwen4-Max得54.2分,比上代提升12.2分;专业工作评测JobBench中,新模型得分68.5,超过GPT-6.1sol,次于Claude Opus5.5;专注法律专业的HLAB-Vals-1.1上,Qwen4-Max得21.3分,较Qwen3.8-Max进步5.9分,进入行业领先模型行列。

日常的简单需求也好,长周期的复杂任务也好,Qwen4都能可靠交付,人机协作更顺畅。Qwen4-Max在模型内实现了持续交付(Live Delivery)机制,先给出一个能用的首版,再按用户意见一版版扩展内容直到完成:面对一个物理课堂科普网站的设计需求,Qwen4-Max交付了14次可用版本,最终扩成一个含3D动画、交互实验和原理详解的精致网站。它还能围绕复杂目标与约束做运筹建模、求解与验证,自主规划、持续迭代,编排智能体处理更复杂的任务:基于阿里云AI基础设施,Qwen4-Max自主闭环优化了支撑自身应用、推理与训练的运行系统,数据标注场景中把模型成本费用压低10%,CPU离线重调度场景的最优求解速度提升超14倍。
阿里发布Qwen4-Max:2.4T参数,编程盲测全球第六(配图 2)

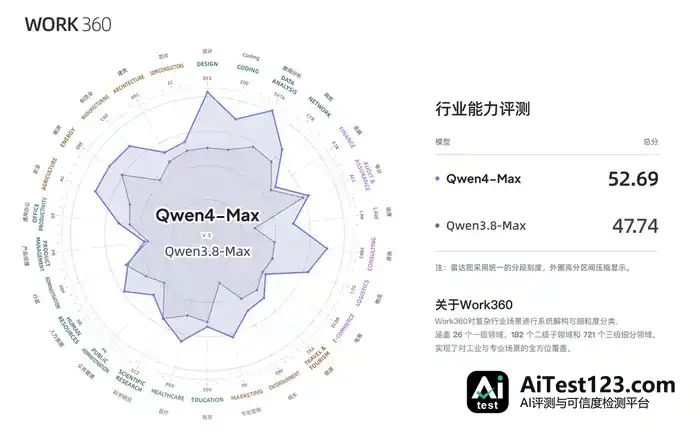
图说:面向全场景721个方向的真实工作领域,Qwen4较上代模型整体提升超10%的专业能力

从专业协作(Cowork)到全天候智能体,Qwen4正走进更多真实工作任务和生产环境。千问团队搭建了覆盖721个细分领域的Work360全场景建模体系,系统评测中Qwen4-Max得分52.69,比上一代模型提升超10%。游戏开发等专业设计领域,Qwen4的3D建模能力很强,调用Blender等专业工具也更熟练,一句话就能生成一个好玩的3D游戏。汽车制造行业里,Qwen4已贯穿产线规划、零件设计与加工验证全流程,单个工件加工编程的人工用时从475分钟降到24分钟,减少95%;金融投研场景中,Qwen4熟练调用90个MCP专业工具,产出Excel底稿与PPT报告,并支持双重溯源保证结论可靠。

AI辅助科学发现(AI For Science)的前沿领域,Qwen4已初步拿出材料和药物发现的真实成果。材料发现方面,Qwen4连续48小时自主运行,从270万个候选分子中挑出候选分子,经过4轮“设计—合成—测试”闭环,真实合成出一种新型冷却液材料,为缓解高功率芯片带来的数据中心散热难题提供了新思路;药物发现方面,针对阿尔兹海默症关键靶点,Qwen4完成454次工具调用、3239项计算评估,设计优化了24个候选分子,最终优选分子与靶点的名义结合亲和力比起点分子提升约3.6倍,是更有效的新选择。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 阿里Qwen4-Max发布:总参数2.4T,单任务平均费用降六成

    新京报贝壳财经讯(记者罗亦丹)11月16日,阿里巴巴发布全新一代基座大模型Qwen4-Max,总参数2.4T,具备原生视觉能力,支持百万上下文。基于创新的模型架构和训练优化,Qwen4-Max以更少的Token消耗实现了更高的性能,在智能体和编程等关键能力项上持续进化:在权威的全球前端编程盲测CodeArena中,Qw

    来源 腾讯网
  2. 阿里正式发布Qwen4,智能体及编程能力进阶

    36氪获悉,阿里巴巴发布全新一代基座大模型Qwen4-Max,总参数2.4T,具备原生视觉能力,支持百万上下文。基于创新的模型架构和训练优化,Qwen4-Max以更少的Token消耗实现了更高的性能,在智能体和编程等关键能力项上持续进化。Qwen4面向全领域的真实任务深度优化,可更好地调用专业工具处理长周期任务。Qwe

    来源 AI 行业观察
  3. Agent如何越用越强?中科院自动化所、美团等推出RSI综述

    从 Prompt 优化到 Harness 进化,梳理 RSI 的发展趋势,用三个问题、七步生命周期,理解 Agent 如何把经验转化为持续改进。想象这样一个场景:一个编程 Agent 调用 API 时遇到报错,发现接口参数已经更新。经过几轮尝试,它终于修复了问题。但到了下一个任务,它还会不会犯同样的错误?这次修复能否沉

    来源 腾讯网
  4. Deepnote实测12款AI当同事:OpenAI包揽前二,Fable 5.2贵17倍反输

    花430倍的钱,只多11%的分数! 太夸张了。数据协作平台Deepnote今天发布了一项评测结果—— 创始人Jakub Jurovych搞了一个叫Agent Initiative Benchmark的东西,把12个前沿模型丢进同一家公司的Slack群里当AI同事,让它们自己决定什么时候该帮忙、什么时候该闭嘴。 跑完一看

    来源 AI 行业观察
  5. 阿里Qwen4-Max正式版发布:MoE架构,原生支持视觉理解

    IT之家 11 月 16 日消息,阿里通义千问团队推出新一代旗舰模型 Qwen4-Max,采用全新的 MoE(混合专家)架构,原生支持视觉理解,并提供 100 万 Token 上下文窗口。 官方称,新模型在提升复杂工作任务处理能力的同时,能够减少 Token 消耗并降低任务成本。 IT之家正在更新。

    来源 AI 行业观察
  6. 腾讯发布Hy4 flash:支持1M上下文,激活参数12B

    11月16日,腾讯发布定位于日常办公及智能体任务的Hy4 flash模型。该模型总参数量224B(含64B Engram参数),单次激活参数12B,支持多模态输入和最高1M上下文长度,解码速度超过150 tokens/s。腾讯内部评测显示其综合表现略高于Hy4 preview,WorkIndex测试中平均单任务成本约为

    来源 凤凰科技
  7. 硅谷巨头与国内大厂争相布局个人智能体:竞争逻辑生变

    不知道你最近有没有一种强烈的感觉:AI行业打架的姿势,悄悄变了。 过去两年多,大家打开任何一家大厂的发布会,满屏都是熟悉的名词:MMLU跑分又涨了两个点、数学竞赛金牌水准、支持100万上下文、代码生成速度翻倍。 但到了最近这几个月,战火突然烧到了一个新词上——Personal Agent(个人智能体)。 Meta在 2

    来源 AI 行业观察
  8. MIT韩松团队PEAR:27B模型纯仿真训练,单卡就能驱动真机?

    MIT韩松团队发布PEAR项目,基于Qwen3.8-27B模型,仅通过仿真环境强化学习,无需真实数据即可驱动双臂机器人。在RTX 5090上推理速度超220 tok/s,真机测试成功率60%,且完整保留数学编程等通用能力,为具身智能提供了一条低成本、高泛化的新路径。

    来源 AI 应用前沿
  9. 谷歌Gemini 4 Hydrogen发布:定价低于Argon,AA指数反超

    谷歌DeepMind于2026年11月12日发布Gemini 4 Hydrogen,定价$1.50/$7.50(百万token),在Artificial Analysis智能指数上以51分(默认高档)和54分(最高档)超越同系Argon的50分,同时面向所有用户免费开放。模型主打代码执行与agentic工作流,配套推出

    来源 AI 科技快讯
  10. 腾讯混元发布Hy Realtime:能唱歌,还能自己联网搜

    腾讯混元今日发文宣布,全新实时语音模型 Hy Realtime 正式发布。作为一款主打实时的语音模型,它在语音理解、指令遵循与拟人化表达等基础对话能力上表现优异,更一口气补齐两项新本领:一是 Agentic 工具调用,二是唱歌。换言之,它不再是单纯应答的"嘴",而开始长了能干活的手,离"像人一样交流"又近了一步。 Hy

    来源 AI 开发者社区
  11. 智能体安全新课题:风险如何跨会话潜伏与放大?

    大模型正从聊天助手进化为能自主调用工具、读写文件的通用智能体。这意味着安全风险不再局限于“说了什么”,而是延伸至“做了什么”以及“留下了什么”。北大与腾讯联合发布的综述指出,攻击者可通过污染技能、记忆或环境,让风险跨会话潜伏并放大。传统组件式防御已失效,必须建立涵盖来源、编排、执行及持久反馈的全生命周期安全框架,并在运

    来源 AI 应用前沿
  12. 腾讯混元Hy4 flash发布:224B参数,张军称性价比最高

    【TechWeb】11月16日消息,今日,腾讯混元最新语言模型Hy4 flash正式发布。腾讯公司公关总监张军在社交平台发文称,“这是迄今为止性价比最高的混元模型。”混元Hy4 flash每百万Token输入0.5元、输出2元,命中缓存时仅需0.02元,价格相比Hy4大幅降低。该模型总参数量为224B(其中64B En

    来源 腾讯网
  13. 高德推云控红绿灯:按车流调配时,北京近百路口平均提速19%

    【TechWeb】11月16日消息,今日,阿里巴巴集团旗下高德正式发布“云控红绿灯”系统,可让红绿灯根据车流调整配时,减少路口红灯等待。 红绿灯配时,通俗来说,就是决定一个路口各个方向什么时候放行、每次放行多久。 以往,许多路口主要依靠预设方案控制红绿灯。当早晚高峰车流激增,某个方向突然排起长队时,原有方案未必能及时响

    来源 AI 行业观察
  14. 华为云上线openPangu-2.1-Pro:Agent、代码与推理效率同步升级

    【TechWeb】11月16日消息,据华为云官微消息,华为云MaaS模型即服务平台正式上线开源盘古模型openPangu-2.1-Pro。相比上一代,新模型在Agent能力、代码能力和推理效率三个方向上做了系统性升级,在深度研究、鸿蒙系统操控、鸿蒙APP开发、昇腾算子生成及推理链路优化等场景实现增强。 Agent能力的

    来源 AI 行业观察
  15. MiniMax,狂卷字节、OpenAI

    (本文作者为 AIX财经,钛媒体经授权发布)文 | AIX财经,作者 | 雷晶,编辑 | 魏佳AI生图赛道,最近打得火热。11月10日晚,MiniMax发布并开放H3-Image模型权重,打出了“又快又便宜”的牌。官方称,它10秒就能生成一张1600万像素的高清图片,价格只有同档位主流工具的50%-70%。在它之前,O

    来源 腾讯网
  16. CataX AI完成4000万元种子轮融资,启明创投孵化并独家投资

    【TechWeb】11月16日消息,近日,上海凯思达生物医药科技有限公司(下称CataX AI)宣布完成4000万元人民币种子轮融资,由启明创投孵化并独家投资。 CataX AI创立于上海,是一家智能体(Agent)原生的创新药研发公司。CataX AI聚焦临床开发端,以智能体为技术底座,并由此构建“Clinical-

    来源 AI 行业观察
  17. 华为云上线盘古2.1-Pro:Agent、代码、推理效率升级

    据华为云官微消息,华为云MaaS模型即服务平台正式上线开源盘古模型openPangu-2.1-Pro。相比上一代,新模型在Agent能力、代码能力和推理效率三个方向上做了系统性升级,在深度研究、鸿蒙系统操控、鸿蒙APP开发、昇腾算子生成及推理链路优化等场景实现增强。

    来源 TechWeb
  18. 百度词元所上线首日:入驻供应商破100家,新增客户超1000家

    11月14日,从百度获悉,百度词元所发布首日,新增申请入驻的供应商已超过100家,新增超过1000家客户接入。 词元所在11月12日举行的百度世界2026上正式发布,百度创始人李彦宏将其称为“大模型的交易所”。据介绍,词元所一端汇聚模型和模型提供商,另一端服务企业和个人,让用户便捷地找到、购买和使用可信的模型Token

    来源 AI 行业观察
  19. DeepSeek开放全家桶应用API:开发者可复刻完整App体验

    【TechWeb】11月14日消息,DeepSeek发布全家桶应用 API,将其自有App中已经打磨成熟的整套交互能力打包为标准化、可调用的模块,向开发者开放。与以往仅提供模型推理接口不同,此次开放覆盖搜索、网页抓取与解析、文件解析、OCR、语音识别(ASR)、语音合成(TTS)等多项应用层能力,并支持开发者单独调用或

    来源 AI 行业观察
向下滚动自动加载更多