MIT韩松团队PEAR:27B模型纯仿真训练,单卡就能驱动真机?

资讯 AI 应用前沿 全文 2630 字 · 约 7 分钟读完 配图 12 张 分类RTXQwen3.8-27BQwen3模型发布机器人AI 编程

MIT韩松团队发布PEAR项目,基于Qwen3.8-27B模型,仅通过仿真环境强化学习,无需真实数据即可驱动双臂机器人。在RTX 5090上推理速度超220 tok/s,真机测试成功率60%,且完整保留数学编程等通用能力,为具身智能提供了一条低成本、高泛化的新路径。

所属频道 模型发布算力与芯片机器人与具身智能AI 编程与开发

不必再花大价钱做遥操作,像用电脑一样教机器人干活就行。

具身智能圈近来有个挺有意思的现象:一边是“通用大模型能搞定一切”的口号,另一边却是高昂的推理成本和延迟把人劝退。把GPT-4o或者Astra这种巨无霸塞进机器人身体里,贵不说,反应还慢,端侧算力根本扛不住。
图片

MIT韩松团队新近发布的PEAR(Post-training Engine for Agentic Robotics)项目,给出了另一种解法。他们没有去卷更大的模型,也没有收集海量真人遥操数据,而是把270亿参数的开源模型Qwen3.8-27B丢进仿真环境里练强化学习。结果有点出人意料:这个模型不光学会了操控真实的双臂机器人,还能在一张消费级显卡上跑出实时速度。
图片

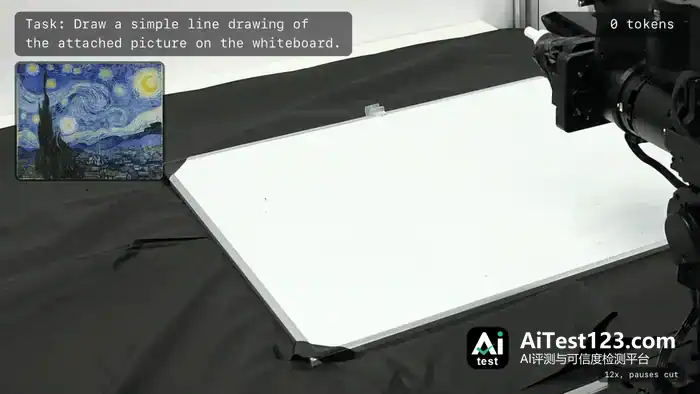
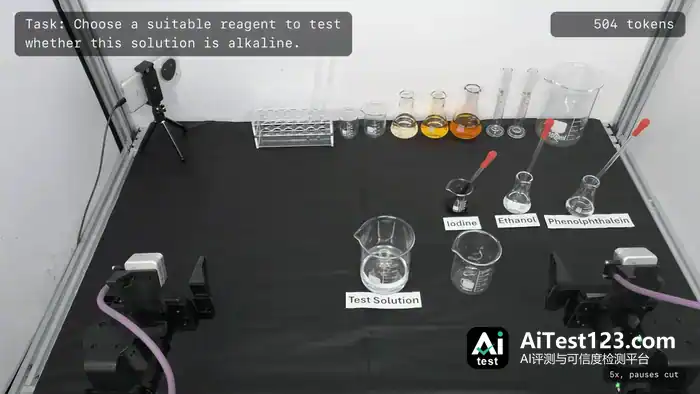
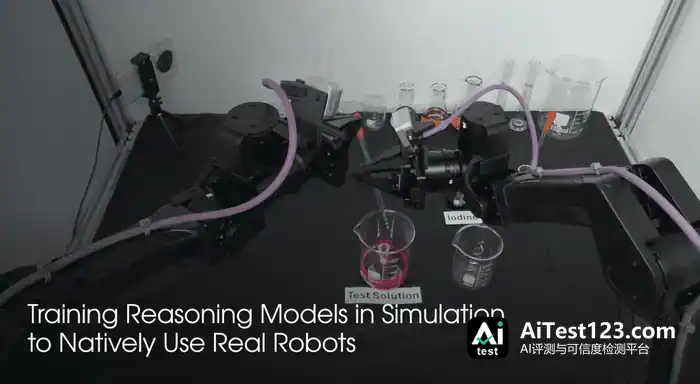
两个实机演示就能看出它在干什么。给它看一张梵高的《星空》,它能拿着夹爪在白板上画出线稿;桌上摆着碘水、酚酞和乙醇,问它怎么验证碱性,它会拿起酚酞滴进去,看着溶液变粉。整个过程既没有预设的技能库,也没有专门的感知模块,全靠模型自己“看”和“想”。
图片

核心逻辑:Robot-Use RL

图片

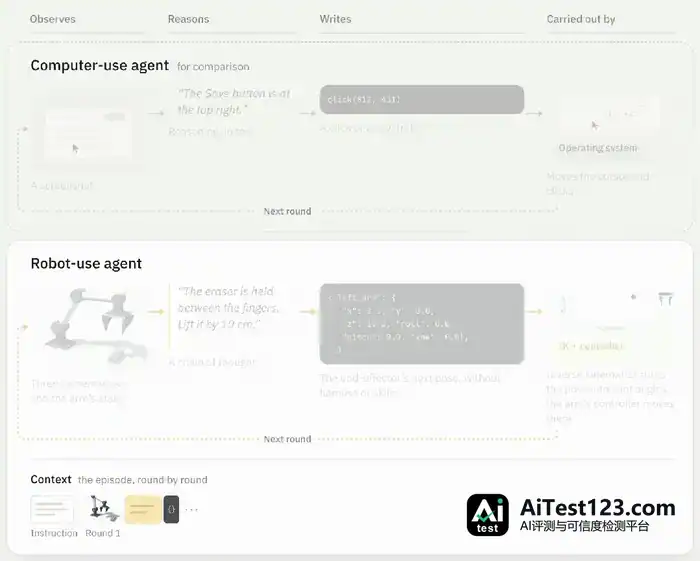
PEAR的思路很直白:操作机械臂,说到底跟操作电脑是一回事,只不过从二维屏幕换成了三维空间。
图片

如今的多模态模型已经学会“Computer Use”:看到截图,思维链里分析出“保存按钮在右上角”,再输出点击坐标(812, 431),由操作系统执行点击。PEAR把这套逻辑搬到了机器人身上。
图片

每一轮交互中,模型会收到三路摄像头画面和机械臂当前的关节状态。它在思维链里推理:“夹爪现在在橡皮正上方,需要把手指降到橡皮两侧。”随后输出一段JSON格式的数据,里面是末端执行器下一个目标位姿的六个自由度(x, y, z, roll, pitch, yaw)。底层的逆运动学算法算出关节角度,控制器再驱动机械臂动起来。动作完成后,新画面回传给模型,进入下一轮决策。
图片

这套流程叫Robot-Use RL。从头到尾,模型既不需要知道什么是“抓取规划器”,也不需要预先定义“拿起杯子”这类技能原子。定位物体、规划路径、修正偏差,全由模型根据视觉输入即时生成。好比一个刚学会用鼠标的人,不用背下所有软件的快捷键,只要看得懂界面,就能点点点点把活干完。
图片

泛化能力:是模仿还是推理?

图片

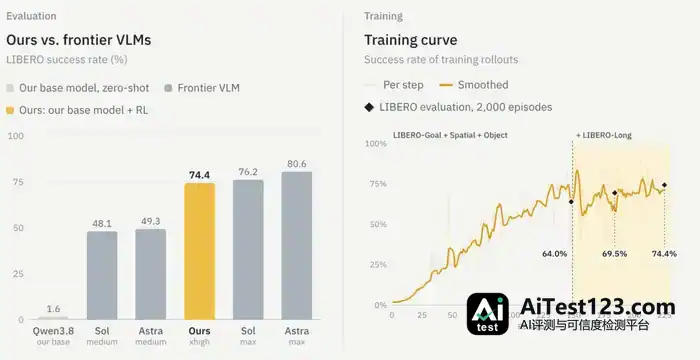
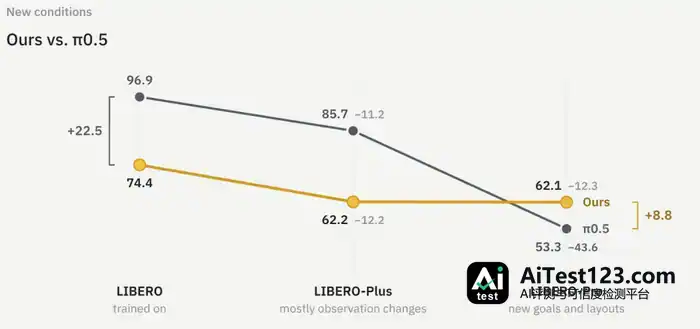
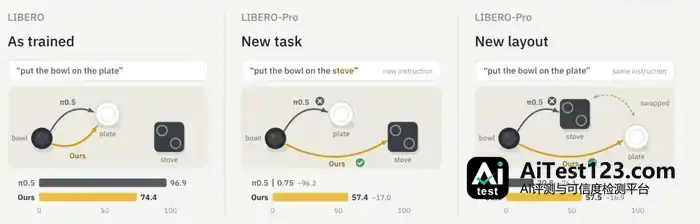
在机器人评测基准LIBERO上,PEAR的表现很有说服力。经过强化学习训练,它在LIBERO上的成功率从基座模型的1.6%飙升到74.4%。专门针对LIBERO训练过的π0.5模型(96.9%)虽然仍占上风,但真正的考验在于“换题”。
图片

研究者引入了两个扰动版本:LIBERO-Plus(改变光照、背景、相机角度)和LIBERO-Pro(改变任务目标和物体布局)。结果揭示了两种模型的本质区别。
图片

任务指令从“把碗放到盘子上”改成“把碗放到炉灶上”,或者物体位置对调之后,π0.5的成绩断崖式下跌,跌幅超过75分。原因在于π0.5更多是在“模仿”训练数据里见过的运动轨迹,场景一变,记忆失效,它就不知所措了。

相比之下,PEAR的跌幅只有17分左右。它对指令的理解能力和视觉感知能力都保留了下来,强化学习教给它的是如何根据当前画面和指令重新推理出合适的位姿。一个靠背题,一个靠解题。放到开放世界的真实环境里,这种推理能力比单纯的肌肉记忆更要紧。

纯仿真训练,真机零样本迁移

PEAR最让人惊讶的是训练数据:全部来自仿真,没碰过任何真实机器人数据。

研究者从三个维度测试了它的迁移能力:

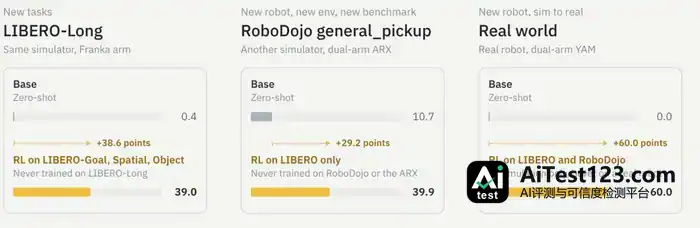
  1. 新任务:在LIBERO的部分子集上训练后,直接拿到未见过的长程任务LIBERO-Long上测试,成功率从0.4%跳到39.0%。
  2. 新环境:换到完全不同的仿真器RoboDojo中,机械臂型号从单臂Franka换成双臂ARX,PEAR依然拿到39.9%的成功率,远超基座模型。
  3. 新基准:在RoboLab-120评测中,PEAR取得37.3%的成绩,与NVIDIA的Cosmos3-Nano-Policy持平,高于π0.5和DreamZero。

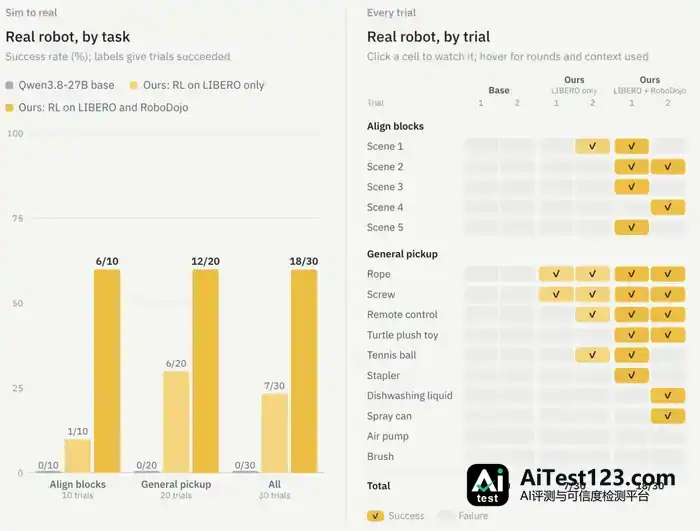
测试里最见真章的一环,是把模型搬到真机上跑。研究者拿一台此前完全没接触过的双臂YAM真机做部署,机器人的物理特性、传感器噪声,连桌面的摩擦力,模型都是头一回遇上。

30次真实测试涵盖摆放积木和抓取绳子、螺丝、毛绒乌龟等10种不同物体,PEAR成功了18次,成功率60%。作为对比,未经RL训练的基座模型成功率是0。也就是说,仅仅靠在仿真环境里的“脑补”练习,模型就已经能在真实物理世界里动手了。

性能与通用性:鱼和熊掌兼得

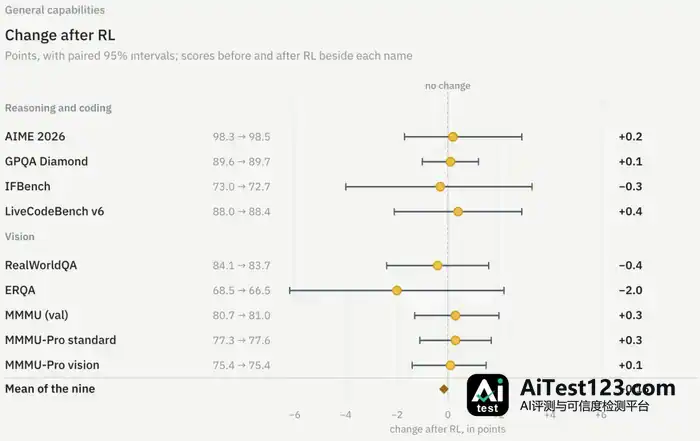
不少人担心,为机器人任务微调模型会牺牲它原本的数学、编程或逻辑推理能力。PEAR的数据打消了这个顾虑。

在AIME 2026数学竞赛、GPQA Diamond科学知识测试和LiveCodeBench代码能力测试里,PEAR拿到的分数跟基座模型差不太多。视觉类基准上,差距同样没超过2分。换句话说,强化学习添上的只是一套“手脚协调”的本事,模型原本的“大脑”结构没被动过。

现在同一个模型既能写代码、解数学题、读图表,也能上手操控机械臂叠积木。这种一专多能,对将来的通用机器人来说很关键。

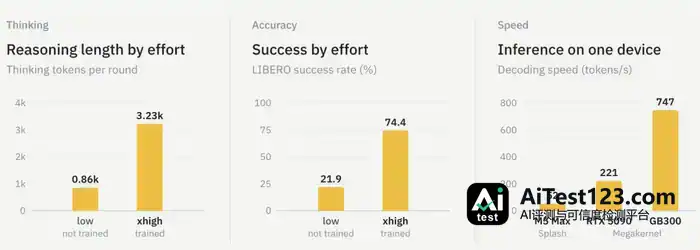
推理速度也是不少人盯着的地方,PEAR优化之后交出的成绩不差。靠NVFP4权重量化加上Inco AI的DFlash2 drafter技术,单张RTX 5090显卡上能跑到221 tok/s;换成更高端的GB300,速度直接升到747 tok/s。

拿RTX 5090来说,模型每做一个动作前想一下的时间能压到几百毫秒,大多数桌面操作任务对实时性的要求都够用了。把思考量调低(low档),成功率会掉一些,换来的是更快的反应,用户可以按任务难易自己拿捏这份“努力程度”。

结语

PEAR这一出现,等于给具身智能行业泼了盆冷水,同时又点了一盏灯。

冷水泼向的是那类看法:认定只有千亿参数模型配上海量真机数据才能把机器人做好,信的是“大力出奇迹”。灯照亮的路子更省钱也更走得通——拿现成的强大开源基础模型,搭上高效的仿真强化学习,不用砸钱买昂贵硬件、也不用搭复杂的工程管线,机器人就能练出能用的操作本事。

60%的真机成功率离真正商业化还有一段路,应付更复杂的非结构化环境依旧是难题。但一个27B参数的小模型,在一张消费级显卡上像人那样一边想一边动手,这种可能性已经摆在眼前。这条路,说不定比大家想的要宽。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 阿里Qwen4-Max发布:总参数2.4T,单任务平均费用降六成

    新京报贝壳财经讯(记者罗亦丹)11月16日,阿里巴巴发布全新一代基座大模型Qwen4-Max,总参数2.4T,具备原生视觉能力,支持百万上下文。基于创新的模型架构和训练优化,Qwen4-Max以更少的Token消耗实现了更高的性能,在智能体和编程等关键能力项上持续进化:在权威的全球前端编程盲测CodeArena中,Qw

    来源 腾讯网
  2. 星舰第15飞:B22助推器返场未果,S42将试塔捕?

    11月14日消息,美国中部时间2026年11月13日下午,SpaceX“星舰” 第15次试飞成功升空。此次任务使用超重型助推器 B22 号和飞船 S42 号,原计划首次实现助推器与飞船双双返回发射场并由发射塔机械臂实施空中捕获回收,同时部署 26 颗第三代星链卫星。但任务并未完全按计划推进。助推器未能按计划返回发射场,

    来源 TechWeb
  3. 星舰第15次试飞:B22与S42首演双回收未成,墨西哥湾落幕

    11月14日消息,美国中部时间2026年11月13日下午,SpaceX“星舰” 第15次试飞成功升空。此次任务使用超重型助推器 B22 号和飞船 S42 号,原计划首次实现助推器与飞船双双返回发射场并由发射塔机械臂实施空中捕获回收,同时部署 26 颗第三代星链卫星。但任务并未完全按计划推进。助推器未能按计划返回发射场,

    来源 TechWeb
  4. MiniMax,狂卷字节、OpenAI

    (本文作者为 AIX财经,钛媒体经授权发布)文 | AIX财经,作者 | 雷晶,编辑 | 魏佳AI生图赛道,最近打得火热。11月10日晚,MiniMax发布并开放H3-Image模型权重,打出了“又快又便宜”的牌。官方称,它10秒就能生成一张1600万像素的高清图片,价格只有同档位主流工具的50%-70%。在它之前,O

    来源 腾讯网
  5. 黄仁勋离任引不满:英伟达机器人工程师辞职

    【TechWeb】11月16日消息,英伟达机器人工程师Darrell Dai(戴达瑞)已通过个人X账号宣布辞职。他在帖子中解释,离职的核心原因是对公司前CEO黄仁勋(Jensen Huang)的离任方式感到失望,认为公司在此事上缺乏透明度和

    来源 TechWeb
  6. 英伟达机器人学习工程师戴士钦宣布辞职:“黄仁勋离职让我格外失望”

    IT之家 11 月 16 日消息,英伟达机器人学习工程师戴士钦(Darrell Dai)昨日发文,宣布将离开公司。 戴士钦表示,他眼中的黄仁勋不只是英伟达 CEO,他钦佩黄仁勋投资那些一下子看不到明确前景的未来技术。在深度学习热潮到来之前,黄仁勋就已投入 CUDA,并在人工智能成为所有人关注焦点之前布局 AI 领域。这

    来源 AI 行业观察
  7. ACE Music盲测超Suno v6:中国团队登顶AA音乐榜

    在Artificial Analysis最新发布的AI音乐人声榜单中,中国团队ACE推出的ACE Music v1以1160分的成绩超越长期霸榜的Suno v6。这是该榜单成立以来,Suno旗舰模型首次在盲听测试中失守头名。ACE团队从2025年3月启动基座模型研发,仅用18个月便实现突破。其核心优势在于“Symbol

    来源 AI 应用前沿
  8. DeepSeek开放全家桶应用API:开发者可复刻完整App体验

    【TechWeb】11月14日消息,DeepSeek发布全家桶应用 API,将其自有App中已经打磨成熟的整套交互能力打包为标准化、可调用的模块,向开发者开放。与以往仅提供模型推理接口不同,此次开放覆盖搜索、网页抓取与解析、文件解析、OCR、语音识别(ASR)、语音合成(TTS)等多项应用层能力,并支持开发者单独调用或

    来源 AI 行业观察
  9. 星尘智能CoMind:隔墙协作成功率100%,通信量降八成

    深圳具身智能公司星尘智能推出多机协同框架CoMind。该框架让机器人在视线受阻时,通过共享关键视觉特征而非完整视频流来协作。测试显示,在隔墙拿笔等任务中,成功率从0%提升至100%,同时通信数据量减少80%。这标志着多机器人协作从中心化调度向去中心化、基于动作反馈的信息交换转变。

    来源 AI 应用前沿
  10. 马斯克再创历史 SpaceX首次实现“筷子夹飞船”

    【TechWeb】11月15日消息,美国中部时间11月14日下午,美国太空探索技术公司(SpaceX)的“星舰”飞船在执行了大约22个半小时的飞行任务后,返回得克萨斯州的发射基地,并由发射塔“筷子”机械臂实施“捕获”回收。 这是SpaceX首次成功捕获从地球轨道返回的星舰上面级飞船,为实现星舰完全、快速重复使用迈出关键

    来源 AI 行业观察
  11. 戴士钦离开英伟达:黄仁勋辞职令他格外失望

    IT之家 11 月 16 日消息,英伟达机器人学习工程师戴士钦(Darrell Dai)昨日发文,宣布将离开公司。戴士钦表示,他眼中的黄仁勋不只是英伟达 CEO,他钦佩黄仁勋投资那些一下子看不到明确前景的未来技术。在深度学习热潮到来之前,黄仁勋就已投入 CUDA,并在人工智能成为所有人关注焦点之前布局 AI 领域。这些

    来源 腾讯网
  12. 百度词元所上线首日:入驻供应商破100家,新增客户超1000家

    11月14日,从百度获悉,百度词元所发布首日,新增申请入驻的供应商已超过100家,新增超过1000家客户接入。 词元所在11月12日举行的百度世界2026上正式发布,百度创始人李彦宏将其称为“大模型的交易所”。据介绍,词元所一端汇聚模型和模型提供商,另一端服务企业和个人,让用户便捷地找到、购买和使用可信的模型Token

    来源 AI 行业观察
  13. Runway开源Praxis-1:单卡RTX 5090可跑机器人控制

    2026年11月中旬的AI圈动静不小。Runway把Praxis-1模型开源了,还能在单张RTX 5090上跑机器人控制;Google DeepMind没闲着,放出了WeatherNext 3背后的PARDIG和SatWeave两套气象数据;llama.cpp终于到了v1.0.0稳定版。另外,Devin推出了云端应用托

    来源 AI 应用前沿
  14. 华为诺亚BEHAVIOR-1K夺冠:0.683 Q-score如何拿下第一?

    在2026年BEHAVIOR-1K具身智能挑战赛中,华为诺亚方舟实验室团队凭借HiPhys-RSI方案夺得冠军。不同于业界主流的“大力出奇迹”式Scaling,该方案通过编程智能体积累可执行的结构化知识,在100项复杂家庭任务中实现了48.2%的完整成功率。本文解析其技术路径:如何让机器人像老工匠一样,通过试错和复盘,

    来源 AI 应用前沿
  15. 智能体安全新课题:风险如何跨会话潜伏与放大?

    大模型正从聊天助手进化为能自主调用工具、读写文件的通用智能体。这意味着安全风险不再局限于“说了什么”,而是延伸至“做了什么”以及“留下了什么”。北大与腾讯联合发布的综述指出,攻击者可通过污染技能、记忆或环境,让风险跨会话潜伏并放大。传统组件式防御已失效,必须建立涵盖来源、编排、执行及持久反馈的全生命周期安全框架,并在运

    来源 AI 应用前沿
  16. 阿里发布Qwen4并上线Qwen4-Max:Token减半、得分升近28%

    阿里巴巴11月16日正式发布全新一代基座大模型 Qwen4,千问 AI 平台首发上线 Qwen4-Max,API 服务与 Token Plan 同步开放。模型采用基于 Qwen 稀疏注意力(QSA)的全新 MoE 架构,总参数2.4T,具备原生视觉与长程任务稳定交付能力,支持百万上下文,可调用专业工

    来源 AI 开发者社区
向下滚动自动加载更多