

谷歌被诉:AI训练合法,输出侵权?
过去两年,围绕生成式人工智能的版权争议,几乎都在“训练”阶段展开。出版商、作家、摄影师和音乐人反复向AI讨要说法:我的作品是不是悄悄被囊括进AI大模型的训练中?这场争论塑造了Bartz 诉Anthropic、汤森路透诉ROSS案、纽约时报诉OpenAI等标志性案件的基本叙事,也催生了授权谈判、集体管理机制和机器可读退出
过去两年,生成式AI的版权争议基本都围绕“训练”展开。出版商、作家、摄影师和音乐人不断追问AI:我的作品是不是被悄悄塞进了大模型的训练数据?Bartz 诉 Anthropic、汤森路透诉ROSS案、纽约时报诉OpenAI等标志性案件,都是在这一叙事下展开的,授权谈判、集体管理机制和机器可读退出协议等一整套应对方案也随之出现。
但到了2026年,高质量的公开语料差不多已被AI模型爬完,继续堆语料的收益在递减,AI与版权的交锋点开始转向“输出”。用户向生成式AI提问时,系统会实时检索网络内容,把原文片段放进上下文,再重组生成答案,这个过程叫“检索增强生成”(RAG)。用户看到的是一个最能回应当下需求的“摘要”,出版商失去的却是一次本该属于自己的点击、广告曝光以及与读者的关系。
2026年11月3日,欧盟法院(CJEU)总法律顾问Maciej Szpunar就首个提交该法院的生成式AI版权案件——Like Company诉谷歌案——出具非约束性意见,核心判断是:
AI训练或许合法,但输出可能侵权。
一、LikeCompany案:欧盟法院系统第一次认真切割“输入”与“输出”
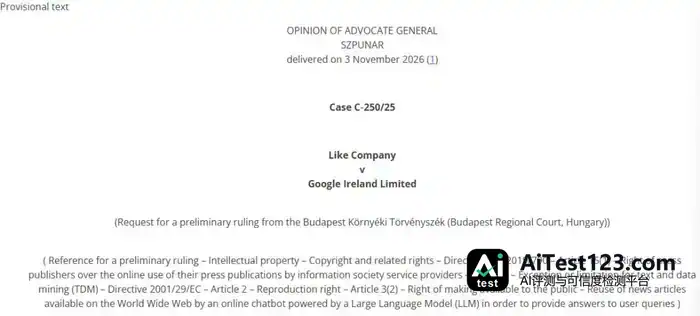
这起纠纷的事实并不难厘清。匈牙利出版商LikeCompany称,谷歌Gemini在回应用户提问时会实时抓取其新闻文章,产出与原文高度雷同的摘要,用户因此不必再点进原站。Google 的辩解还是老一套说法:模型学的是语言规律,产出的内容是原创表达;出版商手握控制机制,可以选择和退出。
Szpunar把案件拆成两层,而且刻意不让两层互相掩盖。
首先是训练环节:建议不受理,而非直接放行。
第一层落在训练上。Szpunar认为,本案没有事实基础能证明涉案文章真被放进了训练集,所以训练相关的问题他不接。不过他顺带给了一个判断:在文本与数据挖掘(TDM)例外框架下,用受版权保护的内容训练模型,原则上是允许的——条件是这些内容合法可及、权利人没有作出有效保留、开发者采取了防止逐字回忆的技术措施。
这一层其实对大厂相当友好。它相当于承认:单纯把公开作品喂给模型,不当然侵权。
真正的焦点在推理端,Szpunar提出两个测试要件:
1、抓取手段是否正当。假如Gemini是绕过付费墙或其他技术保护措施去读文章的,那即便原文“公开可搜”,也谈不上默示授权。总法律顾问直接否掉了“没设屏障就等于同意”这套逻辑——这一否定正好打在行业习惯上。
2、输出有没有构成“表达性替代”。这里不要求逐字复制,只要侧面对比能认出原作的表达形式,并且用户看完AI答案后不再需要打开原文,新闻出版者权就可能被侵害。换句话说,版权护的是具体表达,一旦AI把“具体表达”换个包装再端出来、顶掉了原作的市场,权利人的专属权就形同虚设。反过来说,只传递相同事实、用不同形式表达,不当然侵权;个别词语和极短片段也不在保护范围内。
要说清楚的是,这条红线属于“情形测试”,并非本案的结论。Szpunar的意见只是把标准画了出来,本案事实还得由匈牙利法院结合具体情况去认定。
这份意见的分量在于,它首次在欧盟法层面认定:训练中的复制与推理中的复制,是性质不同的两种使用;前者原则上可适用欧盟《数字单一市场版权指令》(DSM)里的“文本与数据挖掘”(TDM)例外规则,后者则必须单独接受表达权评价。
二、美国四大厂的“训练退出令牌”
就在LikeCompany意见出炉前一周,2026年10月30日,OpenAI、谷歌、微软和Anthropic联合宣布支持一种新型“策略令牌”(policy token)机制。网站只需在robots.txt里加一行__usage_ai-training的声明,就可以一次性禁止所有主流AI爬虫把内容用于训练,不必再逐个配置GPTBot、ClaudeBot、Google-Extended。
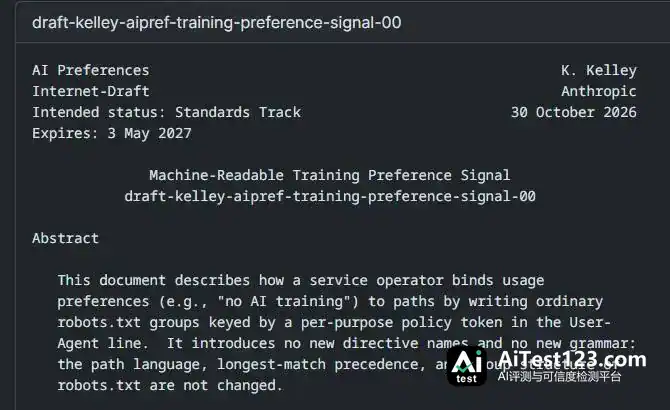
从技术治理的角度看,这算往前走了一步。原本散在四家企业各自的退出机制,被并成一个机器可读、对所有爬虫生效的统一机制,治理接口也从“双边”合同挪到了公共协议层。
问题在于,这套机制只管训练,不管搜索,更管不到推理时的调用。说白了,四大厂是拿“训练端让步”换“推理端自由”。眼下AI行业的商业模式正从“训练模型”转向“推理服务”,AI真正值钱的地方,是把出版商内容实时接进答案里。至少目前,训练端退出这个姿态成本很低,而AI公司把最有价值的推理牢牢攥在自己手里。
值得注意的是,欧盟《AI法案》本身对于AI公司的版权义务,也是双轨的。
根据《AI法案》第53条与《通用人工智能实践准则》(GPAI Code of Practice),签署方需要履行五项核心版权义务,第4项是“降低生成侵权内容的概率”,已经将推理端和输出端的版权风险写进了强制性义务。只是还没有细化到RAG该如何。
再把LikeCompany意见的信号叠上去看,欧盟不会只满足于“训练端”合规,下一步必然追问“输出内容”是否侵权。生成式AI的检索日志、引用账本、输出来源溯源,会从技术运维数据一点点变成合规证据资产。
三、中国科技公司版权合规拐点:从训练到推理
LikeCompany案的意见和四大厂的训练退出令牌,看上去是欧美市场内部的法律过招,但对正在加快出海的中国AI企业来说,这两件事指向同一个绕不开的趋势:AI版权合规的重心正从“训练端”挪向“推理端”——这套变化就是摆在眼前的合规变量。
过去两年,版权合规的功夫大多下在训练环节:给数据来源分类、把授权链条理清楚、披露训练内容摘要。中国出海模型在训练端的合规建设已经有了实质进展。有些模型已经按欧盟 GPAI 模板公开训练内容摘要,标注爬虫标识,建起数据治理流程。这些动作仍然必要,它们构成了进入欧盟市场的基础门槛。
问题是,只盯着训练端,可能会错过正在到来的下一波监管浪潮。
Szpunar 意见的核心贡献,不在于它对某个具体案件作出了最终裁决,而在于它在欧盟法层面第一次把“训练中的复制”与“推理中的复制”拆成了两个独立的法律行为,并为后者画出了一条可供检验的归责路径。这条路子的基本判断是:模型可以学习知识,但不能替身表达;可以检索信息,但不能接管市场。一旦 AI 的输出开始系统性替代原作的功能——新闻报道也好,学术论文、文学创作也罢——版权法的传统工具仍会激活。
再看美国四大厂联手推的那套训练退出令牌。技术治理上这是个正面信号,可推理端的调用问题被它绕开了。出版商退出训练之后,内容照样可能在实时检索里被调出来、被摘录、被重新拼进答案。“训练能退出、推理管不住”,这种结构上的不对称,早晚要成为下一轮争吵的引爆点。
落到中国企业身上,合规的重心得往外扩,甚至要挪地方。训练端透明只是敲门砖,真正能拉开差距的,恐怕是“推理过程能不能被审计”——说白了,就是能不能拿出证据,证明模型每次作答时都清楚自己用了谁的内容、用了多少、有没有越线。
在一套细化的推理合规标准出台之前,应当积极寻求理解和应对出版商的这类诉求,这也是一个值得认真对待的战略窗口。

















