百度一镜推微表情大模型:0.2元/秒修脸,短剧工具下游补位

资讯 钛媒体 全文 3794 字 · 约 10 分钟读完 配图 3 张 分类百度大模型影视

表情不对,剧就不好看。

所属频道 大厂动态模型发布影视与游戏

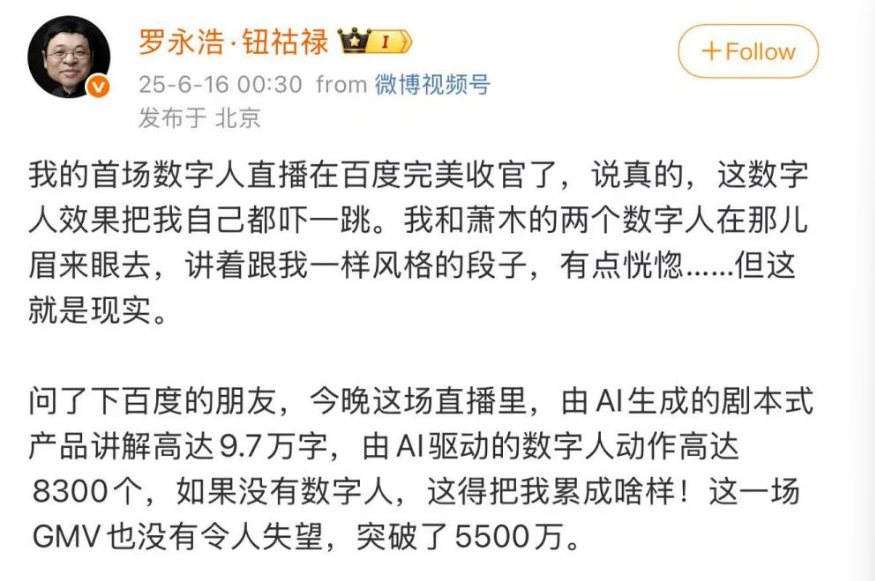
2025年6月,罗永浩出现在百度优选直播间,一口气播了6个小时,卖出5500万的货。观众规模达到1300万,真正让人意外的不是销量,而是其中很少有人察觉,画面里的他其实是个数字人。他的梗、标志性手势、常挂嘴边的口头禅,连同跟助理的实时互动,统统由AI现场生成,并非事先录好。跟早先那种“假直播”的数字人相比,技术难度又抬了一档。

决定成败的细节,落在眼神、表情这些“皮囊”上。这些也是AI实时算出来的,自然到看不出破绽,全然没有那种“女明星刚打了玻尿酸”的僵感。熟悉罗永浩的观众想找茬,也挑不出毛病。

如今,百度把这套“做真脸”的本事,搬到了AI短剧演员身上,专门修微表情。

百度一镜出手,盯上AI短剧的“修表情”生意

跟2025年比,AI短剧确实越拍越像真的了。去B站逛一圈就能感觉到:去年大家还在吐槽“AI脸”,嫌AI做得假;现在弹幕里的嫌弃声,已经换成了“哇,AI都能做到这地步了”。

拿最近几个月来说,黄仁勋、赵本山、库克等名人的AI演唱会,做得一点都不违和。创作者追时事也追得紧,黄仁勋的“告别演唱会”眼下都开始巡演了。
百度一镜推微表情大模型:0.2元/秒修脸,短剧工具下游补位(配图 1)

AI内容越来越逼真,可有个BUG一直没修利索——表情不真。一些粗制滥造的AI短剧,角色该哭的时候嘴角上扬,该狠的时候眼神发空。短剧圈里有种说法:“80%的烂剧和神剧之间,差的不是模型,不是算力,甚至不是剧本——而是一张会‘演戏’的脸。”

反过来看精品AI短剧,脸部微表情大都处理得经得起细看。导演会把大约30%的镜头留给人物表情特写。在创作者眼里,这些特写决定一部剧能不能把情绪顶到高潮。脸不对,戏就塌了。“修脸”成了这行的刚需。

有刚需,自然有人来做买卖。

日前的百度2026世界大会上,百度旗下数字人平台“百度一镜”正式发布“微表情大模型”。

顾名思义,这个模型只干“修脸”一件事。核心能力有两条:一是AU级精细控制,能捕捉并还原“挑眉”“眯眼”这类细微表情,而非只给几个预设的夸张表情。

二是高频率微表情,每秒最多能呈现8到9种微表情,用来传递复杂情绪。价格0.2元/秒,低于主流的0.8元/秒,按百度自己的说法,效果对标中等偏上。

乍看这个模型,容易以为百度要去“突袭字节Seedance的后院”。百度数字人创新业务部总监吴晨霞的解释是:微表情增强工具会对外开放。创作者不必用百度一镜做整部剧。拿即梦、可灵或别的工具做完,哪一段表情崩了,就把前后两段输进来,百度负责把衔接做好,再把这一段替换掉。

这话的意思很清楚:百度一镜没打算去抢AI短剧的“上游入口”,它把自己摆在所有短剧工具的下游,干的是修补站的活。

说得直白点,即梦卖的是生产能力,可灵卖的是真实感,百度卖的是“做完之后再修一下”。三家好比相机厂商,百度一镜情愿当个修图软件。你用哪台相机拍都行,觉得脸不行,拿来修就是。

有观察人士认为这个姿态很务实。它绕开了跟头部视频生成大模型的正面交锋,挑中一个行业刚需重点攻克。不碰内容创意,不担版权风险,只把铲子卖给挖金的人。

修脸难在哪,百度又凭什么修得了?

不少人有点想不通:给AI短剧演员修脸,真有这么难?美图秀秀接不了这活?一位算法工程师告诉《木禾商业财经》,微表情的难点在于它又短又弱,数据还少。你跟AI说“她很难过”,AI收到的是一团模糊的语义,它并不知道“难过”意味着眉间肌收缩多少度、下唇要不要颤抖、眼眶泛红到什么程度才算“隐忍”而不是“面无表情”。观众挑刺的眼睛,比任何算法都毒。

眼下市面上修微表情的路子,普遍都不太行。一种是用通用模型反复抽卡、一遍遍改提示词,抽上三条,效果也就那么回事。

另一种叫“白模拉表情”:先取一个没皮肤、没颜色的灰色人形模型,跟操纵木偶似的把表情拽到位,再交给AI照着生成带皮肤和光影的画面。这么干,效率非常低。

有意思的是,据透露,百度一镜这套表情控制能力,是在罗永浩数字人直播间里被转化率逼出来的。2025年6月,罗永浩的数字人在百度优选(百度的电商平台)首播,6个小时拿下超过5500万GMV、1300万人次观看。关键在于,不少观众没认出这是个假罗永浩——表情、玩梗、跟助理的互动全由AI实时生成,真切自然,并非提前备好的。

直播成绩也拿得出手:下单用户比真人主播多出230%,订单量高出150%。
百度一镜推微表情大模型:0.2元/秒修脸,短剧工具下游补位(配图 2)

这场直播说明了一件事:数字人的表情、口型、语气、动作跟脚本对得足够齐时,观众是愿意掏钱的。而追转化率,又会倒逼数字人技术继续往“像真人”的方向走——要卖货,要不让观众看出破绽,表情和互动就得做得足够真。微表情大模型的技术积累,就这么无意间攒了下来。

吴晨霞的总结很直白:把罗永浩的数字人做好、文本创作做好、微表情做好,长视频说话互动的Agent能力也有了,串起来就是AI短漫剧的视听生成,修脸这门技术便能拿出去卖。

数字人主播、数字人直播这个行业,其实2022年就兴起了。那会儿除了百度,腾讯、阿里、快手乃至小红书都在做。不过从当下数字人直播的市占率看,百度一镜已经跑到了头部。

沙利文在2026年5月发布的报告里提到,中国AI数字人市场头名是百度一镜,份额8.1%,已服务超10万客户。眼下不少自媒体KOL和电视台主播每天追热点发的视频新闻,背后用的正是百度数字人技术。

百度集团副总裁、移动生态大商业事业部总经理平晓黎“解密”说,百度数字人能走到今天,原因在于一开始就不是“为了做数字人而做数字人”,而是孵化于电商业务,目标一开始就定在转化上,要做出超过真人的感觉。

于是所有技术研发的指向都瞄准了“让数字人越做越真”:剧本怎么写才能提升转化,眼神怎么动才显得不假。反观市面上不少数字人产品,重形象和口播,对剧本的规划不足,自然就弱一截。

理清这段历史,百度方面的潜台词也就不难读出:把数字人技术延伸到AI短剧微表情,不过是能力的外延。当然,AI短剧市场的发展空间,他们肯定也看在眼里。

只是AI短剧要想做好,光有一个微表情大模型还不够。

AI短剧市场,百度坐的是哪把椅子?

今年内容市场的当红炸子鸡,非AI短剧莫属。中国电影票房奔了快一年才318亿;短剧前9个月上线49万部,是去年全年的15倍。

红果光一个平台每天就上线200多部新剧,日活1.68亿,这个量比爱奇艺、腾讯视频、优酷、芒果TV四家加起来还大,全年广告收入预计有数百亿。

可到了2026年,转折来得相当残酷。AI把供给端打开之后,红果短剧产量猛涨,播放量里头部20%拿走了80%以上,万播收益则从一年前的百元左右掉到5到10元,有创作者反馈说只剩几块钱。算法推荐机制本身没动,变的是内容堆得太多,广告预算不够分。

在这套格局里,字节红果扮演入口平台,强项是用户体量和广告预算。Seedance则是字节的视频生成模型,经即梦对外输出,主打“立刻能出片”的体验,门槛低,覆盖也广。

快手的可灵,主打物理真实感和中文动作场景,特别会做复杂肢体动作和中文动作世界观,服务的是对画面质感有要求的创作者。

如前述,百度一镜跟这三家并不打算在同一层面上抢:即梦卖生产能力,可灵卖真实感,百度卖的是“做完之后修一下”。这个定位天花板很刚、很聚焦,BUG也很明显——修表情的生意,规模取决于有多少人愿意为“最后那一下”单独付费。

做跑量剧的创作者,成本上每一分钱都要抠,再让他们单独买一个专门修表情的工具,恐怕会犹豫。

精品剧的创作者对微表情大模型的需求应该更大一些。可问题是,精品剧在市场盘子里数量本来就少,撑不起一个独立赛道。

百度顺手还做了另一件事:同步上线“短漫剧Studio”,带了三个Agent能力。

剧本Agent能支持百万长篇小说的IP改编,在生成视频之前先把剧本打磨到足够精细,减少描述模糊造成的反复抽卡,从源头把成本省下来。

成片Agent负责从资产到分镜、再到成片生成,帮创作者把灵感变成有爆款潜力的成片。

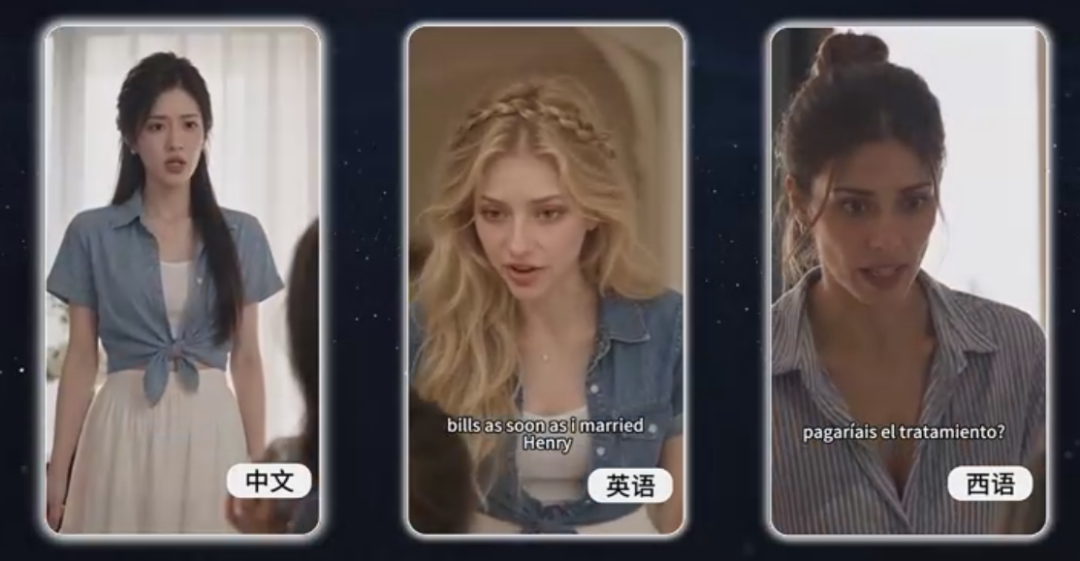
再一个是转绘能力,能做到“出海作品秒速适配海外文化背景”,背后依托的数据库技术叫“世界观映射”。
百度一镜推微表情大模型:0.2元/秒修脸,短剧工具下游补位(配图 3)

说白了,中国的豪门总裁人设,到了海外可以变成吸血鬼或狼人体系;中国女生端茶壶的镜头,转绘之后会变成英国宫廷的玻璃壶。这已经不是翻译,而是文化语境的替换。

一键转绘瞄准的是想做海外市场的承制方。国内短剧市场的竞争激烈程度,已经把承制方的毛利率压得薄如纸,红果的补贴退潮后,大批团队在盈亏线上挣扎。

海外的情况不一样。没有红果级别的巨无霸,会员付费和广告变现都还有空间,竞争烈度低了一个量级。吴晨霞说,北美是重点,东南亚也会去开拓市场。

百度这一连串动作,市场究竟会有多少人买单?

微表情短漫剧版本上线之前,百度自己也不知道答案。不过据透露,眼下已经有客户开始对接,已有百集规模的剧本希望百度做海外本土化适配。他们看中百度产品最大的能力,就是“降本”。

总的来看,百度奇袭AI短剧不算拍脑袋的决定。这项能力在直播间里被转化率验证过,如今找到了一个更愿意为“脸”付钱的场景。

能不能成,还要看那些被AI脸折磨过的短剧制作者,愿不愿意为“最后那一下”掏钱。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 百度词元所上线首日:供应商增超100家,客户接入破1000家

    【环球网科技综合报道】11月14日,从百度获悉,百度词元所发布首日,新增申请入驻的供应商已超过100家,新增超过1000家客户接入。词元所在11月12日举行的百度世界2026上正式发布,百度创始人李彦宏将其称为“大模型的交易所”。据介绍,词元所一端汇聚模型和模型提供商,另一端服务企业和个人,让用户便捷地找到、购买和使.

    来源 腾讯网
  2. 百度Q3财报:AI业务收入132亿,AI云增速升至94%

    当大模型竞赛进入深水区,市场开始追问一个现实问题:高昂的模型调用投入,如何真正转化为企业经营收益?百度世界2026给出的判断是:AI创造经济价值的关键,不只是模型性能的提升,更在于企业能否围绕AI重新组织工作流程,实现经验沉淀、能力复用,也就是“智能组织”。刚刚出炉的百度2026年第三季度财报,为这套战略提供了...

    来源 腾讯网
  3. 96% 的测试集泄漏,大模型的跑分还能信吗?

    文:ZZ 未至之境 TL;DR:一分钟读完▸我们在 20 套主流考卷上测试了 4 个公开的大模型基座版本,发现刚公开的百度的ERNIE-5.5-Flash-Base 能在没看过题的情况下,一字不差地默写出 96% 的 HumanEval 编程测试题、85% 的 OpenBookQA 科学测试题、80% 的 GSM8K

    来源 腾讯网
  4. Seedance 2.0与可灵分拆:2026年AI视频重塑影视资本格局

    AI改写行业,谁先交卷?钛媒体《智能大迁移》将从十个问题出发,观察AI如何从模型之争落地到千行百业。接下来我们还会整理更多的话题,通过中美技术趋势和行业观察,看不同行业的智能迁移。

    来源 钛媒体
  5. 阿里发布Qwen4,千问平台首发Qwen4-Max:Token减半、得分涨近28%

    11月16日,阿里发布新一代基座大模型Qwen4,千问AI平台首发Qwen4-Max,API与Token Plan同步开放。该模型采用Qwen稀疏注意力MoE架构,总参数2.4T,支持百万上下文、原生视觉与长程任务稳定交付,可调用工具并分阶段交付;评测中同档位较上代提升。

    来源 AI 产业速递
  6. 阿里发布Qwen4并上线Qwen4-Max:Token减半、得分升近28%

    阿里巴巴11月16日正式发布全新一代基座大模型 Qwen4,千问 AI 平台首发上线 Qwen4-Max,API 服务与 Token Plan 同步开放。模型采用基于 Qwen 稀疏注意力(QSA)的全新 MoE 架构,总参数2.4T,具备原生视觉与长程任务稳定交付能力,支持百万上下文,可调用专业工

    来源 AI 开发者社区
  7. llama.cpp 1.0.0 发布:150+ 模型架构支持,离线跑大模型

    IT之家 11 月 14 日消息,开发者 Georgi Gerganov(X 账号为 @ggerganov)昨日(11 月 13 日)在 X 平台发布推文,宣布开源 AI 推理项目 llama.cpp 与底层机器学习引擎 ggml 的库版本迈入 1.0.0。 IT之家查询公开资料,Gerganov 是开源项目 llam

    来源 AI 行业观察
  8. 阿里Qwen4-Max发布:总参数2.4T,单任务平均费用降六成

    新京报贝壳财经讯(记者罗亦丹)11月16日,阿里巴巴发布全新一代基座大模型Qwen4-Max,总参数2.4T,具备原生视觉能力,支持百万上下文。基于创新的模型架构和训练优化,Qwen4-Max以更少的Token消耗实现了更高的性能,在智能体和编程等关键能力项上持续进化:在权威的全球前端编程盲测CodeArena中,Qw

    来源 腾讯网
  9. 谷歌 Gemini4Carbon 入驻 WorkBuddy,百万 Token 上下文向 Pro 用户开放

    腾讯 WorkBuddy 国际版于11月15日宣布正式接入谷歌 Gemini4Carbon 大模型,面向复杂推理和长周期任务处理场景提供模型支持,目前仅向 Pro 计划用户开放。 Gemini4Carbon 是谷歌面向长周期智能体工作流推出的模型,适用于复杂知识工作、软件工程、网络安全及科学推理等任

    来源 AI 开发者社区
  10. OpenAI董事警告:AI“接管”社会可能仅剩数月

    OpenAI董事会成员、AI安全研究者近日发出严厉警告:从AI的“奖励黑客”行为到潜在的人类灭绝,路径可能比公众想象得更短,社会被AI“接管”的时间窗口甚至可能只剩数月。随着大模型与自主智能体能力快速跃升,目标错位与对齐失败正从学术讨论变为迫在眉睫的现实挑战。

    来源 AI 科技快讯
  11. 清华江瑞课题组发布ProtCell:在摩尔线程S5000上复现预训练

    IT之家 11 月 14 日消息,据摩尔线程公众号,近日,清华大学自动化系江瑞课题组发布了面向单细胞蛋白组的基础模型 ProtCell,完成了论文《ProtCell:a foundation model for single-cell proteomics》。该模型汇集约 3.8 亿个细胞、98 个公开数据集用于预训练

    来源 AI 行业观察
  12. 腾讯WorkBuddy接入Gemini4Carbon:百万Token上下文向Pro用户开放

    腾讯WorkBuddy国际版11月15日宣布接入谷歌Gemini4Carbon大模型,面向复杂推理和长周期任务,目前仅向Pro计划用户开放。该模型面向长周期智能体工作流,适用于复杂知识工作、软件工程、网络安全及科学推理,支持文本、图像、音频和视频多模态输入,输入输出合计上下文窗口最高达100万Token。

    来源 AI 产业速递
  13. 百望股份CEO王强宇:AI财税产品如何落到任务链上

    企业把大模型接进产品之后,新的经营问题才刚刚展开。客户提出一项任务,系统能拿到哪些信息,由谁核准结果,出现例外时如何处理,都会影响AI能否持续投入使用。产品演示中的能力,需要经由完整的服务过程才能转化为客户价值。 王强宇出任百望股份首席执行官(CEO),为观察这项变化提供了一个具体切口:王强宇如何将百望的财税场景积累转

    来源 AI 行业观察
  14. Gemini被称美国豆包,张一鸣活成中国布林:两人都把时间押给AI

    在太平洋两岸的科技版图上,一种奇妙的镜像正在发生。大洋彼岸的硅谷,早已退居幕后的 Google 联合创始人 Sergey Brin (谢尔盖布林)重新走进办公室,与一线研究员并肩推演大模型架构。而在亚洲,2021 年便将字节跳动 CEO 权杖交给梁汝波、此后极少公开露面的张一鸣,也正以一种高密度、深介入的姿态重回技术腹

    来源 腾讯网
  15. 工业AI净利率跌破5%:错尺子量不出实体利润

    (本文作者为 GritMeng,钛媒体经授权发布)文 | GritMeng聊天对话框省不出利润率,物理AI真正的金矿藏在“同源耦合”的水下。这两年,科技界与实体产业之间裂开了一道肉眼可见的鸿沟。一边是算力基础设施与大语言模型狂飙突进,参数规模、推理速度每半年翻一番,智能体(Agent)概念席卷所有科技峰会;另一边却是广

    来源 腾讯网
  16. NICT OptiMer:不重训模型,如何快速锁定最优数据配比?

    大模型训练中,数据配比调优通常意味着昂贵的从头重训。日本信息通信研究机构(NICT)团队在EMNLP 2026获奖论文中提出OptiMer方法,通过合并“分布向量”来搜索最优数据比例。该方法将试错效率提升15至35倍,且在C-Eval、MMLU等基准测试中得分高于传统混合训练。文章解析了其技术原理、实验效果及在构建日语

    来源 AI 应用前沿
  17. 蚂蚁灵波首届具身大模型挑战赛收官:TARS战队82.5分夺冠

    11月16日,蚂蚁灵波首届具身大模型挑战赛总决赛结果出炉。“TARS”战队获一等奖,成员来自福田实验室、西工大、普渡机器人、天津大学;“EVA”战队(华科、清华深研院、湖北元一智能)和“SST”战队(天大、北大、中科院自动化所)获二等奖;“Vida”“FDU_SONIC”“ai-robot”获三等奖。

    来源 AI 产业速递
  18. 阿里上线Qwen4-Max:原生视觉+百万上下文,总参数2.4T

    11月16日,阿里巴巴正式上线新一代基座大模型Qwen4-Max,总参数2.4T、激活参数71B,具备原生视觉能力并支持百万上下文,采用基于Qwen稀疏注意力(QSA)的全新MoE架构,每个Token激活参数较上代减少25%。

    来源 凤凰科技
  19. 英伟达7500亿美元融资网被曝:CFO曾力阻,黄仁勋回怼“鹿入车灯”

    《华尔街日报》2026年11月13日调查报道指控英伟达通过向AI初创公司注资、要求其用所得资金购买GPU的方式人为制造芯片需求,布隆博格随后绘制的融资网络规模已超过7500亿美元。英伟达内部,CFO克雷斯(现任代理CEO)曾在8月高管会议上力阻该策略,遭黄仁勋以"鹿入车灯"之语驳斥。该调查触及大模型军备竞赛最脆弱的基础

    来源 AI 科技快讯
向下滚动自动加载更多




