

Claude新模型闯进3D生产:从4800行代码造鹈鹕到550美元生成射击游戏
谁能率先把两种能力整合进同一套系统,谁就更有可能成为下一代数字世界的“造物者”。
这轮Fable 5.2的创作热潮里,视频能力已经不是最抓眼球的部分。更受关注的是 Claude的代码生成开始跨出视觉内容,转向可以运行、可以交互的3D环境搭建。
博主Tech Friend AJ做了一版3D“鹈鹕骑自行车”,从中能看出模型对复杂物体结构和运动关系的把控。Fable 5.2用大约4800行Python代码,在Blender里从零把鹈鹕和自行车搭起来,羽毛、骨骼、链条传动、动作和灯光全靠程序生成。
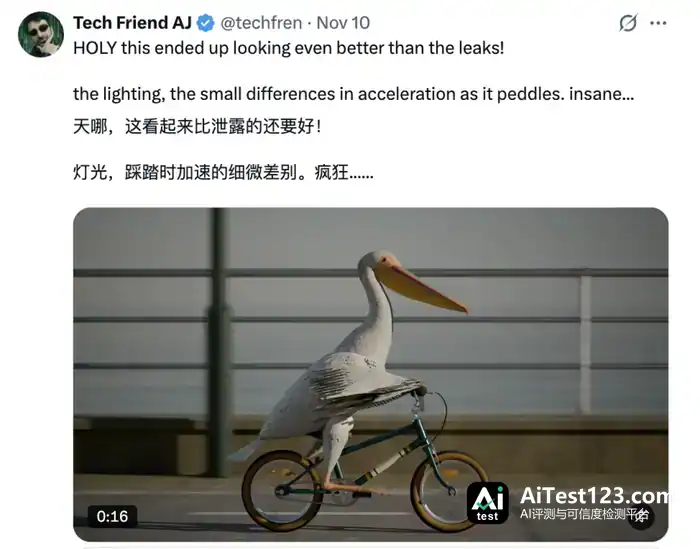
成片里,鹈鹕踩车的动作很自然,双腿、车轮和链条彼此配合,羽毛也随身体运动产生动态变化,完整的3D动画效果已经具备。
之后这位创作者又让模型做了一段鸟群动态设计视频。这一回Fable 5.2没有调用Blender,而是自己编写Python和GLSL渲染程序,模拟约4万只鸟的群体运动,生成约4600帧画面。鸟群在画面中形成大规模集群运动,个体动作与整体队形变化彼此协调,模型处理复杂3D动态场景的能力由此显现。
相比生成3D动画,3A游戏更能说明Fable 5.2这次的能力升级。
AI博主Matthew Berman让Fable 5.2试着做一款《战争机器》风格的游戏。初始提示词只有三行,要求模型用Unreal Engine 5做一个可玩关卡,画面和玩法都接近原作。
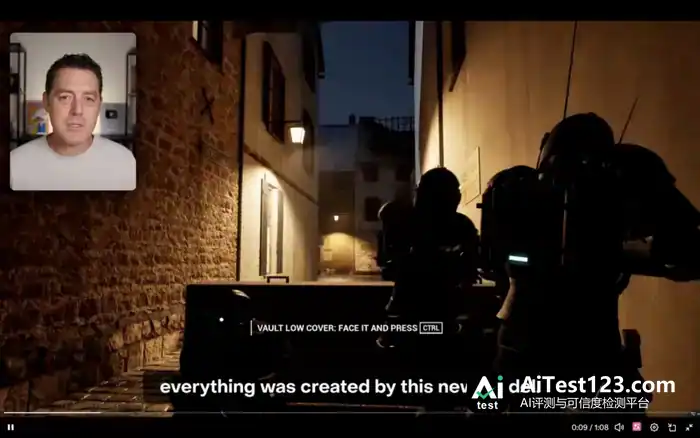
最后生成的是一个第三人称掩体射击关卡。玩家能在街道和建筑之间冲刺、找掩体、探身射击,还能用上《战争机器》标志性的主动装弹机制。建筑、材质、灯光和人物动作一起构成了完整的战斗空间,整体视觉质感已经接近3A游戏。
《战争机器》体现的是Fable 5.2调用专业游戏引擎的能力,《Saltline》则更进一步:它几乎完全靠代码,从零搭建游戏世界。
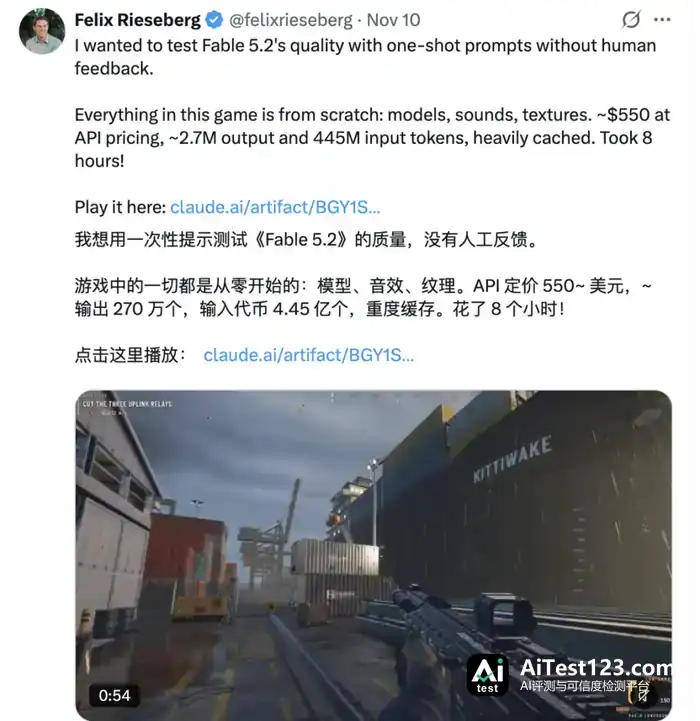
 Anthropic工程师Felix Rieseberg只给了一次提示词,让模型做一款第一人称射击游戏。8小时后,一个能在浏览器里运行的完整关卡就生成出来,API成本估算约550美元。
游戏背景设在一座雨夜货运港口,起重机、仓库、集装箱和停泊的货船组成完整的工业环境。玩家要切断三个通讯中继站,同时躲开无人机和四足机器人Hound。地面和金属表面有潮湿的反光,集装箱上的油漆剥落后露出底漆和锈迹,机器人行走时也有符合关节结构的动作。
模型先用数学函数定义物体和纹理,再编写Shader生成画面。整个游戏世界的视觉元素,都是代码计算出来的。
与此前Opus 5.5参与制作的《小王子》游戏相比,这种变化更直观。
当时独立创作者Sac花了16天,把《小王子》改编成一款能在浏览器中探索的剧情游戏。作品更像一部可以交互的3D动画电影,重点在风格化场景和叙事体验。相比之下,Fable 5.2近期生成的游戏明显向写实3D靠拢,开始用程序模拟更丰富的视觉细节和世界规则。
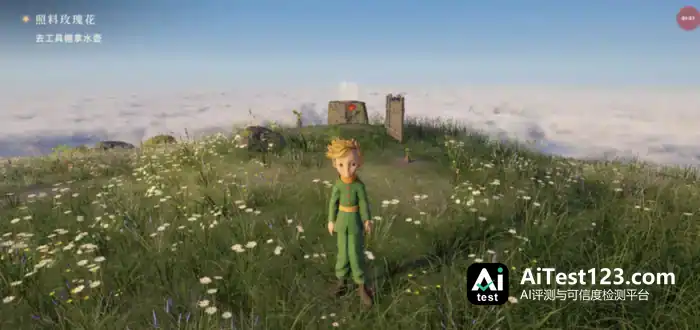
从风格化叙事,到具备真实材质、光照、物理效果和交互机制的游戏世界,Claude的代码创作能力正朝更完整的3D内容生产迈进。
画面的实现方式也变了。此前Opus 5.5的代码创作案例大量使用SVG、Canvas等技术,更容易做出鲜明的动效感。到了Fable 5.2,模型既能调用Blender这类专业软件,借助成熟的几何结构、PBR材质、光线反射和阴影系统完成渲染,也能直接编写渲染程序和Shader,自行生成模型、纹理和光照效果。
代码不再只是做动效的工具,也开始成为搭建完整3D场景、模拟现实效果的生产手段。
调度专业软件,直接“编译”世界,大模型闯入专业3D生产
通用大模型进入专业3D内容生产,今年已经是越来越明显的趋势。
9月份 GPT-6 Astra发布并开放测试后,开发者社区很快冒出大量实测案例。有人只给一张蒸汽火车的旧图,就让Astra在Blender中重建出3295个可编辑物体;有人根据房屋照片还原室内空间,家具、电器一应俱全;也有人在Unreal Engine里逐街区搭建曼哈顿,做出可以自由漫游的城市场景。
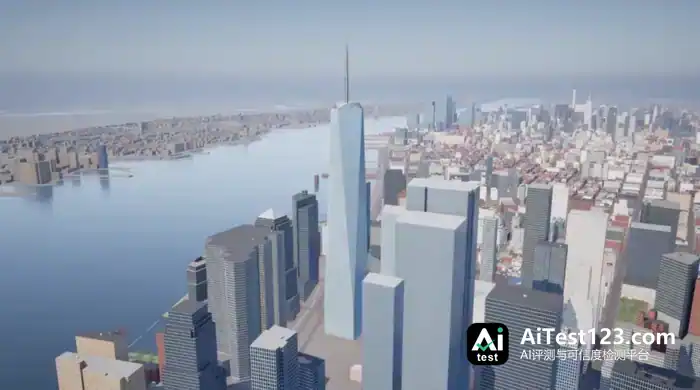
OpenAI的官方演示里,Astra能从文字需求出发,在Blender里完成建筑建模、材质和灯光,再把场景导入Unreal Engine 5,加入角色控制和交互功能,最终生成可自由探索的3D空间。社区里还出现了把角色建模、50根骨骼绑定和动画接入串联起来,最终在UE中运行的案例。
这些案例背后,Astra的一项典型能力是Computer Use。它能通过多模态视觉识别读取软件界面,再模拟键盘和鼠标操作,直接控制Blender、Unreal Engine等专业工具;碰上复杂任务,还会结合代码完成建模、调整和跨软件导入。
换句话说,它可以像一名熟悉专业软件的数字创作者那样,在不同工具之间切换,把一系列操作组织成完整的生产流程。
相比之下,Fable 5.2更突出代码本身的生成与组织能力。它不仅能写Python脚本调用Blender,还能直接用JavaScript、GLSL等语言定义几何结构、材质、Shader和物理逻辑,甚至从零搭建渲染程序和游戏运行环境。
从3D创作的路数上看,两者的偏重已经很清楚了:Astra 走的是让智能体去调度那些成熟专业软件的路子,把现成的工业工具串成一条生产管线;Fable 5.2 则更进一步,演示了怎样用代码直接定义3D世界、生成视觉资产,并把运行规则也写出来。
Astra到Fable 5.2这条路走下来,通用大模型正把推理、代码生成和工具调用带进专业3D生产管线。建模师、程序员、技术美术过去要协同完成的活,现在开始由一个模型来统一理解需求、调用工具、组织执行。
从生成画面到可交互空间,Seedance们不再满足于做视频
通用大模型沿代码和专业软件这条路往前推的同时,视频模型也在找进入3D世界的入口——用从海量影像里学到的视觉与运动规律,搭一个能持续交互、响应用户操作的虚拟环境。最早的做法,是让视频模型更好地理解和利用3D空间信息:7月底推出的Seedance 2.5支持白模参考,用户拿无材质的3D模型给出场景结构、人物姿态、运动路径和摄像机角度,最终画面再由视频模型生成。
字节显然不满足于此。9月彭博社报道称,张一鸣正亲自督导字节一项实时空间视频生成模型的研发,目标是让虚拟环境实时响应用户操作。10月11日的抖音集团“2026美好奇妙夜”,把这种探索更直观地摆到了公众面前。影视飓风Tim现场输入一句描述,系统自动生成了一个可以自由探索的微缩3D房间。用户能乘纸飞机在场景里飞行,随时生成新物体——比如在杯子旁加一把勺子,还能让角色和勺子发生互动。演示中,用户甚至可以通过任意门,从一个空间进入另一个世界。
字节之外,其他团队也在快速推进,重点集中在用户如何控制和改变生成的内容。
一类探索瞄准的是“控制”这件事。9月,腾讯与新加坡国立大学、香港理工大学合作拿出H3-World:在33B参数的MiniMax-H3视频生成模型上做动作控制适配,团队喂进约8000条游戏视频,只动了基础模型约0.199%的参数,模型便学会了角色移动、摄像机运动和连续动作控制。用户能指定的不只是画面里有什么,还包括角色在什么时间做什么、镜头怎么走。视频模型此前学到的运动规律与场景知识,就此变成对虚拟世界的连续操控。

9月,AI视频生成平台PixVerse推出R2。以往的视频模型按提示词产出固定长度的一段片子,R2让生成过程一直跑着。用户能在场景里实时挪动角色、调整摄像机,也可以随时敲入新的文字指令,改动环境、添加物体或改变角色动作。PixVerse展示的互动作品《Zero Mark》中,玩家被一只生物拦住去路,对方索要一份礼物。送龙还是送叶子,回应不同,后面的剧情也跟着变。这些分支并非事先录好,而是依玩家选择实时生成。
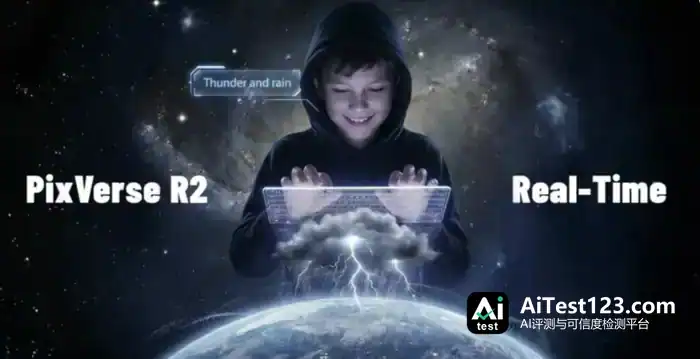
Seedance 2.5拿3D白模控制画面,H3-World让用户持续操纵角色与镜头,PixVerse R2和字节的实时空间模型则让用户直接改动场景、剧情乃至整个世界——视频模型正从生成画面转向持续响应用户操作的互动内容。模型从影像里学到的视觉与运动规律,用途不再限于出视频,还能撑起连续的场景变化和实时反馈。用户与AI生成内容的关系也随之改变:从看一段视频,变成走进场景、参与其中,并影响接下来发生的事。
两条路线开始正面交锋,争当下一代数字世界“造物主”
Vibe Video的流行,让通用大模型切入了原本由视频模型主导的部分视觉创作场景;AI游戏、互动叙事和可探索虚拟空间的兴起,则让两类模型在更3D的内容生产上展开竞争。
通用大模型的长处,是能借助代码和专业软件产出可编辑、可复用的3D资产。代码除了定义物体长什么样,还能规定它们怎么动、怎么碰撞、怎么交互。重力、关节、碰撞检测、角色行为,都能写成程序交给游戏引擎跑。理论上,只要现实中的物理规律和交互关系能被准确形式化,就有机会用代码搭出对应的模拟环境。
视频模型的优势来自海量图片和视频训练攒下的视觉知识。物体外观、材质、光影、人物动作、摄像机运动和场景变化,都已进入模型的视觉表征。OpenAI早期的Sora技术报告就展示过:摄像机转动时,模型能维持场景的3D连续性,让被遮挡的物体重新露出来,甚至模拟Minecraft的画面和基本操作。
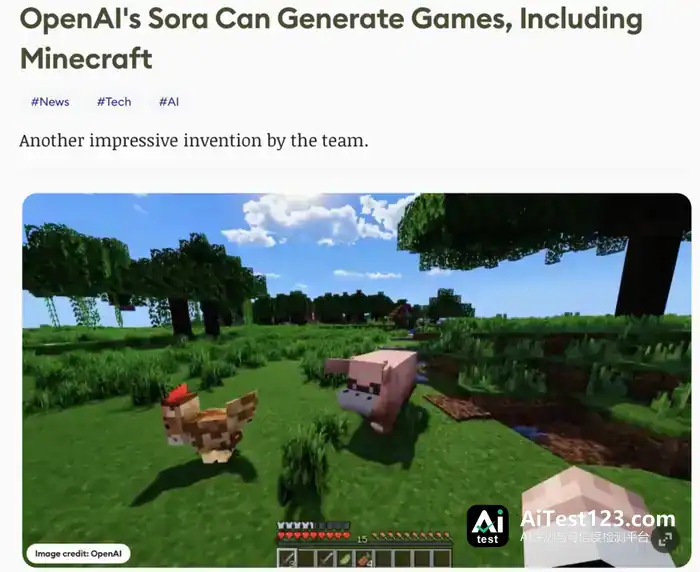
但视觉上连贯,不等于物理规则已被准确掌握。Sora的技术报告同样指出,遇到玻璃破碎这类基础物理现象,模型仍可能生成错误。也就是说,视频模型学到了相当丰富的世界动态规律,却还没法把这些视觉经验完整转成精确的几何结构和物理规则。
两种技术路线的分野也由此显现:通用大模型倾向于把世界拆解成可以编辑的资产和明确的运行规则,视频模型则利用从海量影像中学到的知识,直接生成画面及其动态变化。
成本结构上,两条路线也不一样。算AI游戏和互动内容的生产成本,不能只盯单次生成的开销,得把前期生产和后续运行分开看。通用大模型要反复理解需求、写代码、调工具、修错误,任务一复杂,Token消耗就上去了。前文提到的《Saltline》只做一个游戏关卡,就花了约8小时,API成本估算约550美元。这笔钱主要落在前期:标准资产和运行规则一旦搭好、交给游戏引擎执行,玩家日常操作就不必每次都重新叫大模型。

视频模型这边,成本结构又是另一番样子。它不用逐个编写模型和渲染程序,直接拿训练中积累的视觉知识生成内容;可要是整个互动环境都靠视频模型实时出画面,玩家每操作一次就可能触发一轮新的推理和生成,成本会随交互时长和用户规模不断往上堆。
AI游戏和互动内容未来的竞争,会集中在三处:视觉内容能不能做得足够丰富,角色、道具和场景能不能持续回应用户操作,以及能不能以合理成本长期跑下去。
眼下,视频模型更擅长生成画面、呈现动态,通用大模型则在资产编辑、复用以及按明确规则加以控制这几方面更占优。两条路线争夺的对象,已经超出互动内容的生产入口,还延伸到数字世界最终以何种方式生成、运行并不断更新。
答案未必是二选一。一种可能的分工是:大模型负责定义世界的结构与规则,视频模型负责给它真实的样貌与动态。谁先能把这两种能力装进同一套系统,谁就更有机会成为下一代数字世界的“造物者”。













