平均年龄25岁,00后小伙带队拿下首届蚂蚁灵波具身大模型挑战赛最高分

资讯 雷峰网 全文 1706 字 · 约 5 分钟读完 配图 3 张 分类大模型

从仿真到真机测试,需要跨越哪些难题?

所属频道 模型发布

11月16日,首届蚂蚁灵波具身大模型挑战赛总决赛成绩揭晓。

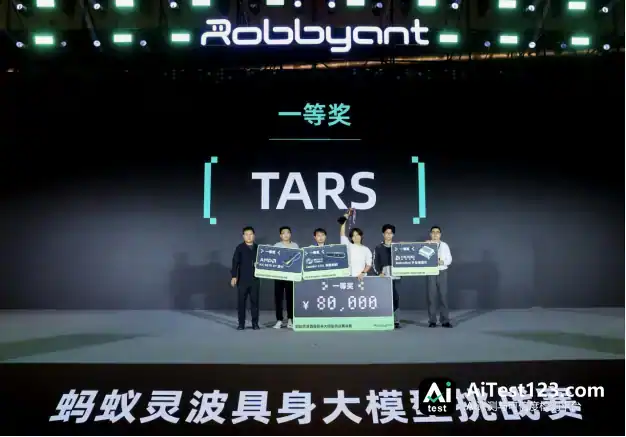
一等奖由“TARS”战队摘得,五位选手分别来自福田实验室、西北工业大学、普渡机器人、天津大学。二等奖有两支队伍:“EVA”战队由华中科技大学、清华大学深圳研究院、湖北元一智能的三位选手组成,“SST”战队的三位选手则来自天津大学、北京大学、中国科学院自动化研究所。三等奖归属“Vida”“FDU_SONIC”“ai-robot”三支战队。此外,9支队伍拿到优秀奖,3支队伍获观察团特别奖。
平均年龄25岁,00后小伙带队拿下首届蚂蚁灵波具身大模型挑战赛最高分

TARS战队拿下首届蚂蚁灵波具身大模型挑战赛一等奖 图源:受访对象

真机较量持续48小时,机器人得闯三道关

11月14日,15支决赛队伍在上海张江科学会堂完成集结。选手中有人从北京、上海、杭州、深圳、成都、武汉等地赶来,也有人专程从温哥华飞回参赛。上午9点赛题公布,各队随即进入工作间,投入为期48小时的真机黑客松。

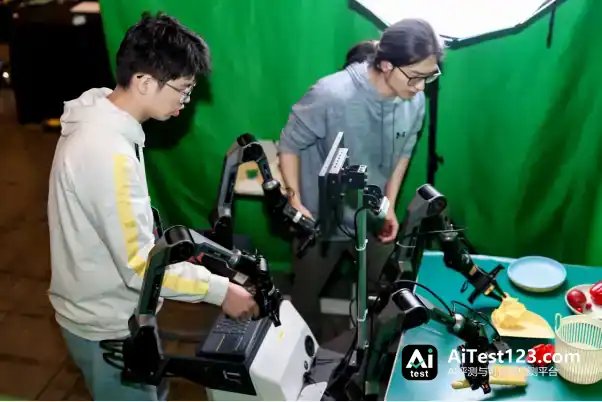
技术底座是同一款开源预训练模型 LingBot-VLA 2.0,机器人硬件、推理算力和任务环境也统一提供,各队在此基础上做真机挑战。赛题共三项:单臂抓取水果蔬菜;单臂抓取化妆品放进透明盒;双臂配合把桌面垃圾清扫进收纳筐。
平均年龄25岁,00后小伙带队拿下首届蚂蚁灵波具身大模型挑战赛最高分

比赛现场,选手操作机械臂完成双臂协作清扫垃圾任务 图源:受访对象

这些动作日常里司空见惯,换到机器人身上,每一步都得经得起检验——识别物体、抓稳、放准,透明物体的交互尤其棘手,再到两只机械臂彼此配合,考官会综合评定动作完成质量和任务成功率。决赛安排了三轮真机测评,各队取其中总分最高的一轮计入排名。

“TARS”战队最终以82.5分位列第一。这支队伍平均年龄只有25岁,队名来自电影《星际穿越》里那个忠诚又幽默的机器人。队长吴昊楠是00后,即将从天津大学硕士毕业。路演环节他讲了团队的技术思路和策略:把复杂的多物体场景简化成单物体抓取,以此绕开VLA模型在杂乱环境中的感知瓶颈;数据采集选择小规模高精度重采和双人协作模式,避开物理世界机械臂的系统性误差,也避免人类操作者的生理舒适度影响机器人动作轨迹的自然性与有效性。

上海交通大学人工智能学院副教授李永露认为,办具身大模型挑战赛,比拼沉淀下来的不只是荣誉,更是一套经受住实战检验的工程经验与方法论。统一基础模型、硬件载体与实操任务之后,大赛给高校学者、产业工程师和独立极客搭起一个“控制变量实验场”:每次抓取失败的边界条件、每组精准校准的补采数据、每轮模型调优后的实测反馈,都能帮后来者少走弯路,推动机器人“通用大脑”走进下一个真实的物理现场。

锚定具身原生,蚂蚁灵波推出开发者生态计划

同一天,蚂蚁灵波首届开发者大会召开,全球知名学者和一线产业实践者到场,分享具身大模型的最新研究与实践,并围绕真机落地难点、开发者生态如何共建等话题交流。

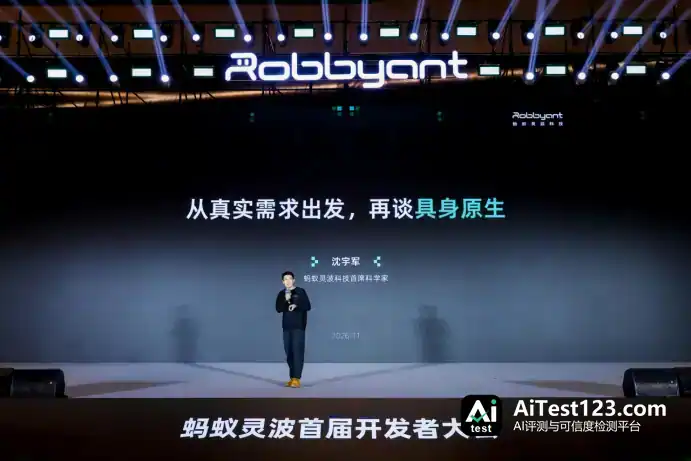
科学家技术讲座环节,蚂蚁灵波首席科学家沈宇军讲了公司从真实需求出发的具身原生技术思想。他提到,一个聪明的机器人大脑要面对三重挑战:输入有误差,输出要经受物理交互的检验,物理世界的任务不会等待模型;能解决机器人的问题,不等于适合机器人。蚂蚁灵波的做法是围绕物理作业设计模型能力,打造具身原生大脑,让机器人想得更清楚、摸得更灵敏、干得更利索。
平均年龄25岁,00后小伙带队拿下首届蚂蚁灵波具身大模型挑战赛最高分

蚂蚁灵波首席科学家沈宇军阐述蚂蚁灵波具身原生大脑 图源:受访对象

会上还公布了开发者生态计划:面向教学与学术创新,邀请20位蚂蚁灵波最有价值专家,共同培养具身智能人才;同时招募40位蚂蚁灵波开发者专家,为技术实践和专业成长提供支持,一起建设开发者生态。

具身智能产业仍在起步阶段。蚂蚁灵波科技CEO朱兴接受包括雷峰网在内的媒体采访时强调,行业眼下迭代很快,具身智能的Scaling Law时刻还没有到来;不过一些技术落地验证加上产学研生态协同,会加快具身智能的进化。

本届挑战赛分两个阶段:线上算法初赛,以及线下48小时真机黑客马拉松总决赛。报名覆盖全球13个国家的1855支队伍、3252名选手,涉及648所高校、科研院所、科技企业及具身智能团队,规模为行业具身大模型挑战赛之最。


本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关 AI 工具

AI 导航
腾讯混元大模型 腾讯混元大模型由腾讯全链路自研,在文本和多模态模型性能方面表现卓越,处于业界领先水平。其混元 API 整合了… 大模型与开发平台 · tencent.com 快手可图大模型Kolors 可图大模型(Kolors)是快手大模型团队自研打造的文生图AI大模型,能够根据用户的文字输入生成风格多样、画… AI 绘画生图 · kuaishou.com 盘古大模型 华为盘古ai大模型官网入口,1100亿密集参数,40TB海量数据精细训练而成 简介 盘古NLP大模型是一项基… 大模型与开发平台 · huaweicloud.com BlueLM蓝心大模型 蓝心大模型官网,vivolm,vivo自研的通用大模型 简介 蓝心大模型(BlueLM ),强大的语言理解能… 聊天对话 · vivo.com 云知声山海大模型 云知声山海大模型是一个多功能、跨领域的智能大模型,它通过集成丰富的知识库和先进的自然语言处理技术,为用户提供… 大模型与开发平台 · unisound.com 子曰” 大模型 子曰是网易有道推出的教育领域垂直大模型,包含基于子曰大模型研发的六大创新应用——“LLM翻译”、“虚拟人口语… 聊天对话 · youdao.com 曹植大模型 曹植大语言模型是国内首个垂直行业专用的自主可控的国产GPT大语言模型,由达观数据研发。这个模型可以准确完成多… 聊天对话 · datagrand.com 西湖大模型 西湖大模型官网,智商情商俱佳的多模态大模型 简介 西湖大模型是西湖心辰开发的多模态大模型,西湖大模型既具备通… 聊天对话 · xinchenai.com

相关推荐 按相关度与热度排序

全部资讯 →
  1. 阿里发布Qwen4并上线Qwen4-Max:Token减半、得分升近28%

    阿里巴巴11月16日正式发布全新一代基座大模型 Qwen4,千问 AI 平台首发上线 Qwen4-Max,API 服务与 Token Plan 同步开放。模型采用基于 Qwen 稀疏注意力(QSA)的全新 MoE 架构,总参数2.4T,具备原生视觉与长程任务稳定交付能力,支持百万上下文,可调用专业工

    来源 AI 开发者社区
  2. 阿里发布Qwen4,千问平台首发Qwen4-Max:Token减半、得分涨近28%

    11月16日,阿里发布新一代基座大模型Qwen4,千问AI平台首发Qwen4-Max,API与Token Plan同步开放。该模型采用Qwen稀疏注意力MoE架构,总参数2.4T,支持百万上下文、原生视觉与长程任务稳定交付,可调用工具并分阶段交付;评测中同档位较上代提升。

    来源 AI 产业速递
  3. 百望股份CEO王强宇:AI财税产品如何落到任务链上

    企业把大模型接进产品之后,新的经营问题才刚刚展开。客户提出一项任务,系统能拿到哪些信息,由谁核准结果,出现例外时如何处理,都会影响AI能否持续投入使用。产品演示中的能力,需要经由完整的服务过程才能转化为客户价值。 王强宇出任百望股份首席执行官(CEO),为观察这项变化提供了一个具体切口:王强宇如何将百望的财税场景积累转

    来源 AI 行业观察
  4. 阿里Qwen4-Max发布:总参数2.4T,单任务平均费用降六成

    新京报贝壳财经讯(记者罗亦丹)11月16日,阿里巴巴发布全新一代基座大模型Qwen4-Max,总参数2.4T,具备原生视觉能力,支持百万上下文。基于创新的模型架构和训练优化,Qwen4-Max以更少的Token消耗实现了更高的性能,在智能体和编程等关键能力项上持续进化:在权威的全球前端编程盲测CodeArena中,Qw

    来源 腾讯网
  5. 清华江瑞课题组发布ProtCell:在摩尔线程S5000上复现预训练

    IT之家 11 月 14 日消息,据摩尔线程公众号,近日,清华大学自动化系江瑞课题组发布了面向单细胞蛋白组的基础模型 ProtCell,完成了论文《ProtCell:a foundation model for single-cell proteomics》。该模型汇集约 3.8 亿个细胞、98 个公开数据集用于预训练

    来源 AI 行业观察
  6. DeepSeek免费额度被指收紧:长对话、每日用量、单次输入均受限

    国产大模型DeepSeek的免费使用额度疑似遭到限制。11月16日,“DeepSeek使用额度已达上限”登上微博热搜。不少用户在社交媒体上反映,DeepSeek对App及网页版的使用额度进行了调整,包括限制长对话、每日使用额度以及单次文字输入长度。截至发稿,DeepSeek尚未对此作出官方回应。值得注意的是,DeepS

    来源 腾讯网
  7. MIT追踪六项技术:自动驾驶、核聚变与认知永生走到哪一步了?

    MIT Technology Review的“The Download”栏目聚焦两大话题:六项曾承诺改变世界的技术如今进展如何,以及人类对“认知永生”的探索。文章提出,衡量技术进步应看真实部署而非宏大宣言;而借助大模型构建数字分身等技术,正让“认知永生”从科幻走向现实,但也带来身份与伦理的深层拷问。

    来源 AI 行业观察
  8. 谷歌 Gemini4Carbon 入驻 WorkBuddy,百万 Token 上下文向 Pro 用户开放

    腾讯 WorkBuddy 国际版于11月15日宣布正式接入谷歌 Gemini4Carbon 大模型,面向复杂推理和长周期任务处理场景提供模型支持,目前仅向 Pro 计划用户开放。 Gemini4Carbon 是谷歌面向长周期智能体工作流推出的模型,适用于复杂知识工作、软件工程、网络安全及科学推理等任

    来源 AI 开发者社区
  9. 蚂蚁灵波朱兴谈具身智能数据:别轻易给数据上量

    21世纪经济报道记者 陈归辞11月16日,蚂蚁灵波科技举办首届开发者大会,并同期举行首届具身大模型挑战赛总决赛。会议间隙,朱兴接受了21世纪经济报道等媒体采访。朱兴谈及对具身数据的观点。他表示,无论是互联网操作视频、Ego 数据(第一人称视角数据)、UMI 数据(无本体数据),还是真机数据、仿真数据,每种类型的数据..

    来源 腾讯网
  10. 腾讯WorkBuddy接入Gemini4Carbon:百万Token上下文向Pro用户开放

    腾讯WorkBuddy国际版11月15日宣布接入谷歌Gemini4Carbon大模型,面向复杂推理和长周期任务,目前仅向Pro计划用户开放。该模型面向长周期智能体工作流,适用于复杂知识工作、软件工程、网络安全及科学推理,支持文本、图像、音频和视频多模态输入,输入输出合计上下文窗口最高达100万Token。

    来源 AI 产业速递
  11. 阿里上线Qwen4-Max:原生视觉+百万上下文,总参数2.4T

    11月16日,阿里巴巴正式上线新一代基座大模型Qwen4-Max,总参数2.4T、激活参数71B,具备原生视觉能力并支持百万上下文,采用基于Qwen稀疏注意力(QSA)的全新MoE架构,每个Token激活参数较上代减少25%。

    来源 凤凰科技
  12. 英伟达7500亿美元融资网被曝:CFO曾力阻,黄仁勋回怼“鹿入车灯”

    《华尔街日报》2026年11月13日调查报道指控英伟达通过向AI初创公司注资、要求其用所得资金购买GPU的方式人为制造芯片需求,布隆博格随后绘制的融资网络规模已超过7500亿美元。英伟达内部,CFO克雷斯(现任代理CEO)曾在8月高管会议上力阻该策略,遭黄仁勋以"鹿入车灯"之语驳斥。该调查触及大模型军备竞赛最脆弱的基础

    来源 AI 科技快讯
  13. NICT OptiMer:不重训模型,如何快速锁定最优数据配比?

    大模型训练中,数据配比调优通常意味着昂贵的从头重训。日本信息通信研究机构(NICT)团队在EMNLP 2026获奖论文中提出OptiMer方法,通过合并“分布向量”来搜索最优数据比例。该方法将试错效率提升15至35倍,且在C-Eval、MMLU等基准测试中得分高于传统混合训练。文章解析了其技术原理、实验效果及在构建日语

    来源 AI 应用前沿
  14. 效率提升 300%,长安汽车数实融合无人化测试系统亮相

    IT之家 11 月 16 日消息,据长安汽车官方,近日召开的 2026 世界智能网联汽车大会上,由长安汽车牵头,国汽智控、赛目科技等共同打造的全球首例车路云一体化数实融合无人化试验场配套测试系统,在“车路云一体化”城市实践与应用展区正式展出。 据介绍,该测试系统以大模型为核心驱动,打通数字仿真与物理场地边界,具备场景智

    来源 AI 行业观察
  15. WorkBuddy国际版接入Gemini 4 Carbon:Pro用户专享

    腾讯旗下AI办公智能体WorkBuddy国际版宣布接入谷歌Gemini 4 Carbon大模型,目前仅向Pro计划用户开放。该模型由谷歌于11月10日开放,主要用于复杂知识工作、软件工程等长周期智能体任务。

    来源 凤凰科技
  16. Agent递归自我改进:不训练模型如何越用越强?

    中科院自动化所与美团等机构联合发布综述,探讨LLM Agent如何在不更新模型权重的前提下,通过优化Prompt、记忆、技能和运行框架实现递归自我改进。文章梳理了“何时改、改哪里、怎么改”三个核心问题,并提出了包含收集、评估、诊断等七步的经验转化生命周期,为理解Agent从单次试错到持续进化的机制提供了清晰框架。

    来源 AI 应用前沿
  17. 安纳智芯AX100流片:单次矩阵方程求解不到100纳秒

    IT之家 11 月 15 日消息,据科技日报从模拟计算芯片公司安纳智芯了解到,该公司自主研发的 AX100 芯片已于 10 月完成流片,这是世界首颗全集成一步求解矩阵方程模拟计算芯片。 经测试,该芯片单次矩阵方程求解时间小于 100 纳秒,单次计算功耗约为 80 毫瓦,完全符合理论仿真与设计预期。 据介绍,我们熟悉的

    来源 AI 行业观察
  18. 谷歌TPU四款齐发:整柜外售,推理每美元性能超GB200五成

    英伟达最近头疼的事儿可不止老黄那一件。 本周内,谷歌祭出了两款新TPU芯片,分别瞄准机密推理和长上下文。算上上半年发布的两款TPU芯片,第八代TPU已经扩到四种配置。 今年,谷歌第一次在同一年内推出四款TPU系统。而谷歌对TPU的野心,可能比外界想象得更大—— 还是今年,谷歌破天荒开始对外销售TPU系统。 量子位从谷歌

    来源 AI 行业观察
向下滚动自动加载更多