

Mirendil完成10亿美元A轮融资,估值约50亿美元
一人3个半月训出基础大模型。

11月13日,美国大模型独角兽Mirendil宣布拿到10亿美元(约合人民币66.72亿元)A轮融资,消息在11月16日传出。本轮估值官方没有披露,不过多家媒体引用a16z内部信息称,其估值大约为50亿美元(约合人民币333.59亿元)。
这轮融资由Kleiner Perkins和Clearlake Capital共同领投,Battery Ventures、Doerr Capital、Gil & Co、谷歌、M13、Pear VC、S32等机构也参与了进来。
把今年6月的种子轮算上,Mirendil累计融资额已达12亿美元(约合人民币80.06亿元)。
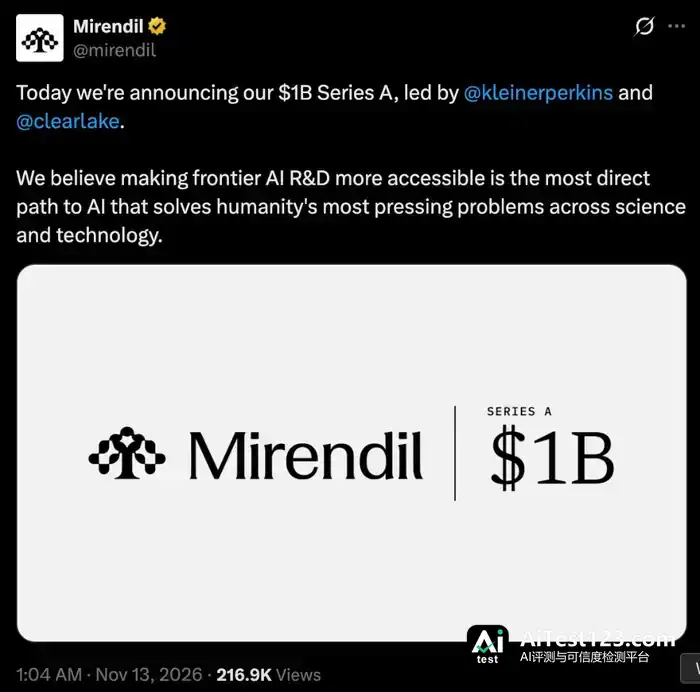
Mirendil官宣融资(来源:X)
这家公司总部设在美国旧金山,2026年6月才走出隐身状态。创始团队包括 Anthropic前员工Behnam Neyshabur、Harsh Mehta,xAI前研究员Shayan Salehian,以及前OpenAI学生研究员Tara Rezaei。
此前接受采访时,Behnam Neyshabur这样描述他们的方向:“我们正在做的产品有点像服务科学AI的AI(AI for AI for science),而非科学AI(AI for science)。”换句话说,Mirendil卖的是工具,帮科研人员自己去开发模型。
2026年10月21日,该公司推出首个基础模型Mirendil-Base。按官方说法,这个模型由1名员工借助智能体完成,从零仓库起步做预训练,前后只花了3个半月,总算力成本不到1000万美元(约合人民币6671.75万元)。
一家由Anthropic前员工创办的公司做到这个程度,是不是已经实现了RSI(Recursive Self-Improvement,递归自我改进)?
一、两轮融资相隔141天,还与谷歌云签下超1亿美元算力大单
成立至今,Mirendil接连完成2轮融资,合计12亿美元(约合人民币80.06亿元)。2026年6月25日,公司官宣2亿美元(约合人民币13.34亿元)种子轮融资,a16z和Kleiner Perkins领投,英伟达等机构跟投。《华尔街日报》报道称,Mirendil当时估值达到10亿美元(约合人民币66.72亿元)。
算力方面,2026年8月,Mirendil与谷歌云签下多年战略合作协议。
双方披露的信息显示,合作金额超过1亿美元(约合人民币6.67亿元),算力资源主要覆盖Google TPU与NVIDIA GPU两类。对Mirendil来说,这份协议为后续大规模模型预训练和智能体实验提供了稳定的基础设施。
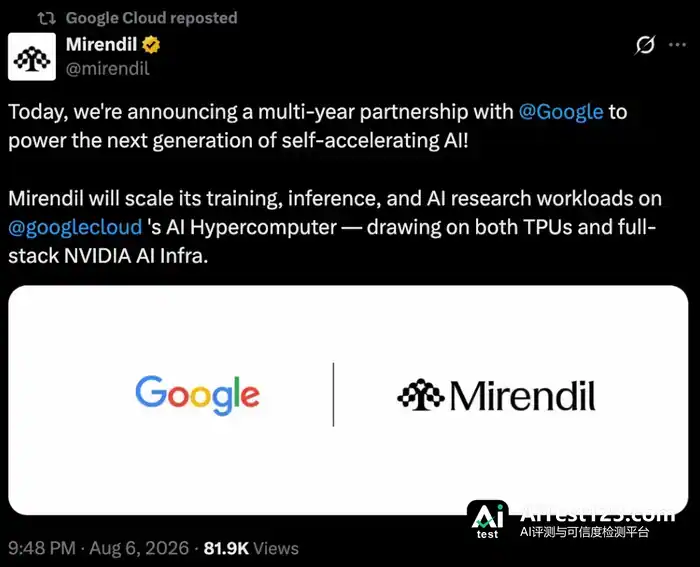
Mirendil官宣合作(来源:X)
二、预训练3个半月完成,99%以上编程工作由智能体承担
2026年10月21日发布的Mirendil-Base,参数规模约为1000亿至5000亿。
官方称,该模型由一名研究员在智能体辅助下从零完成预训练,耗时仅3.5个月,总算力成本低于1000万美元(约合人民币6671.75万元)。这笔成本涵盖实验、智能体token消耗与数据处理。
编程工作里,智能体承担了超过99%的部分,包括基础设施搭建、算法选择、数据收集与迭代;人类则负责方向决策和结果判断。
之后,Mirendil在Mirendil-Base基础上做后训练,又推出了Fern 0.1。该模型参数规模约为0.1万亿至0.5万亿,上下文窗口最高支持约1000万token。
Fern 0.1瞄准的是高容量任务,比如调试训练日志、分析完整智能体轨迹、审计预训练数据。目前该模型还处在早期访问申请阶段。
更大参数的版本也在同步推进,Mirendil给出了进度:Mirendil-Base-Large(约5000亿至2万亿参数)完成约80%,Mirendil-Base-XL(约2万亿至10万亿参数)完成约20%。
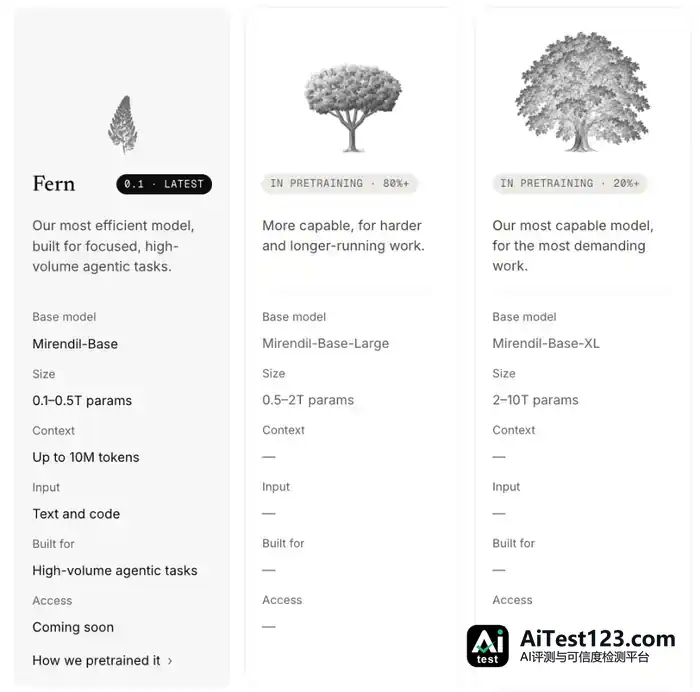
预告模型进度
核心产品方面,多智能体研发平台Lor于2026年10月28日进入私测。Mirendil透露,公司内部日常研发已经全面跑在Lor上。
这个平台能同时调度数百个智能体写代码、跑实验,算力资源的申请与释放自动完成,智能体可以连续工作数天甚至数周。
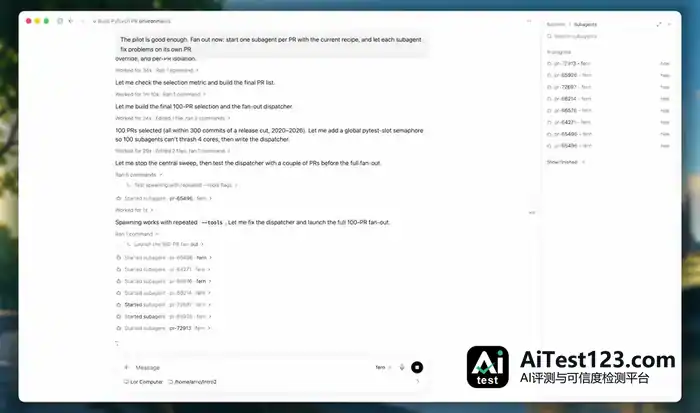
一次实际运行中,Lor平台上的智能体围绕100个PyTorch拉取请求搭建出对应环境:102个智能体参与,平均每个耗时8分钟。
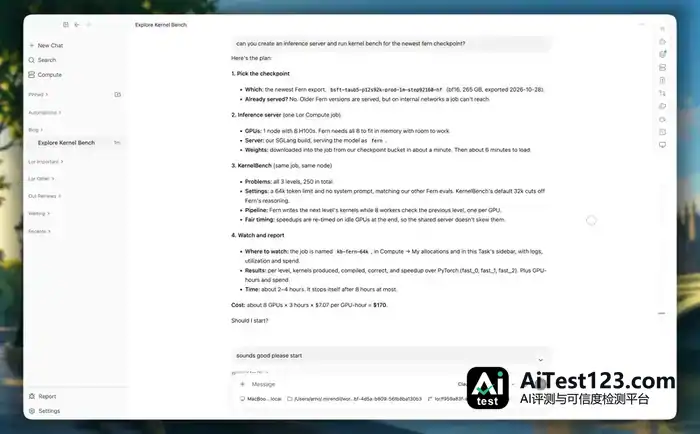
计算资源由智能体按需申请和分配,它们对自己启动的每台虚拟机、每个节点都握有完整控制权。
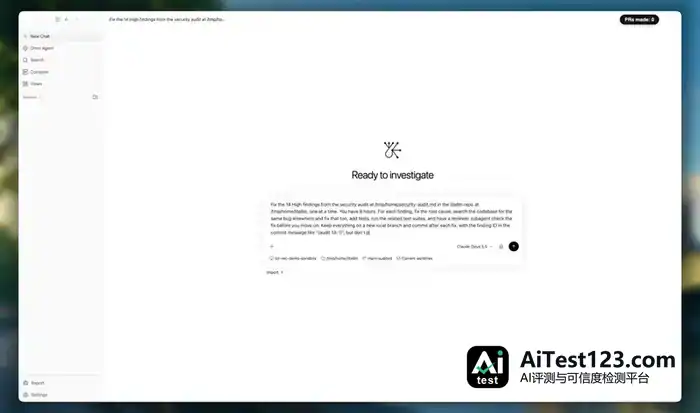
有一回夜间运行,Lor里的智能体揪出了LiteLLM的安全漏洞,修复工作在天亮之前就完成了。
Lor把智能体和它干活的设备拆开来看。跑什么由智能体决定,每条命令再由Lor发到用户选定的设备上。智能体的操作范围限于已添加的机器,用户也能随时把某台设备移走。

智能体与设备各自独立,互不绑定。
眼下Lor提供macOS、Linux与Web端,Windows、iOS和Android版本还在计划中。平台可接入Kimi、DeepSeek等开源模型,也兼容Claude、GPT、Gemini、Grok等前沿闭源模型,Mirendil自有模型同样在支持之列。
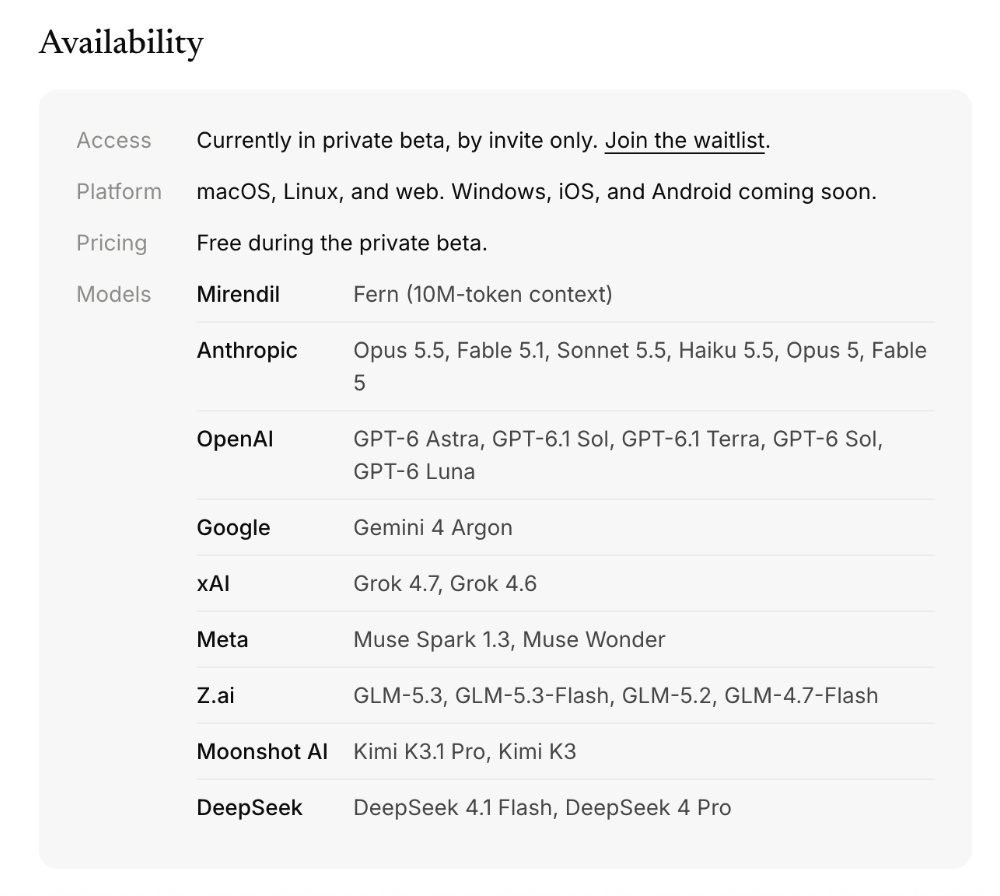
可接入的模型范围。
三、创始团队来自Anthropic、xAI、OpenAI,模型推理、自动化研发与工程落地各有其人
Mirendil的创始团队由四名联合创始人组成,核心成员大多出身Anthropic、谷歌DeepMind、xAI与OpenAI,在模型推理、自动化研发、工程落地和早期研究上都有直接经验。
联合创始人兼CEO Behnam Neyshabur的本科与硕士读于谢里夫理工大学,计算机科学博士则在丰田工业大学芝加哥分校取得。之后他跟随杨立昆,在纽约大学与普林斯顿高等研究院做博士后研究。
2019年到2024年,Behnam在谷歌DeepMind任高级研究科学家,联合领导Blueshift团队,主攻基础模型推理能力的提升。该团队直接参与了首个在数学问题上表现突出的语言模型Minerva的开发,并负责早期Gemini模型的推理能力建设,后续工作也为Gemini 1.5与Gemma 2的推理提升出过力。
2024年末至2025年12月,Behnam在Anthropic联合领导Discovery团队,目标是把能承担长期推理与科学任务的“AI科学家/工程师”造出来。
学术方面,他是ICLR 2021论文《Sharpness-Aware Minimization》(SAM优化器)的联合作者,这项技术被大量用于提升深度学习模型的泛化能力,相关研究在谷歌上的引用量已超过5万。
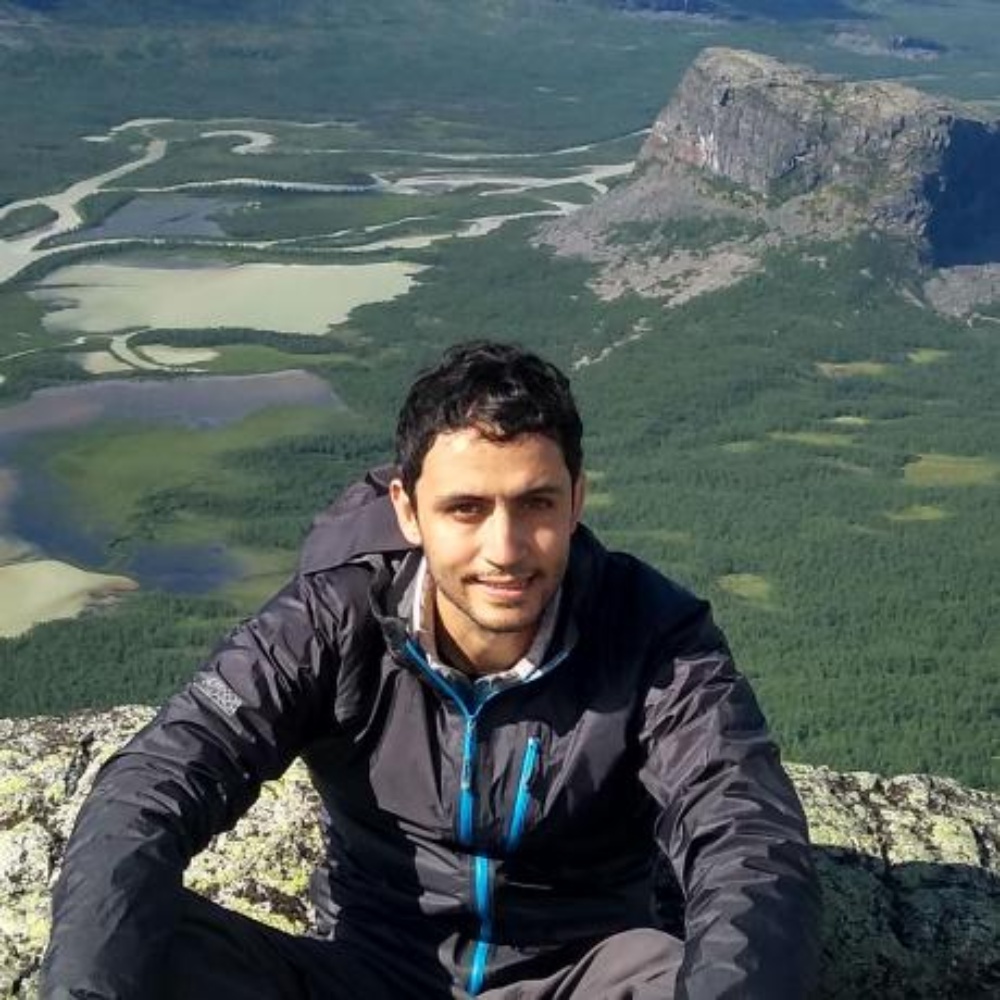
Behnam Neyshabur,图源Github。
联合创始人兼CTO Harsh Mehta与Behnam从谷歌一路共事到Anthropic。他毕业于印度理工学院瓜哈提分校,此前在谷歌搜索与谷歌DeepMind干了近10年,参与Gemini系列模型研发,在长序列建模、状态空间模型、学习率调度等方向都有论文发表。
2024年至2025年12月,Harsh在Anthropic任高级研究科学家,牵头搭起公司内部自动化AI研究平台(autoresearch)的第一版。该平台想用模型自身加快预训练与实验迭代,也正是Mirendil当前技术方向的直接前身。
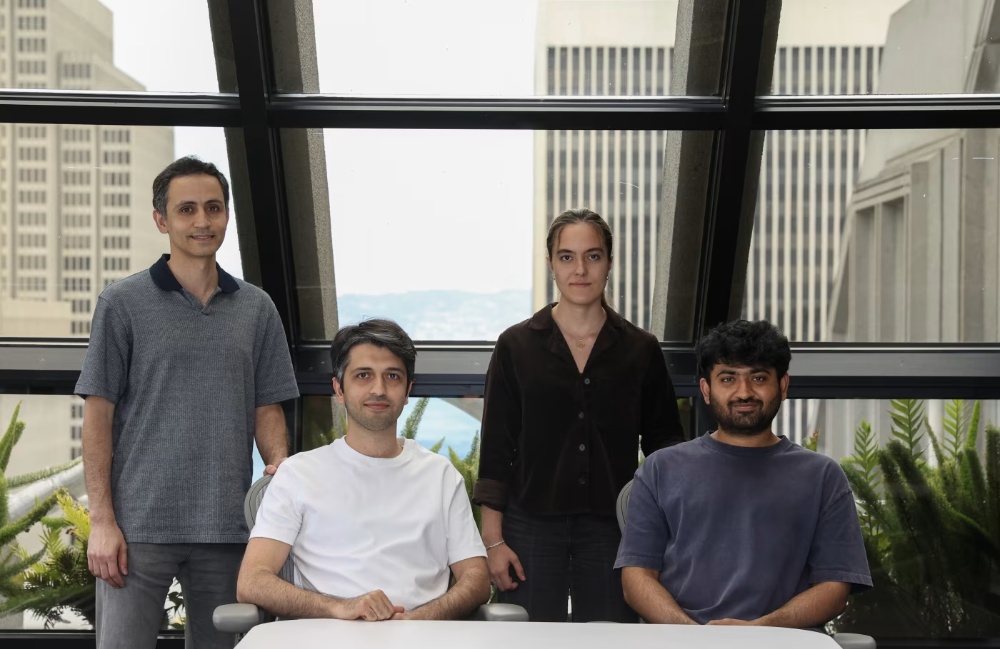
Mirendil创始团队合影,最右侧为Harsh Mehta,图源wsj。
联合创始人Shayan Salehian本科出自谢里夫理工大学,硕士在加州大学河滨分校就读。
2018年至2024年,他先后在Twitter与X做机器学习工程师,参与时间线推荐、模型服务与大规模系统工程。
2024年10月至2026年初,Shayan加入xAI,参与Grok系列模型的后训练、推理、记忆系统、编码基础设施与智能体相关工作。

Shayan Salehian,图源LinkedIn。
联合创始人Tara Rezaei(全名Tara Rezaei Kheirkhah)是团队里最年轻的一位。2021年她代表伊朗参加国际天文与天体物理奥林匹克(IOAA),拿到银牌,之后进入麻省理工学院读电子工程与计算机科学。在校期间她在OpenAI做学生研究员,研究方向涉及模型可解释性与程序合成。
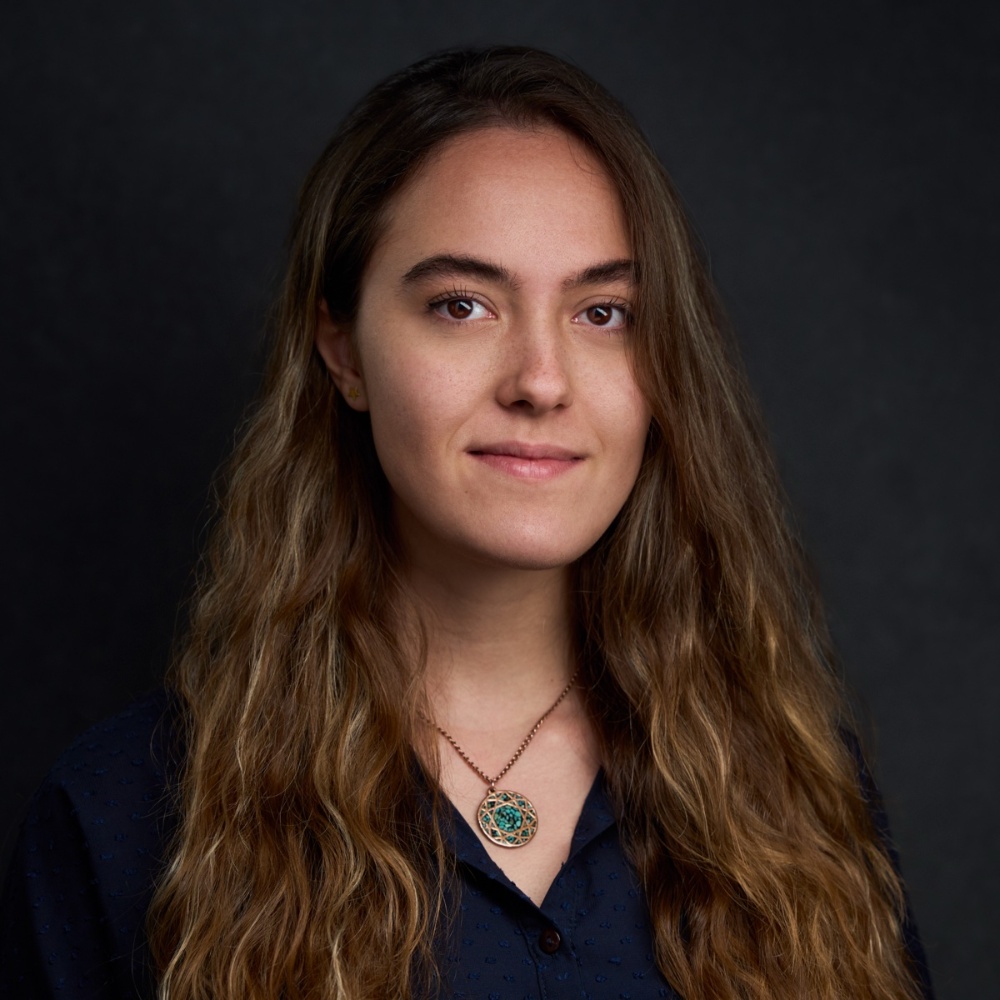
Tara Rezaei,图源Tara个人主页。
结语:Agent重新定义了AI研发的门槛,资本把赌注压在RSI上
眼下,前沿AI能力基本攥在少数实验室手里,它们握着海量算力、顶尖人才,还有一套完整的实验流程。Mirendil想靠Agent撬开这个格局:过去预训练和实验迭代要几十号人干上几个月甚至几年,现在被压到“一个人、几个月、千万美元级算力”的量级。
药物研发、材料科学、机器人这些领域的专业实验室,今后不必凑齐一整支预训练队伍,也能做接近前沿水平的模型迭代。一批“领域专用小实验室”很可能就此冒出来。资本半年内两次下注,看中的或许正是这一点。
不过,Mirendil眼下最拿得出手的成果还停留在公司内部实验。外部用户的实际体验怎么样?前沿大模型迭代这么快,技术壁垒又该怎么建?这些都是这支创业团队绕不开的问题。















