中科曙光万伟:超大规模智算集群,高速互连是关键
中科曙光高速网络互联产品部总工程师万伟在会上分享超大规模智算集群高速网络架构设计与工程实践,提出高速互连是算力基础设施实现规模扩展的关键。中科曙光将超节点内部互连与超节点之间的组网相结合。大会期间,中科曙光还获评“2026中国算力领军企业”,scaleFabric高速网络入选“2026中国算力应用典型案例”。超大规模集
大模型训练时,计算任务要被分派到数量众多的设备上。各台设备一边算自己的部分,一边通过网络互换数据,训练才能向前推进。一旦数据传输速度跟不上计算,一些设备只能干等着,整个任务的耗时就被拉长。参与运算的设备越多,怎样让设备少等,就成了超大规模智算集群建设绕不过去的难题。
11月15日,第八届中国超级算力大会(ChinaSC 2026)暨中国智能计算产业联盟理事会年会在北京召开。中科曙光高速网络互联产品部总工程师万伟到场,围绕超大规模智算集群高速网络架构设计与工程实践作分享。他提出,算力基础设施要实现规模扩展,高速互连是关键。
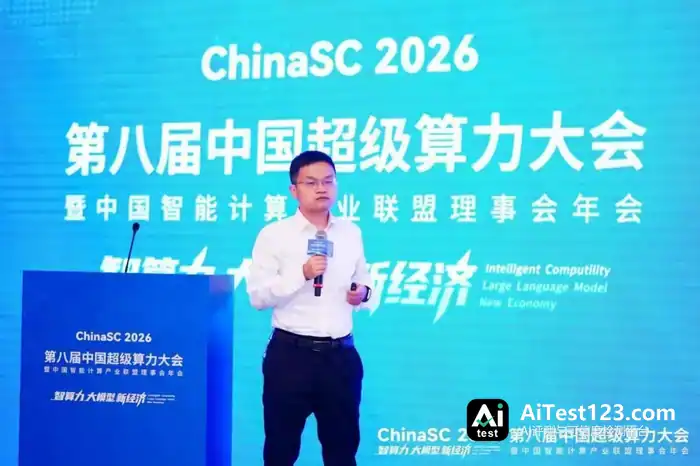
这一判断对应着集群建设中的现实要求:计算设备增加的同时,网络的连接、传输与管理能力也得跟上,新增的算力才能真正落到实际任务里。
集群越铺越大,连接方式也得升级
大会发布的《万卡级智算集群网络技术发展与国产化研究报告》,是首份专门研究万卡级智算集群网络技术发展的报告。报告提到,集群规模持续扩大,网络互联、存储吞吐与资源调度等环节能不能协同好,越来越关键。对建设者来说,光买设备不够,还得想清楚设备之间怎么配合。网络设计决定数据传输走什么路径,交换设备的连接能力则决定集群能按什么架构扩展。
中科曙光的做法是把超节点内部互连和超节点之间的组网接起来。超节点可以理解为一批紧挨着连接的计算单元,内部靠低时延连接应付频繁的数据交换;多个超节点之间,再用高速网络拉起更大范围的协作。局部通信和整体扩展分开考虑,不同范围的连接各自匹配相应的任务需求。落到具体设计上,供电散热、布线以及维护条件都要顾及,才符合实际建设的要求。
这样的架构,得有网络芯片来提供连接和交换能力。交换芯片的端口数量,决定一台交换设备能挂多少设备;数据处理能力则决定大量通信同时涌来时,交换设备能不能及时转发。中科曙光自研的scaleFabric高速网络把网卡芯片、交换芯片与组网架构捏在一起,采用多平面组网,在单一子网内实现大规模互连,并按任务特点和网络连接关系优化通信。芯片和架构配合好了,连接更多计算资源时,设备之间的协作效率才守得住。
数据传得稳,计算设备才少空等
设备连上之后,网络要过的下一关,是海量数据能不能及时、完整地送到。大模型训练中,有些计算步骤要等相关节点的数据凑齐才能往下走。传输过程中一旦出现拥塞,或者数据丢了要重发,等待时间就上去了。训练任务反复交换数据,这些通信开销会一点点累积,拖累计算资源的实际利用效率。
scaleFabric走的是无损传输路线,靠流量控制和链路层重传等手段保证传输可靠,把传输异常对任务的影响压下去。流量控制管的是协调数据发送与接收,链路层重传管的是链路传输中冒出来的错误。两者再配上通信优化,目标都是让数据更稳地抵达计算节点,少让通信问题造成等待。
数据传输之外,通信发起这个过程本身也有开销。面向大模型训练与推理,scaleFabric借助IBGDA等技术让GPU直接发起网络通信,省掉CPU参与通信调度带来的开销,节点间的通信等待随之缩短。目前scaleFabric已完成DeepEP通信框架适配,为大模型多节点协作和Token生成效率提升提供支持。高速网络的优化由此进一步对接应用软件,帮实际任务把硬件给的通信能力用起来。
从研制网络到工程运行,拼的是完整系统能力
通信效率得在长时间运行中保持稳定,链路出了故障也必须及时处理。scaleFabric支持毫秒级链路切换,路由恢复时间不会随集群规模变大而拉长。这项能力关乎网络扩展后的实际可用性。连接规模继续往上走,网络仍要能及时恢复通信,局部故障对并行任务的影响才会小。
故障恢复之外,运维人员还得准确掌握网络状态。FabricView高速网络管理平台把配置部署、健康筛查与运行监测合到一起,支持任务上线前筛出异常节点,任务执行中定位繁忙链路和异常端口。应用跑慢了,这些信息能帮运维人员判断网络有没有问题,把排查范围收窄。网络硬件与管理软件就这样接上,一起支撑集群的日常运行。
中科曙光的相关网络设计已在曙光8000上得到工程验证,scaleFabric与曙光8000的工程实践也被上述研究报告收录。大会期间,中科曙光获评“2026中国算力领军企业”,scaleFabric高速网络入选“2026中国算力应用典型案例”。两项荣誉分别对应行业对中科曙光算力系统研制能力与高速网络应用成效的认可,从自主研发到工程应用的技术积累也有了具体呈现。
超大规模集群建设,对高速网络提的是一整套要求。连接规模扩大后,应用通信能不能保持高效、故障能不能及时处理、网络状态是否便于管理,都会影响算力投入的最终效果。中科曙光把这些要求贯穿到芯片研制、架构设计与工程运行中,为国产智算集群的持续扩展提供系统性支撑。对使用者来说,这些技术的价值最后要落到计算任务能不能高效、稳定地完成上。