李飞飞World Labs发布Frameboy:单图生成3D世界,最高15帧实时漫游

资讯 AI 行业观察 作者:爱范儿 全文 2586 字 · 约 7 分钟读完 配图 7 张 分类模型发布世界模型视频生成

点下生成按钮,然后对着转圈的进度条干等好几分钟。过去玩 3D 世界模型或者视频生成的朋友,估计都被那种漫长的渲染折磨得没脾气了。 就在今天,李飞飞创办的 World Labs发布了一款名为 Frameboy 的研究预览版 Demo,直接把自家的自回归世界模型 Atlas 拉进了实时交互时代。 官方博客🔗 https:/

所属频道 模型发布视频图像生成

按下生成键,盯着转圈的进度条一等就是好几分钟。以前玩 3D 世界模型或视频生成的人,多半都被这种漫长渲染磨到没脾气。

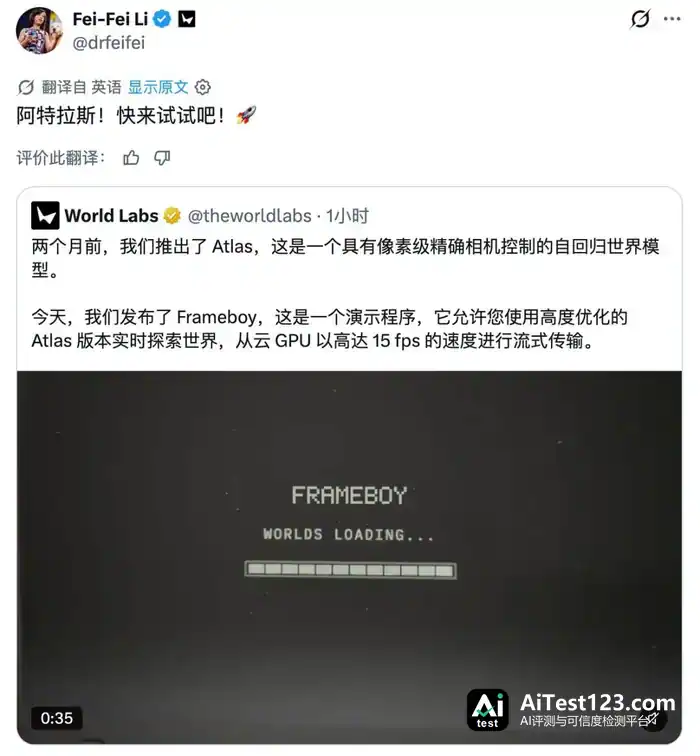
李飞飞创办的 World Labs 今天推出研究预览版 Demo,名字叫 Frameboy,把自家自回归世界模型 Atlas 带进了实时交互阶段。
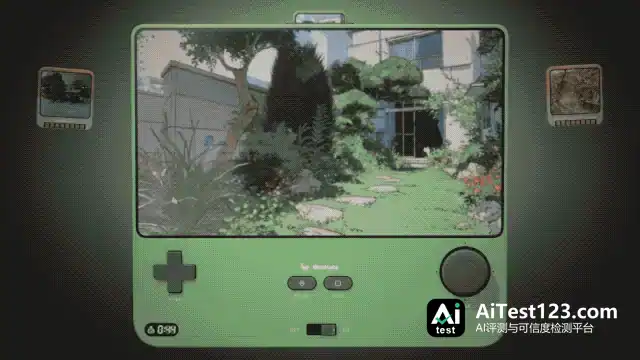
李飞飞World Labs发布Frameboy:单图生成3D世界,最高15帧实时漫游(配图 1)

官方博客🔗 https://www.worldlabs.ai/blog/atlas-realtime

打开浏览器就行,云端 GPU 以最高 15 fps 的帧率把画面实时串流过来,镜头可以像打游戏一样自由操控,在单张图片生成的 3D 世界里随意走动。

走错方向也好,试了个烂点子也好,试错成本几乎为零,鼠标一划换个角度就能接着探索。

今年 9 月底 AMD 宣布以 82 亿美元(约合人民币 550 亿元)全股票收购 World Labs,这次更新是收购之后李飞飞这支空间智能团队交出的又一份技术答卷。

把世界模型装进复古掌机,单张图实时跑出 15 帧

要说清这次更新,得先提两个月前刚亮相的 Atlas。

Atlas 是自回归世界模型,当时最大的卖点是逐帧生成画面,并支持像素级精度的相机视角控制。拿一张图脑补出虚拟 3D 世界,或者用几张多视角照片还原真实地标、查看建筑工地进度、给电影勘景,它都能做。

问题是太慢了。

每调一次机位,都得等几十秒甚至好几分钟才看到渲染结果,创作者搭场景、规划运镜时难免束手束脚,每按一次生成键都像开盲盒。
李飞飞World Labs发布Frameboy:单图生成3D世界,最高15帧实时漫游(配图 2)

为了缓解世界模型漫长的生成等待,团队对 Atlas 做了深度推理优化,并推出搭载这一优化版模型的实时交互 Demo Frameboy,复古掌机式的造型很容易让人想到经典的 Game Boy。

画面生成速度提升到最高每秒 15 帧之后,用户已经明显感觉不到点击生成那个割裂的动作。

在浏览器里推拉摇移相机,云端就会源源不断地把新视角画面实时推流到屏幕上。

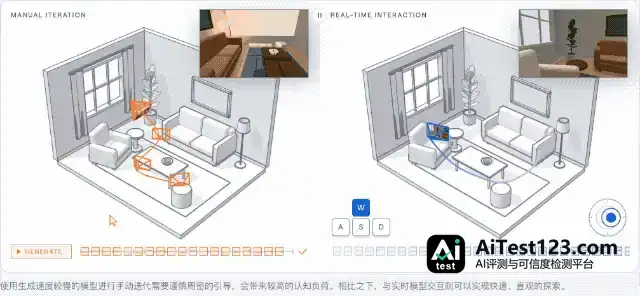
官方放出的客厅对比演示里,以前用慢速模型手动迭代,用户得小心翼翼地在房间里点四个关键帧机位,按下生成等视频出来,发现角度不对再拖拽重试,来回折腾好几轮。
李飞飞World Labs发布Frameboy:单图生成3D世界,最高15帧实时漫游(配图 3)

到了 Frameboy 的实时模式,直接开着虚拟相机在房间里转圈就行,视野所及之处画面同步实时更新。

熟悉 World Labs 去年研究预览项目 RTFM 的人,可能会觉得复古掌机形态有点眼熟。

不过和当年那个轻量级帧生成模型相比,如今的 Atlas 模型规模大得多,吞下的数据量高出好几个数量级,能力边界也完全不同了。

去年的 RTFM 主要只能在已有几个视角之间做插值过渡;现在的 Atlas 只喂一张静态图片或一段文字描述,就能从零把周边场景脑补出来,放进 Frameboy 的空间上下文里任人交互探索。
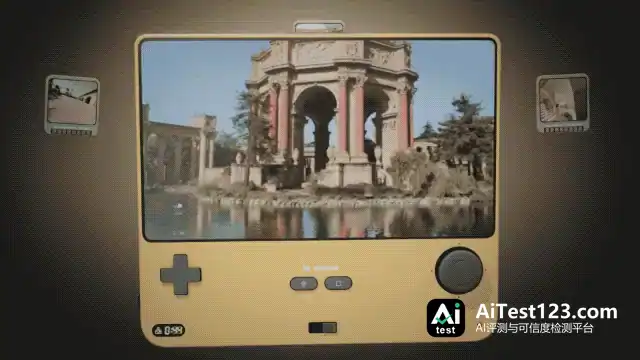
李飞飞World Labs发布Frameboy:单图生成3D世界,最高15帧实时漫游(配图 4)

多视角新视图合成能力也完整保留并做了升级,输入几张真实世界名胜古迹的多角度照片,就能在浏览器里直接开启一场赛博实景漫游。

上传图片,亲手搭个 3D 游乐场

只在官方预设的几个场景里逛,显然不够过瘾。

为了让大家亲手搭出自己的 3D 世界,World Labs 把实时串流能力塞进网页端应用 Viewfinder,做成实时渲染叠加模式,目前处于封闭测试阶段,候补名单已经开放申请。

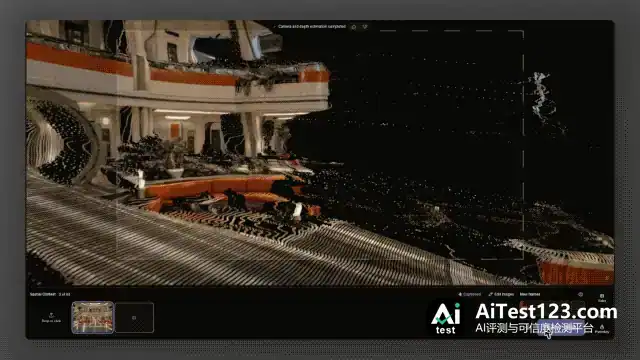
在 Viewfinder 里,可以用自己上传的图片当起点,操控虚拟相机一步步往外走,一帧一帧把整个 3D 空间搭建起来。

Atlas 每生成新的一帧,都会同步输出色彩与深度信息,帮用户在视觉上对齐整个三维空间结构。
李飞飞World Labs发布Frameboy:单图生成3D世界,最高15帧实时漫游(配图 5)

场景主体大致搭好后,唤出 Frameboy 叠加层只要一下,先前逐帧构建的静态工程立刻转为实时串流的 3D 游乐场。

团队给未来定的方向很明确:让 Atlas 这类世界模型充当下一代的生成式渲染器。
李飞飞World Labs发布Frameboy:单图生成3D世界,最高15帧实时漫游(配图 6)

算力门槛这块,官方在博客末尾并没有绕开。

Frameboy 眼下只能跑在云端的高性能 GPU 服务器上。跟传统本地渲染相比,这笔开销实在谈不上便宜。

可翻翻计算机图形学的历史,哪项颠覆性技术刚出来时不是又慢又贵。底层硬件和软件算法一起往前走,今天贵得吓人的云端实验室玩具,早晚会变成白菜价的普及工具。

550 亿联姻苏姿丰,加速贴近底层硬件

软硬协同降本提速这件事上,World Labs 眼下算是找对了靠山。

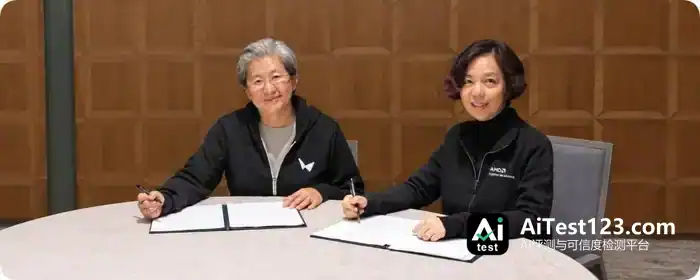
9 月 28 日,也就一个多月前,芯片巨头 AMD 官宣了一笔重磅收购协议:拟以 82 亿美元的全股票交易,把成立仅两年的 World Labs 收入囊中。

交易预计今年底完成交割,将直接创下 AMD 历史上仅次于赛灵思的第二大收购纪录。

这家总部位于旧金山的明星独角兽由李飞飞与 Justin Johnson、Ben Mildenhall、Christoph Lassner 联合创办,前一轮融资时估值还是 50 亿美元。

按收购安排,交易完成后李飞飞将正式出任 AMD 执行副总裁兼首席科学家,直接向苏姿丰汇报;原有研发团队完整保留,继续由 Justin Johnson 和 Ben Mildenhall 带队死磕空间模型与物理 AI。
李飞飞World Labs发布Frameboy:单图生成3D世界,最高15帧实时漫游(配图 7)

当时外界还在议论:一家卖芯片的硬件大厂,为什么肯花 550 亿人民币买一支研究 3D 世界模型的算法团队?

如今结合 Frameboy 对推理速度的极致要求来看,两边的考量就再清楚不过了。

苏姿丰盯上的,是大语言模型之后的下一个必争之地——涵盖机器人仿真、空间理解与三维重建的物理 AI。

收下 World Labs,AMD 就能第一时间摸清下一代世界模型的真实算力负载特征,反过来指导自家 GPU 架构、AI 芯片和 ROCm 软件栈的路线规划,在机器人与空间计算赛道上跟英伟达正面掰手腕。

李飞飞团队这边,正如她在收购公告中所言,下一代 AI 需要模型研究、系统与算力的紧密协同。

过去在云端跑个实时世界模型,还得心疼昂贵的 GPU 账单;如今直接和自家芯片团队贴身打磨硬件与底层算子,把实时生成式 3D 渲染真正塞进千家万户的终端设备,显然又近了一大步。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. Gemini Omni 1.2 Flash上线:原生15秒视频,价格降30%

    感谢IT之家网友 愚公骑马、乌蝇哥的左手 的线索投递! 谷歌正式推出 Gemini Omni 1.2 Flash 视频生成模型,并在 Gemini API 与 Gemini for business 平台全面开放使用。 新版模型实现了原生 15 秒视频生成、多轮对话式编辑、更强的参考遵循能力,同时较 1.1 版本降价

    来源 AI 开发者社区
  2. 谷歌Omni 1.2 Flash上线:视频时长增至15秒,API降价约30%

    人工智能视频生成与编辑领域迎来重要更新。Google DeepMind 正式发布了全新的多模态视频生成模型——Gemini Omni1.2Flash。该模型在生成时长、画面一致性、多轮对话修改以及 API 价格上均带来了全方位的重大升级。 核心性能升级:时长翻倍、一致性优化与多轮对话编辑 在核心功能方面,Gemini

    来源 AI 开发者社区
  3. 谷歌推Gemini Omni 1.2 Flash:15秒视频可对话编辑,价格降30%

    谷歌周四正式推出视频生成模型Gemini Omni 1.2 Flash,支持原生15秒视频生成和多轮对话编辑,720p视频生成价格降至每秒0.07美元,较上一代降低30%。模型通过Gemini API、Google AI Studio、Flow等多个渠道陆续推出,生成视频带SynthID水印。

    来源 凤凰科技
  4. Pangram Image 1.0发布:99.96%准确率识别AI图像

    IT之家 11 月 6 日消息,Pangram Labs 是一家专注人工智能生成内容识别的 AI 实验室。其在本月 4 日正式发布了 Pangram Image 1.0 模型。该模型可通过热力图定位 AI 生成的内容。 Pangram Labs 利用 12 种前沿 AI 图像生成器,基于 100 张真实图片制作了一个

    来源 AI 行业观察
  5. Gartner发布2027年十大技术趋势:可抛弃型应用入选

    21世纪经济报道记者 孔海丽 AI降低开发成本后,软件即用即开发、用完即弃的做法可能越来越常见。 近日,Gartner发布了2027年十大战略技术趋势,将“可抛弃型应用”列入名单,大型定量模型、世界模型、AI上下文平台和智能体身份等关键词也在其中。 Gartner研究副总裁高挺在采访中解释,上一年度的重点是如何构建和应

    来源 腾讯网
  6. OpenAI发布GPT-6 Cyber:攻防能力双升,风险评级升至Critical

    AI 在网络安全领域的能力,又迎来了一次重大升级。 就在刚刚,OpenAI 正式发布新一代网络安全模型GPT-6 Cyber,能够自主发现软件漏洞、验证漏洞是否可以利用,并协助研究人员开发修复方案。 相比上一代 GPT-5.6 Cyber,新模型在漏洞利用测试中的成绩相对提升约 51%,同时大幅改善了执行安全任务时的指

    来源 AI 行业观察
  7. 腾讯云MaaS:混元评测、TI-ONE推理与Token成本三线并进

    过去几年,大模型厂商发布新产品,总少不了一张密密麻麻的 Benchmark 成绩表。但当模型真正进入工作场景,评判标准就没那么简单了。 今年 3 月,一项研究分析了 43 套 Agent 评测基准,涉及超过 7.2 万项任务,并与美国劳动力市场的 1016 种职业进行对照。结果发现,现有评测高度集中于编程等计算机相关任

    来源 AI 行业观察
  8. Pangram 正式发布其 AI 图像检测模型,准确率达 99.96%

    IT之家 11 月 6 日消息,Pangram Labs 是一家专注人工智能生成内容识别的 AI 实验室。其在本月 4 日正式发布了 Pangram Image 1.0 模型。该模型可通过热力图定位 AI 生成的内容。Pangram Labs 利用 12 种前沿 AI 图像生成器,基于 100 张真实图片制作了一个 1

    来源 腾讯网
  9. OpenAI发布GPT-6 Cyber:Firefox挖出81个高危漏洞,评级升至Critical

    人工智能安全领域迎来重磅突破。OpenAI 于2026年11月6日正式发布了迄今为止最强的网络安全专用模型 —— GPT-6Cyber。该模型在软件漏洞的主动发现、自动化验证以及漏洞利用开发等核心能力上实现了质的飞跃,在实战测试中交出了一份震撼业界的亮眼成绩单。 实战表现惊艳:Firefox 挖出81个高危漏洞,Lin

    来源 AI 开发者社区
  10. 报告:中国模型领跑美国企业开源模型支出,Kimi占61%

    36氪获悉,硅谷知名风险投资机构门罗风投(Menlo Ventures)近日发布的《2026年企业AI现状报告》显示,美国企业用于开源模型的支出中,89%付给了中国模型。其中,Kimi占61%。报告基于对近400名美国企业人工智能业务负责人的调研,受访者负责的AI支出合计超过40亿美元。

    来源 AI 行业观察
  11. OpenAI发布网络安全模型:够不够用,谁说了算?

    OpenAI发布新的网络安全模型,正值AI实验室保护数字基础设施的能力受到审视。本文梳理该发布的时间背景、可能能力与局限,并分析AI攻防双用途带来的治理难题。结论是:单一模型难以回答信任问题,透明度、独立评测和跨机构协作才是关键。

    来源 AI 科技快讯
  12. Thinking Machines推Inkling 2 Small:定制训练开放,估值冲2600亿

    智东西(公众号:zhidxcom)作者 | 孙小雯编辑 | 程茜智东西11月6日消息,今日,前OpenAI首席技术官米拉·穆拉蒂创办的美国AI创企Thinking Machines Lab发布通用多模态模型Inkling 2 Small,并将于下周开放权重。该模型重点改善定制训练表现,支持开发者用自己的数据进一步训练,

    来源 腾讯网
  13. Scientist World:千篇论文如何变身AI科研实验场?

    AI Scientist 已经能够阅读科研文献,但要在已有研究的基础上继续探索,仅仅读懂论文还不够。人类科学家可以从论文中提炼问题、借鉴方法,再搭建实验检验新的想法,AI Scientist 同样需要能够实际运行实验、验证想法的研究环境。 这样的环境既要保留论文中的研究问题,也要提供可运行的方法和衡量改进的标准。然而,

    来源 AI 行业观察
  14. Goodfire推Mechanistic Shaping:RL奖励作弊率100%降至2%

    Goodfire于2026年11月5日发布Mechanistic Shaping论文,通过神经元探针直接修改训练目标,将原本100%奖励作弊的RL模型诚实率提升至96-98%。该方法同时应用于视觉模型,阻止其依赖伪相关特征。Time杂志同日报道,此为训练阶段实时利用可解释性信号压制reward hacking的首个可复

    来源 AI 科技快讯
  15. 英伟达发布Realtime-Bench:GPT-6-Astra实时任务成功率仅44%

    人工智能大模型在文本创作、代码编写和图像生成等静态任务上已经展现出惊人的实力,但在瞬息万变的实时交互场景中,它们的真实表现究竟如何?近日,英伟达携手得克萨斯大学奥斯汀分校(UT-Austin)等顶尖机构正式发布了全新的实时交互任务基准——Realtime-Bench。该基准的诞生,旨在为评估人工智能在动态环境下的综合表

    来源 AI 开发者社区
  16. GPT-6 Astra领跑BioBasicsBench:100项湿实验室任务得分66.7%

    2026年11月6日,OpenAI联合酶设计公司Ligo发布BioBasicsBench,这是一个包含100项湿实验室任务的评测基准,使用真实实验原始数据而非论文精修图。七个模型参与测试,GPT-6 Astra以xhigh推理设定下66.7%的平均得分居首,但OpenAI自己也承认,这一分数不意味着模型已能在实验室做出

    来源 AI 科技快讯
  17. 基元律动NeoHorse-1.5内测:1250亿参数RSI智能体模型

    智东西作者 | 孙小雯编辑 | 程茜智东西11月5日消息,今日,北京大模型创企基元律动(TokenRhythm)发布面向智能体任务的大模型NeoHorse-1.5-Flash Preview,并开放内测。据基元律动透露,该模型基于Qwen3.8-Flash进行递归自我改进(RSI)迭代,主模型参数为1250亿,激活参数

    来源 腾讯网
  18. OpenAI重置按钮换人管?Tibo转岗做安全,Andrew接手产品体验

    Tibo 不发糖了?因为Open AI 的内部安全烂透了 作者丨高允毅 编辑丨岑 峰 OpenAI 的“赛博义父”好像换人了?最先发现不对劲的是敏锐的网友。 11 月 4 日,Codex 团队的产品负责人 Andrew Ambrosino 发帖称,关于 OpenAI 产品的任何意见都可以反馈给他。 Tibo 在下面跟了

    来源 AI 行业观察
  19. 蚂蚁百灵Ling-3.2-flash发布:560B参数,API前两周免费

    IT之家 11 月 6 日消息,蚂蚁百灵官方团队今日宣布推出原生多模态模型 Ling-3.2-flash,拥有 560B 总参数、25B 激活参数、1M 上下文窗口。该模型从架构层面原生融合视觉与语言能力,支持图像、文本与视频输入,重点强化复杂视觉理解、多模态长程 Agent、3D 理解与交互、医疗多模态四大能力。在蚂

    来源 腾讯网
  20. 软银收购ABB机器人业务遇阻:53.75亿美元交易遭中国禁止

    【TechWeb】11月6日消息,据外媒报道,ABB集团官网11月5日发布的《ABB机器人业务剥离进展更新》声明称,ABB已获软银告知,中国外商投资安全审查工作机制办公室已禁止软银收购ABB在中国的机器人业务。声明同时表示,ABB与软银正保持密切对话,并以建设性态度推进该交易。 据媒体报道,ABB机器人业务在全球工业机

    来源 AI 行业观察
  21. Sand.ai完成2亿美元A+轮融资:基石资本、网宿科技领投,上海国资入局

    据三呆科技最新消息,专注于视频大模型研发的前沿企业 Sand.ai 近日正式宣布完成总额高达2亿美元的 A+ 轮融资。作为当前大模型赛道备受瞩目的新生代力量,此次超大额融资的顺利交割,标志着市场对视频生成技术商业化落地前景的坚定信心。 多方顶尖资本汇聚,老股东持续加码 在此轮融资中,投资方阵容堪称豪华,汇聚了产业资本、

    来源 AI 开发者社区
向下滚动自动加载更多