微软专利:用玩家显卡跑AI训练,闲置算力能换钱
一周前,OpenAI CEO萨姆·奥尔特曼曾在播客节目中吐槽道,“当我们审视全球有限的内存供应链时,会发现资源分配非常糟糕。全球数以亿计的个人电脑中,囤积了海量的内存,但在绝大多数时间里,这些内存的使用率仅仅只有5%左右”。 普通PC用户买内存是浪费,OpenAI用才是正途,奥尔特曼这番傲慢的“地图炮”很快就一石激起千
OpenAI CEO萨姆·奥尔特曼一周前在播客里直言,全球有限的内存供应链分配得很糟:数以亿计的个人电脑囤了海量内存,绝大多数时间使用率却只有5%上下。
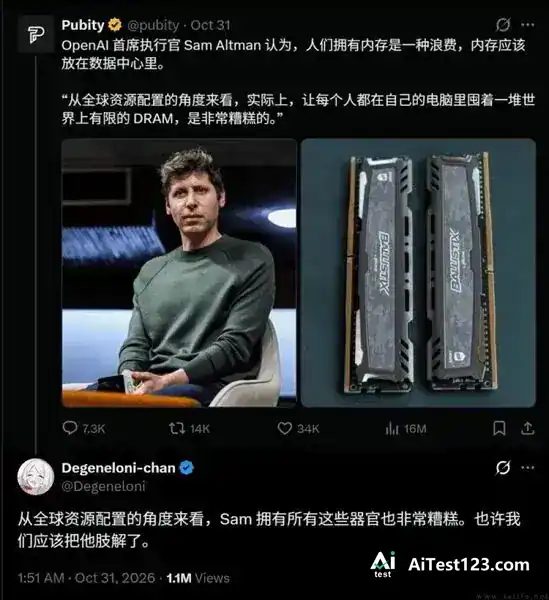
这番话很快引来一片批评。普通PC用户买内存是浪费、给OpenAI用才算正途,这样的口气听着傲慢,可它说出的其实是硅谷的共识——算力搁在个人电脑里闲着,就是浪费。
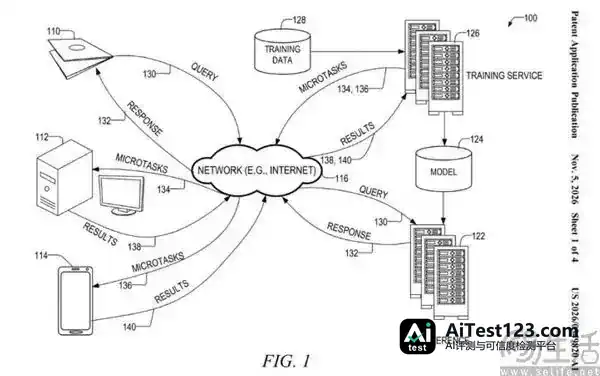
差不多同一时间,微软一份新专利露面,核心叫“共享计算”,打算把用户闲置的算力收进一张大网。按专利描述,微软要建一个分布式计算网络,把大型AI模型的训练任务切成大量小任务,分给空闲的游戏电脑、笔记本电脑,连智能手机也在范围内。愿意出算力的用户,能拿到积分、免费软件、AI模型使用权限,甚至现金。
这个想法并非凭空冒出来。数据中心扩张与民生的矛盾已经积到一定程度,美国各地因此掀起反数据中心浪潮,AI巨头和数据中心开发商今后大概率还要面对更严的监管。它们的“算力焦虑”不再是杞人忧天,而是近在眼前的危机。
过去两年,AI模型对算力的需求涨得比供给快,巨头们不得不在美国、欧洲、中东大规模建数据中心。如今建设很可能被按下暂停键,算力短缺就更紧迫。可相关厂商已经为AI砸下海量资金,没人敢无视这笔庞大的沉没成本。
让用户电脑里的显卡参与训练AI模型,算是微软想出的一个不是办法的办法。AI模型训练总绕不开“万卡集群”这个词,动辄千万亿参数规模的训练,通常要数千甚至数万张计算卡一起干活。
微软从边缘计算里取了灵感:先理清不同计算任务之间的依赖关系,再把整个训练过程拆成多个相对独立的小任务,即微型任务(Micro-tasks)。系统依据各设备的GPU性能、显存容量和可用时间派活,个人终端算完把结果传回,服务器负责验证、整合,再往下推进训练。
说白了,微软要搭的是一个围绕AI模型训练的承包体系:它当总包商,把任务拆成零散片段,用户在“任务公告栏”里领适合自己设备的散单。
不同设备性能参差,会影响整体效率,微软为此设计了一套动态任务分配机制。系统会评估任务拆分后的通信成本、额外内存开销,以及数据在设备间传输的频率,尽量挑适合分布式执行的切分方式。
当然,天上不会白掉馅饼,想靠接单赚零花钱的人得留意。为了把算力用足,微软计划通过Windows持续监测GPU利用率、显存占用、处理器负载、设备温度和功耗,再据此预测设备未来一段时间的可用算力。
某种意义上,微软这项专利并不新鲜,玩过PCDN、P2SP的人对它不会陌生。PCDN的原理也是把集中部署在数据中心的内容拆成无数小块,让用户电脑充当微型服务器。比如有人想看一部热播剧,平台不必从千里之外的数据中心拉流,先问问附近有没有“好心人”缓存了相关内容。
“打着人人为我,我为人人”旗号的PCDN,同样用利益吸引用户主动贡献带宽,把它变成PCDN的资源。微软的共享算力与PCDN的共享宽带理念接近,结局恐怕会南辕北辙。
PCDN是互联网内容平台和用户合谋薅运营商的羊毛,运营商的高价商用宽带因此流失了一大批潜在客户。微软的共享算力不同:英伟达、AMD、三星、美光等算力供应链上游如今满负荷运转,算力依然供不应求,而且微软没说要用个人电脑的算力替代数据中心。

一旦专利落地,这势必会成为普通人赚零花钱的好机会。唯一的问题是费显卡:AI模型训练会让显卡长时间接近满载,晶体管开关次数剧增,老化随之加速。按60%-70%的高利用率算,业界普遍预估数据中心的显卡寿命可能只有1-3年,挣的钱够不够补显卡损耗,得好好算笔账。