微软服务全球宕机24小时:74个国家和地区受影响,损失或达70亿美元
微软三个月前的补丁,这两天把74个国家和地区全整崩了。。。,微软,网关,服务器,知名企业,命令提示符,office,outlook
微软这两天出的大宕机,估计不少人都已经听说了。
事情得从北京时间 13 号凌晨讲起。当时一大批美国用户突然发现,Outlook 邮箱怎么也连不上了。
Outlook 是微软的办公软件,邮箱之外还带着日程管理、会议邀请这些功能。国外大多数公司和政府机关上班沟通,用的都是它。
一开始,大家还在网上发帖问出了什么事。可 Outlook 还没缓过来,微软的 Teams、Copilot、SharePoint 也接连出现连接问题。
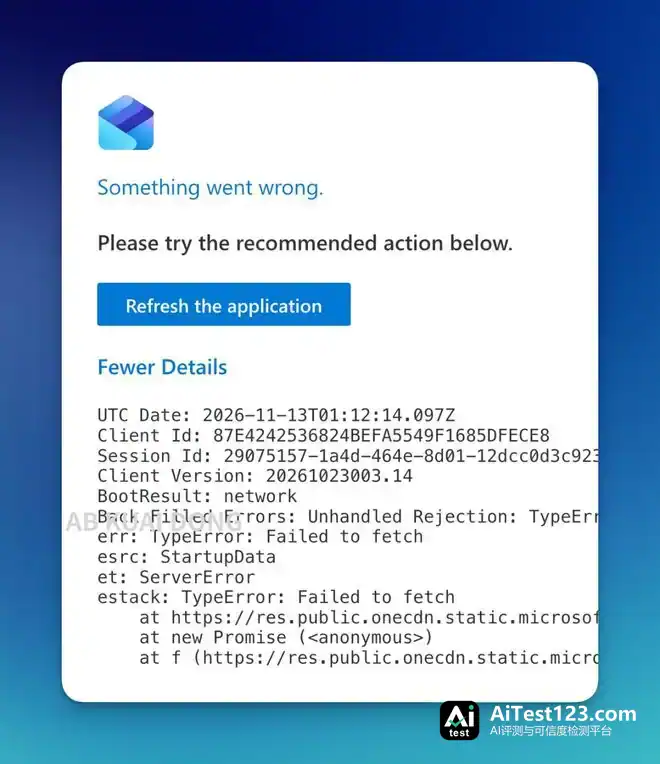
后来有人去故障监测网站 Downdetector 上查,发现已经有 74 个国家和地区的用户报告微软服务崩了。全球市值第三的微软,就这么崩了?
按常理说,这种体量的大厂,核心业务不该出问题。就算真崩了,也总该很快抢救回来吧?结果微软服务一直撑到 14 号凌晨才彻底恢复。
那这 24 小时里,全球打工人被影响成什么样了?
工作效率差不多倒退 20 年。英国就有几百家医院重新用回了纸质病历,不少手术还被临时取消。
英国国家医疗服务体系(NHS)100 多万员工,平时收发邮件、开会、传文件用的都是 NHS.net Connect 系统,这套系统离不开微软服务。NHS 系统登不上之后,病人资料发不出去也收不进来,连重症患者的紧急转诊都没法通知。
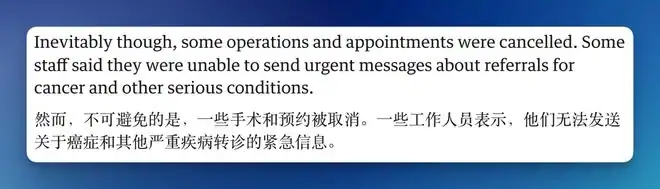
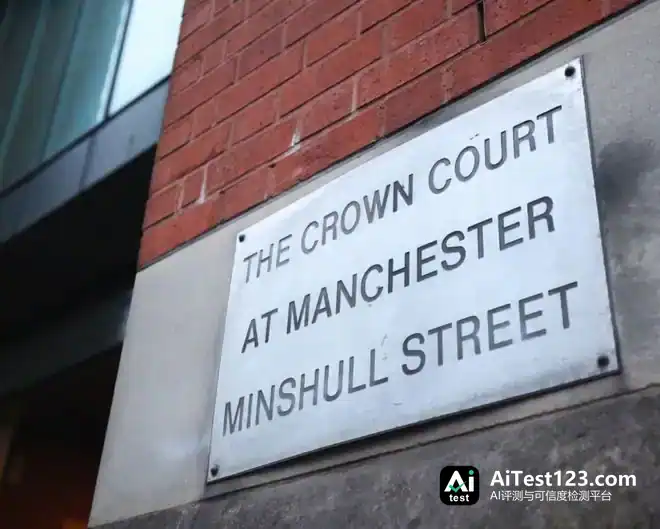
英国法院系统平时也靠 Outlook 收发邮件,民事案件的判决同样是用邮件发出去的。邮箱一挂,判决结果只能推到下周一再宣布。
受害法院之一↓
日本也没躲过去。日本数字厅给各部门搭的政府共通平台 GSS,用的就是 Microsoft 365。
结果各部门的 Outlook 收发不了邮件,最后只能靠电话、短信办公。全员回到 90 年代,开始复古 Y2K 时尚。
美国研究机构估计,这次微软带来的损失大约在 70 亿美元。
受影响的人一多,网友的梗图也跟着来了,反正看热闹不嫌事大。
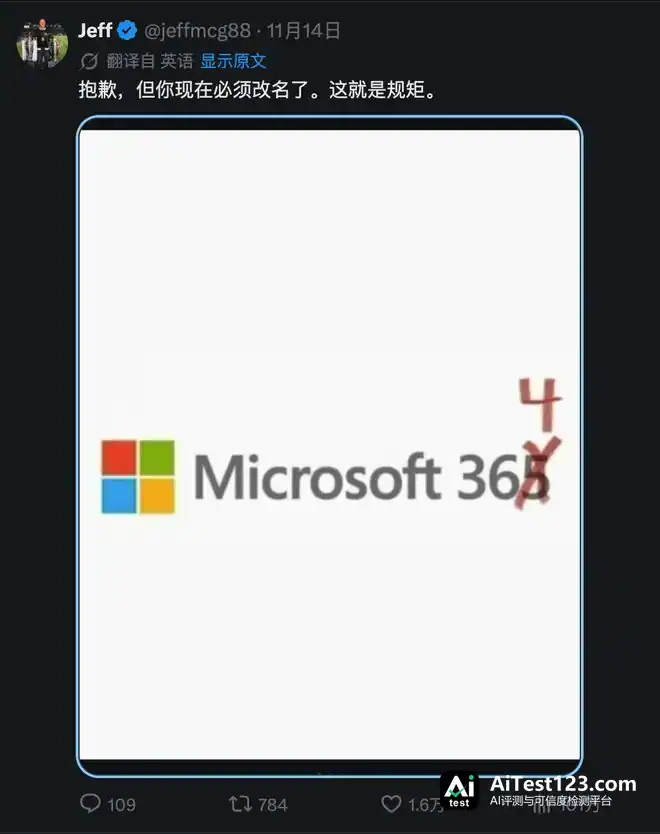
有人发了一张 Microsoft 364 的图片,意思是 Microsoft 365 今年得少算一天。
微软必须改名!别问,问就是规矩。
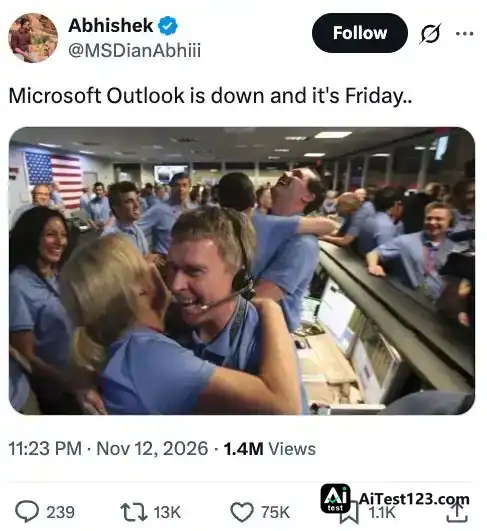
有网友贴出一张 NASA 控制中心的照片,画面里一屋子工作人员抱成一团欢呼:Outlook 挂了,而且这天正好是周五。对不少打工人来说,周五早上邮箱打不开,差不多就等于周末提前开始了。
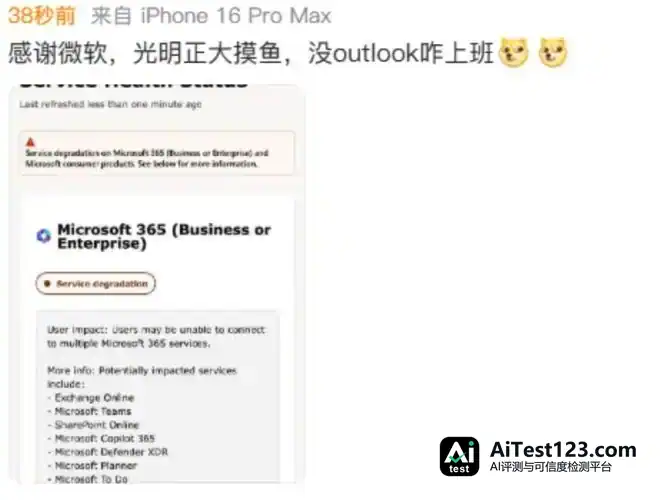
那问题就来了,微软这次捅出这么大篓子,到底怎么回事?
起初微软怀疑,是某个负责检查服务器健康状况的组件出了岔子。直到昨天(16 号)初步事故报告发出来,外界才把原因看明白。
看完这份报告,只能说:真不是黑客对微软下手,纯粹是自己搞自己。
微软 365 的邮件、Teams、网盘这些服务,全球用户连进来都得先过一道「网络网关」,好比进地铁站先刷闸机。
这样的网关微软备了两套,一套主用、一套备用;每套下面都挂着一大批服务器,像一排排闸机口,用户先过闸,再被引到后面对应的服务上。
平时邮件走主网关,Teams 走备用网关,两边互为备份,哪套出状况就切到另一套。这回出问题的,恰好是主网关。
按微软官方的说法,酿成事故的一共埋了 3 个伏笔。
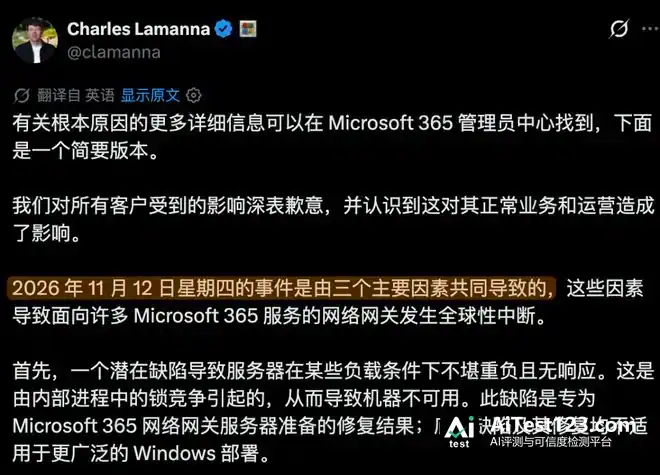
头一个伏笔在 7 月:微软给网关服务器推了个补丁,里头藏着一处缺陷,会让服务器某个内部程序出现「锁竞争」。所谓锁竞争就是抢资源,好比营业厅里只有一枚公章,每个柜员办业务都得排队等它盖章,柜员越多队伍越长,活反倒干不完。
因此这个缺陷在 CPU 核心越多的服务器上发作得越厉害。偏偏微软做压力测试时用的基本都是核心少的机器,问题自然测不出来。这个补丁就这么在全球网关上安安稳稳跑了三个多月。
第二个伏笔是出事前 15 个小时的一次切换:Teams 从备用网关挪到了主网关,跟 Outlook 背后的邮件服务 Exchange Online 挤到一块儿。微软说这类切换很常规,可主网关的压力还是大了一截。
第三个伏笔在事故前一天,因为另一个不相干的问题,主网关有 14% 的服务器还处于关闭状态,正在一点点恢复。
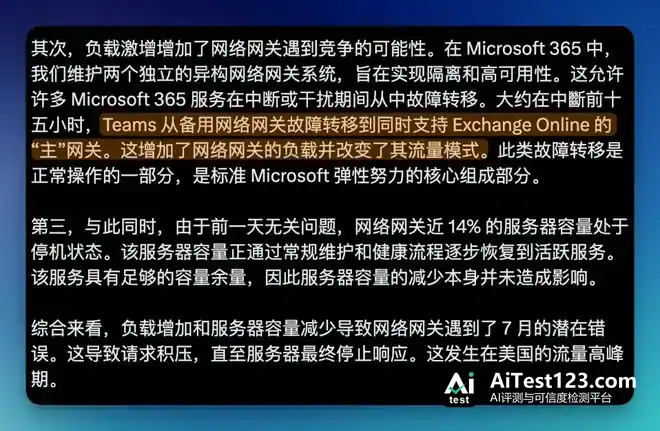
三个伏笔撞到一块儿:主网关本就有 14% 的服务器关着,Teams 的流量又全压过来,还正撞上美国上班的流量高峰。
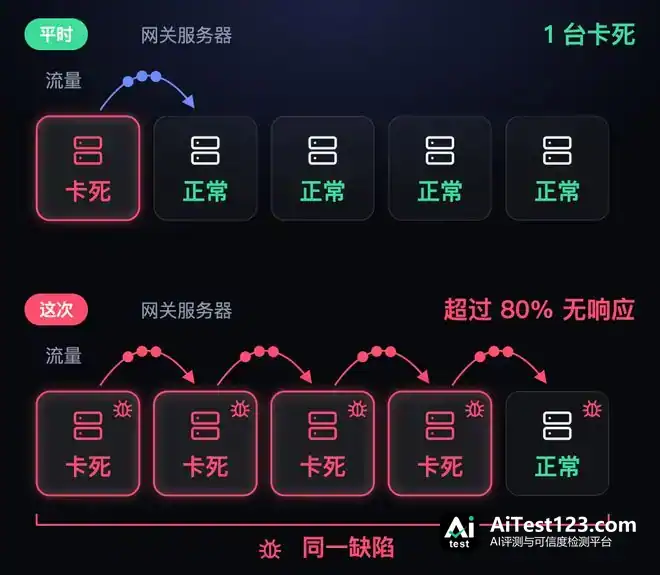
结果主网关剩下的机器越来越吃紧,锁竞争被直接触发,一台接一台卡死。
紧接着,微软的保护机制开始帮倒忙:哪台服务器卡死,系统就自动把上面的用户迁到主网关里其他还正常的机器上。可大家都有毛病,流量转到哪儿,哪儿就跟着卡死。
不到两小时,主网关超过 80% 的服务器都寄了。
更糟的是,网关原本设有隔离机制,本可阻止一地故障波及其他地区。可这层隔离因另一处问题失效,故障便一路蔓延到全球。
这时候,两套网关起了作用。
Teams、OneDrive、SharePoint 等服务先后切到备用网关,恢复得比较早。邮件体量太大,备用网关扛不住,只能继续留在主网关上硬撑,Outlook 邮箱因此成了这次停得最久的服务。
微软埋下的这些小伏笔,解释起来倒是能看明白。可按差评君的说法,还有一个最大的伏笔没被提到。
事情到这儿还没完。
微软发现问题后,立刻着手重启服务器。服务器刚重启,积压的大量流量又把它压垮了。
用户就这样被反复折腾,一二三四,再来一次。
这让人想起小时候停电,电力局一顿猛修,来电那一瞬间所有人赶紧开空调,电又跳了。
缺陷是几个月前留下的,快速回滚解决不了问题。微软最后只能把那段代码改回老版本,再分批重启,服务才一点点恢复。
目前微软还没公布赔偿方案,但大概率会按合同赔付。
按照微软与企业签订的服务等级协议(SLA),某项服务一个月可用率低于 99.9%,退还该项服务当月费用的 25%;低于 99% 退 50%;低于 95% 全额退。
这次邮件停了近 24 个小时,按一个月 30 天算,可用率为 96.7%,对应退半个月邮件服务费。
假如一家 100 人的公司用的是 Microsoft 365 商业标准版,全公司一个月 1400 美元。整套服务都按一半退,最多也就 700 美元。只算邮件那部分的话,退得更少。
就这么点赔偿,还得企业自己去申请。
云厂商一贯如此,平时把 SLA 里几个 9 的可用性说得天花乱坠,真崩了只抵扣一点服务费。
耽误了人家几十辆兰博基尼的生意,最后赔一张兰博基尼 5 元代金券?
看到这儿可能有人要问:企业为什么不搞点备用方案?全绑在微软一棵树上,太看微软脸色了。
其实不是不想换,是大多数企业根本换不动。
微软想给用户的,从来就不只是一个邮箱。
企业一旦用上微软邮箱,为了体验不受影响,就会顺理成章把微软日历、聊天、开会、云盘等全家桶全套用起来,不然多个平台来回切换很麻烦。
整家公司的工作流,就这样被微软越绑越深。
这正是微软最想要的护城河。
当年 Teams 刚推出,微软就把它塞进 Office 套餐捆绑销售。欧盟为此专门查了微软两年多,直到 2025 年微软承诺下调不含 Teams 套餐的售价,案子才算了结。
等一家企业回过味来、意识到不能完全绑死在一家服务商身上时,往往已经来不及了。
可真要换,等于把整套体系推倒重来:替代品得一样样找,员工资料要全部搬过去,新工具还得重新教大家用。更麻烦的是,未必找得到比微软更合适的服务商。小的不稳定,大的如谷歌,也不过是从一个篮子换到另一个篮子。
再看微软的份额,你的甲方乙方多半都在用它,真换了,跟对方对接反倒更费劲,最后还是得跟着用。
平心而论,看完这次事故,微软在底层保护上做的并不少。可只要全球这么多企业仍把身家押在微软一家身上,人类的容错率就高不了。
一家出事,半个地球跟着炸。但走到这一步,好像也没什么办法。就跟互联网一样,如果一开始就建在一根针尖上,那往后的日子,也只能继续在这根针尖上盖下去。
美编:焕妍
图片、资料来源:
Al Jazeera:Microsoft hit by global outages: What happened and why?
Wikipedia:2026 Microsoft outage
TechCrunch 11 月 12 日关于本次故障的报道(Kentik 流量数据)
The Irish Times 关于本次故障对 NHS 影响的报道
The Guardian:How Microsoft outage has affected key public services in the UK
ITmedia NEWS:MS障害、政府共通システムにも影響 デジタル相「朝、なんで使えないんだろうと思ったら」
Control Plane 汇总的微软状态更新(MO1550821)
Microsoft 官方博客:Helping our customers through the CrowdStrike outage
AWS:Summary of the Amazon DynamoDB Service Disruption in the Northern Virginia (US-EAST-1) Region
Microsoft:Service Level Agreements (SLA) for Online Services
Office 365 IT Pros 2026 年 4 月 22 日关于 SLA 的文章
meme.com:Microsoft 364
X:@Britannica 11 月 12 日推文
X:@MSDianAbhiii 11 月 12 日推文