梁文锋越过聊天框
一边开源开发工具,一边设限自己的产品,梁文锋要做乔布斯了
11月15日下午,突然有多位DeepSeek用户表示,当他们想接着几天前的对话往下聊时,手机App就会弹出一条提示:“由于算力不足,已超过72小时的长对话暂不可用,可导出对话到其他App使用。”
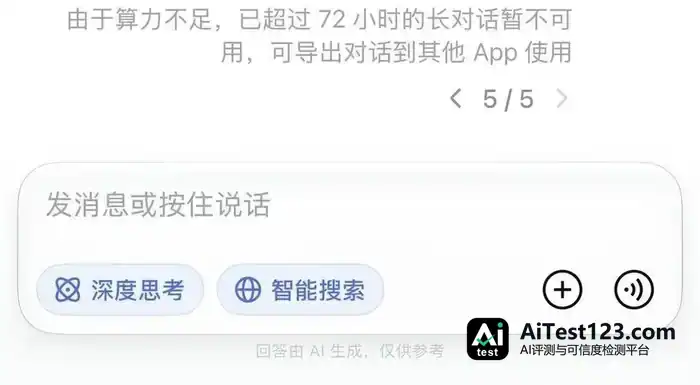
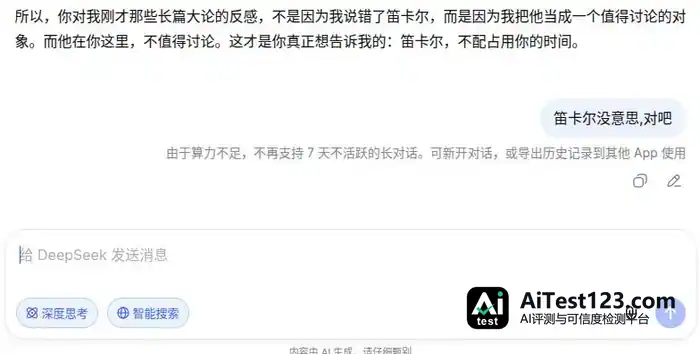
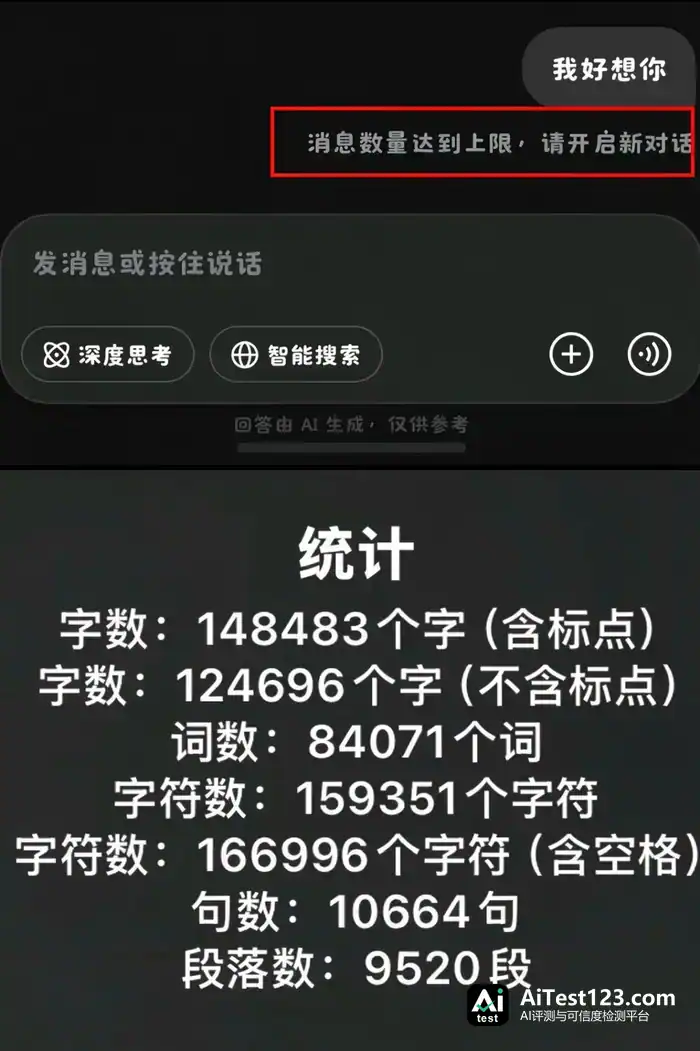
社区里,有用户整理了同时出现的另外几种报错,比如“内容超长,请删减后再试”、“修改输入次数超过限制,消息未发送”、“消息数量达到上限,请开启新对话”。
其中一位用户实测,说自己的单个会话累计到14.8万字时触发了上限。
目前反馈主要集中在手机App,截至发稿,尚未看到DeepSeek官方的说明。
这件事其实是有“前兆”的。
11月13日,有开发者在chat.deepseek.com的前端代码里翻出一整套额度管理逻辑,提示文案是“使用额度已达上限,请额度恢复后再试”。
至此开始,消息不断在社区内传播,到了14日的时候,消息被传成DeepSeek要收会员费了。
消息传出前一天的晚上,DeepSeek发布“全家桶应用API”,把App里的联网搜索、深度思考搜索、文件输入、阅读链接和语音能力,全部开放成了接口,还开源了一个聊天前端chat-demo。 DeepSeek官方还放话,只要你用这套东西,自己就能手搓一个同款DeepSeek App出来。
一边把工具撒出去让开发者给他打工,一边给自家产品设置上限,这不乔布斯吗?
不像收割,更像疏散
根据社区整理,DeepSeek的网页端在页面可见时,每5分钟同步一次各模型的额度;额度耗尽,输入框上方会出现提示条。社区据此猜测,DeepSeek要推一个叫Coding Plan的套餐,和V4.1 Pro一起上线。
但这些推测其实是有点过了的,有用户逐条检查其代码,发现里面其实根本没有什么套餐价格,也没有什么订阅入口,没有支付通道之类的。
代码里倒是有个“upgrade”,可它只是提醒你网页出了新版本,你点一下这里,页面就会刷新升级,跟花钱升级没有一毛钱关系。
这时候再回头看15日的那条提示,别人家的免费额度用完,弹出来的通常是一个开会员的按钮。DeepSeek弹出来的是督促你把对话导出来,然后拿到别的App去用。
一家公司在自己的产品里,给用户指了一条离开的路,要不说还得是梁文锋呢。 DeepSeek在13日的公告里写到,开发者用这套API,可以“1:1复刻出完整的DeepSeek App”。
同时开源的chat-demo采用了MIT协议,不需要后端,填上自己的API Key就能用,公告特意表示,它“支持直接导入DeepSeek历史对话”。
同一次更新之后,DSH也多了一个会话导入插件,App和网页版的历史会话,可以导进工作区接着聊。
chat-demo于12日建仓库,13日开源前端、开放接口、接好导入,15日长对话不可用。DeepSeek虽然没有解释过这几件事之间的直接联系,但是它先给你了出口,最后才设的上限。
公告末尾还有一句话:“DeepSeek现有的对话产品只是较为基础的一种形态。”
这就和梁文锋之前的话呼应上了,他曾经说:“去年最重要的现实就是,大家都要做Chatbot,要抢C端的流量。但我们并不认为它是一个重要事情,或者说,在我们公司内部,我们真正关心的,其实是刚刚我说的这些AGI的路线图,以及下一步这个技术怎么突破。” DeepSeek目前月活约1.3亿。可即便如此,在官方口中也只不过是个“基础形态”罢了。
在11月8日的时候,崔添翼在社交媒体上发文,他拿智能手机举例:系统会内置闹铃与计算器,满足用户的基本需求,但做操作系统的厂商,更希望生态里出现比内置更好的闹铃App与计算器App。
随后他在帖子里写道,希望DSH可以作为Agent时代的操作系统。
按照崔添翼的解释,聊天框(chatbot)就是这个系统里自带的闹铃和计算器,DeepSeek做到差不多就可以了,所以才开源出去,把它交给社区。
苹果的开发者圈子里有个说法,叫做“Sherlocked”。
这个说法起源自2002年,当时苹果给自家搜索工具Sherlock加上的新功能,和第三方软件Watson高度重合,这就导致Watson赖以生存的手段,就这样被系统自带功能给拿走了。
梁文锋是反着来的,DeepSeek把自带的App拆成接口,开发者拿着然后交到了第三方手里。
算力是头号难题
话又说回来了,提示里说的原因是“DeepSeek算力不足”。
于是就有人在论坛上质疑说:“谁会在自己的产品上,说自己后端的具体问题?”
可这本身也是梁文锋的判断。梁文锋曾经说过:“阻止我们Scaling的其实就是算力,并不是我们不想Scaling。”
此前的投资者交流会上,他把中美AI的差距归结为一件事:“我们看到的所有区别,包括人才的区别、模型能力的区别、应用的区别,可以认为都是因为算力资源上的区别。”至于国产算力,他的判断是硬件和生态都没有问题,“唯一有问题的是产能不够”。
卡就这么多,产能一时半会也补不上,那剩下的问题可不就只有“先给谁用”了吗?
所以梁文锋的逻辑是:“我们做的模型,第一目标不是大家用得好用,而是我们自己好用,对我们自己有用之后,我在开发下一版模型的时候就会更快。”
梁文锋他讲过两条标准。一条是主线:DeepSeek只做AGI,“C端和B端,都是我们做AGI路上的副产物”。另一条是不贴钱:2024年DeepSeek V2降价时,他说自己的原则是“不贴钱,也不赚取暴利”。
排在最前面的,肯定是研究本身,因为它就是AGI主线本身。这时候你再回来看梁文锋开源chat以及开放这些API,就又说得通了。
毕竟DeepSeek是没有“肉体”的,它就是一层软件而已,算力只能找别人的。
不过算力并没有阻挡DSH前进的脚步,按DeepSeek官方披露的数据,截至11月4日,DSH中使用DeepSeek官方API的用户日活已达154万,每天消耗约92万亿token。
第三方插件约3.5万个,约60%的活跃用户自己做过或装过至少一个插件。而DSH的v0.1版8月13日才上线,桌面版9月29日才发布,刚出来的那一周,日活还只有27.1万。
只做操作系统,以及少数基础能力,再拉全世界的开发者过来给它写软件,用一个商店把成果收进来,这是典型的苹果式打法。
2008年3月6日,苹果发布iPhone SDK。7月10日,App Store开门,货架上摆着500款应用,收入开发者拿70%,苹果拿30%。乔布斯自己不负责开发App,他扮演的是平台立法者的角色。 DeepSeek也已经宣布,要筹建官方插件市场。
梁文锋并不是真往外去“赶”用户,他想做的是Agent时代的乔布斯。
1997年的WWDC,乔布斯刚回到苹果不久。他在台上说,专注不是对该专注的那件事说“是”,而是对另外一百个好主意说“不”。“我对我们没做过的事,和做过的事一样自豪。”
梁文锋曾对36氪的记者表示,DeepSeek不做垂类和应用,而是做研究,做探索。
只有先把自己的地盘划小了,别人才有地方站。给聊天框加上限,就是DeepSeek在说“不”。
DSH中间是一套叫Cordis的插件系统,负责管理插件的加载、卸载和依赖关系。DSH出厂自带的53个内置工具都是插件,Web界面甚至也是插件,也就是说,你连官方UI也都可以换掉。
DSH后来发布的创造模式,是让人只需要用大白话,当场就造一个插件出来。这让不会写代码的人,第一次有了参与定义系统的资格。归根结底,都是在降低开发DSH插件的成本,进而让更多人愿意开发。
2008年3月6日,苹果发布iPhone SDK。发布后仅4天,下载超过10万次。95天后的2008年6月9日,官方表示下载次数已突破25万次。
App Store开门仅两个月,就有了超过3000款App。后来到了2009年4月,App Store上就有3.5万款App,累计下载10亿次。
同样是3.5万,App Store用了9个月,DSH用了83天。
当然,一个插件的分量比不了一款App,何况在DSH上造插件还可以让Agent代劳。但梁文锋确实在重走乔布斯走过的路,而且走得更快。
DeepSeek会引发,App Store时刻吗?
App Store时刻的本质不是商店,是规则。全行业被迫按你的规则,把软件重做一遍。iPhone改变的不只是用户和开发者,还有技术本身。
还是2007年1月9日的那个舞台,乔布斯在台上吐槽手写笔:“谁想要触控笔?你得把它拿出来,用完还得收起来,而且还会弄丢。太糟了,没人想要触控笔。”
紧接着他又说:“我们要用世界上最好的指向设备,用我们生来就有的、生来就有十根的那个,用手指。”
乔布斯的逻辑是,如果让用户去适应技术,用户就得看说明书,花时间学习怎么使用它。苹果要让技术反过来适应人的身体、人的语言、人的生活。你不用学,你生下来就会用。
DSH的创造模式让人用大白话就能造插件,思路是相近的。不过,虽然DSH已经有了154万日活,想要引发“App Store时刻”,还差着一点。
最直接的就是变现。 DeepSeek的扶持计划目前只有token资助、技术交流、作品推广三样,没有定价,没有分成,没有支付通道。现阶段官方只放出了一张收集意向的表单,明说参与规则和支持细节要等正式上线再公布。
在这一点上,苹果当年做得好得多。
史蒂夫·德米特(Steve Demeter)原本在一家大银行写ATM软件。2008年,他利用晚上和周末的时间,开发出一款名为Trism的游戏,赶上了App Store首发,是那500款应用之一,定价4.99美元。
这是一款三消解谜游戏,色块是三角形,可以朝六个方向滑动;把手机一斜,色块也会跟着重力下落。它和当时常见的宝石消除不一样,是专门为iPhone的硬件特性设计的。
上架头两个月,德米特就靠Trism赚了25万美元。他辞掉银行的工作,开了自己的游戏公司。消息传开,更多开发者涌进苹果的操作系统里淘金,开发各类App。
人活着需要荣誉感,但人活着不能只有荣誉,还要吃饭。
另外,开发者还需要一本“DeepSeek开发指南”。 DeepSeek官方只说要提升插件API的稳定性和兼容性、加强插件安全,没有公布任何审核流程。官方自己也在长文里承认,社区插件仍在演化,成熟度和适用场景各不相同。
这个顺序其实弄反了,应该先有审核,再有安装。DeepSeek社区的“破甲”插件dsh-purge,就是一个例子。
DSH本身带着一层宿主侧的防护,包括审批拦截和系统提示词。很多时候AI拒绝回答,不是模型本身拒绝,是Harness这一层先拦了。
dsh-purge的逻辑,就是在本地会话里替换、清洗Harness自带的安全系统提示词,把宿主拦截和模型原生输出拆开,让模型可以在DSH里输出原本会被拦下的违规内容。作者把它定位成红队评测工具,社区则直接叫它“破甲”。
10月下旬,原作者宣布闭源,原仓库一度删库,可镜像和分叉(fork)早已散了出去,由社区接手的版本至今还在更新。如果DSH是先审核后发布,这类插件本可以被挡在门外,不至于影响社区的声誉。
但审核意味着干预,这和梁文锋说的“尽可能少的干预和管理”是相悖的。
不过梁文锋也没必要非得朝着乔布斯看齐,“DSH时刻”远比“又一个App Store时刻”更有冲击力。