谷歌整柜卖TPU:推理性价比压过GB200,直指英伟达地盘
谷歌打破惯例,首次向外部客户直接销售整套TPU系统,试图通过硬件外售分摊研发成本并扩大市场份额。最新测试显示,其第七代TPU在特定推理场景下的每美元性能优于英伟达GB200。配合TorchTPU开源以兼容PyTorch生态,谷歌正从专用芯片和软件适配两端发力,挑战英伟达在AI算力领域的绝对主导地位。
谷歌过去只把TPU放在云上出租,如今连整柜硬件也对外卖了。
十几年里,要用谷歌的TPU(张量处理单元),路子只有一条:上Google Cloud租算力。机器归谷歌,机房也归谷歌,客户只管写代码跑任务。核心资产攥在自己手里,控制力是保住了,可一批有自建数据中心、对数据主权要求极高的大型机构,因为摸不到实体硬件,一直被挡在门外。
今年情况不一样了。
谷歌开始学英伟达的做法,把整柜TPU系统直接卖给外部客户。这不只是云服务升个级,而是商业模式掉了个头。Alphabet最新的10-Q文件里,“产品销售,主要为TPU系统”已经写进Google Cloud的收入来源。大部分合同收入要到2027年才会完整落进财报,但方向很清楚:TPU要走出谷歌自家机房,进到更多企业的私有数据中心里去。
这个决定在谷歌内部也有过争论。据接近谷歌的人士透露,推动变革的是一位入职不到三年的高管。他主张改掉TPU长期以来“只供内部使用或云端租赁”的路子,最终说动管理层,走一条“类英伟达”的硬件直销路线。对习惯了自研自用的谷歌来说,这个转身不小。
为什么挑这个时候?
开放外售的时间点,一头连着内部成本,一头连着外部市场窗口。
内部看,AI基础设施的资本开支是个天文数字。大模型参数量指数级往上走,训练和推理要的算力集群越铺越大。Google Cloud虽然还在增长,可光靠云端租赁分摊这些巨额硬件投入,压力一天比一天大。把TPU系统卖给外部客户,说到底是一种“以售养研”:拿外部订单分担数据中心建设成本,用规模化的市场需求把自研硬件的单位成本曲线压下去。
外部看,市场正闹“GPU饥荒”。英伟达高端GPU供不应求,交货周期拉得很长,价格也一直下不来。不少AI实验室、初创公司甚至大型科技企业,因为买不到足够的H100或B200,只能另找替代。谷歌看准的就是这个窗口。客户买不到英伟达,或者不愿意被英伟达绑住,那么一个性能不弱、又能私有化部署的选项,卖点就出来了。
今年第一季度,谷歌CEO桑达尔·皮查伊在财报会上说,来自AI实验室、资本市场公司以及高性能计算领域对TPU的需求“强劲”。到了第二季度,谷歌开始向精选客户交付完整TPU系统,里面包含计算、存储、网络硬件和软件。效果直接反映在Google Cloud业绩上:Q1同比增长63%,Q2增长82%,Q3收入307亿美元、同比增长103%,经营利润从35.94亿美元跳到111.21亿美元。Alphabet管理层明说,TPU系统销售是第三季度云业务增长的重要贡献因素。
用专业化路线去碰通用霸主
英伟达能成,很大程度靠“通用”两个字。一颗GPU,训练能干,推理能干,图形渲染也能干,再叠上CUDA生态,几乎成了AI算力的默认标准。谷歌的判断是,这种一颗芯片包打天下的打法并非没有缝隙,往后走的方向是“专业化”。
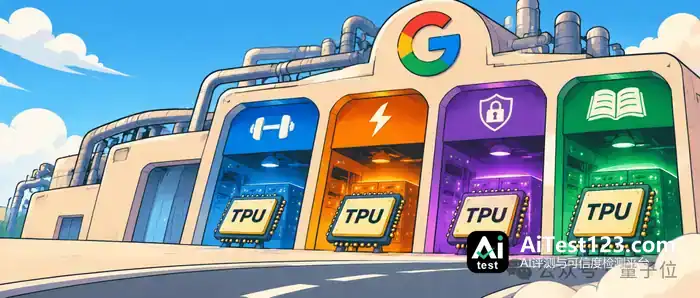
谷歌芯片业务负责人Amin Vahdat多次讲过,“未来属于专业化”。第八代TPU就是照这个思路分的:不再是一个型号打天下,家族扩到四种配置,分别面向训练、实时推理、机密计算和超长上下文处理做专门优化。今年发布的两款新芯片就是例子,一款盯机密推理,保证数据在处理过程中的安全;另一款盯长上下文,把内存带宽和访问效率调优,用来应付越来越长的Prompt和Context Window。
分工的逻辑不难理解:不同AI负载对硬件的要求差得很远。训练吃的是浮点运算能力和互联带宽,推理更在意低延迟和高吞吐;机密计算要有专门的加密引擎,长上下文则要更大的显存和更高效的内存管理。想用一套通用架构把所有需求都接住,某些场景下必然要牺牲效率。谷歌想做的,是用定制化设计在特定场景里拿到比通用GPU更高的能效比和性价比。
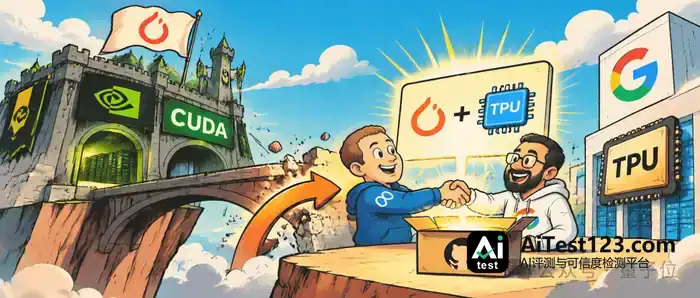
硬件只是故事的一半。TPU普及路上最大的坎一直不是性能,是生态。英伟达的CUDA攒了近二十年,壁垒已经很高。绝大多数AI框架、库和模型原生支持CUDA,开发者几行代码就能在英伟达GPU上把模型跑起来。TPU这边长期跟TensorFlow和JAX绑得很深,和主流开发习惯隔着一层。谷歌后来虽然支持了PyTorch,迁移成本仍然不低,大量代码要改,很多开发者到这一步就退了。
这块短板,谷歌过去两年一直在补。最关键的一步是跟Meta合作开发TorchTPU,目标是让PyTorch模型不用大改代码就能在TPU上跑。今年10月底,TorchTPU正式开源。开发者可以用熟悉的PyTorch API,在TPU上训练和推理,跟在GPU上差不多。门槛降下来了,软硬件栈之间那道墙也拆了。生态建设不是一天两天的事,但TorchTPU开源是个重要节点,它给开发者递了个明确信号:TPU不再是谷歌的“私家花园”,而是一个开放、兼容主流开发流程的计算平台。
性能对决:算每美元性能
在AI芯片市场,情怀和生态都重要,最后还是要落到性能和成本上。谷歌敢跟英伟达叫板,底气来自特定场景下的性价比。
11月5日,半导体分析机构SemiAnalysis晒出一组Agent推理测试数据。在Muse Spark等模型上,谷歌第七代TPU Ironwood的"每美元Token产出"已经压过英伟达GPU。这个指标相当敏感,直接对应着用户的使用成本。对大规模部署推理服务的企业而言,每美元能产出多少Token,利润率就摆在那里。
英伟达以前只在少数场景下输给过AMD,而TPU这回在性价比上带来的冲击,是它此前没有充分重视的局面。SemiAnalysis的结果一出,英伟达反应很快。据报道,公司马上拉了一支工程师团队不分昼夜地优化,凌晨两点还在干活。四轮优化之后,在某个特定模型的测试中,英伟达最新的GB300 NVL72 FP4在每美元Token产出上反超TPU 1.5到2.6倍。
这场"深夜加班"式的反击,正好说明竞争有多激烈。英伟达没法再高枕无忧,硬件和软件都得持续优化,才能守住性价比优势;谷歌这边则靠TPU外售和生态开放,一点点蚕食英伟达的市场份额。SemiAnalysis指出,谷歌提交AgentX测试结果、证明TPUv7能在每美元性能上击败GB300之后,英伟达迅速回应,说明TPU已经是它不能忽视的对手。
眼下TPU在推理场景里的优势比较明显,长上下文和机密计算等领域尤其如此。训练场景则不同,英伟达依靠CUDA生态和广泛的社区支持,仍然占据主导。不过,随着TorchTPU走向成熟、更多专业化工具链推出,这一差距有希望逐步缩小。
市场格局的重塑
谷歌把TPU拿出来外售,不只是市场上多了一家供应商,它可能让AI算力市场的格局发生深层重塑。
第一步,英伟达的定价权会被打破。高端AI芯片市场长期缺少有力竞争者,英伟达的定价能力因此极强。谷歌入局,又拿出有性价比优势的替代方案,英伟达在价格和服务上就不得不做出让步。对广大AI开发者和企业用户来说,这当然是好消息。
第二步,算力基础设施会走向多元化。过去企业建AI基础设施,往往只有英伟达一个选项。现在可以考虑混合架构:训练用英伟达GPU,推理用谷歌TPU;也可以按具体负载类型挑最合适的硬件。多元化既有助于降低风险,也能提高整体系统的效率。
第三步,AI技术的普及会加速。TPU外售加上生态开放,更多中小企业和研究机构能以更低的成本拿到高性能算力。创新和应用会被激发出来,AI技术也会向更广的领域渗透。
挑战当然还在。英伟达的生态壁垒依然深厚,CUDA的粘性极强。谷歌要在软件工具链、社区支持和开发者体验上持续投入,才有可能真正动摇英伟达的根基。另一边,AMD也在积极布局AI芯片市场,MI300系列等产品同样有竞争力。未来的AI芯片市场,会是英伟达、谷歌、AMD等多强并立的局面。
对英伟达来说,"一家独步天下"的日子或许真的快到尽头了。但这不意味着它要衰落,而是市场竞争回归了。健康的市场里,竞争是推动技术进步最好的动力。谷歌这次奇袭,或许正是AI算力市场走向成熟的一个标志。
就像苏妈(AMD CEO Lisa Su)那张表情包暗示的,这场大戏才刚开场。对我们这些使用者来说,谁赢都无所谓,只要竞争能让算力更便宜、更易得,就是好事。