

OpenAI纳维-斯托克斯证明:AI写88小时,人类花7周才读懂思路
OpenAI称攻克纳维-斯托克斯难题,人类正核验
9月8日,OpenAI公布了一份证明,声称拿下了纳维-斯托克斯这道千禧难题。它研究的对象,是一组用来描述流体运动的方程。
约一万个AI智能体、88小时、166页——这份证明写完,AI花了不到4天。而论文公布近7周之后,人类才慢慢读明白它的思路。
10月26日,数学家Scott Armstrong在X上发了一条长推。
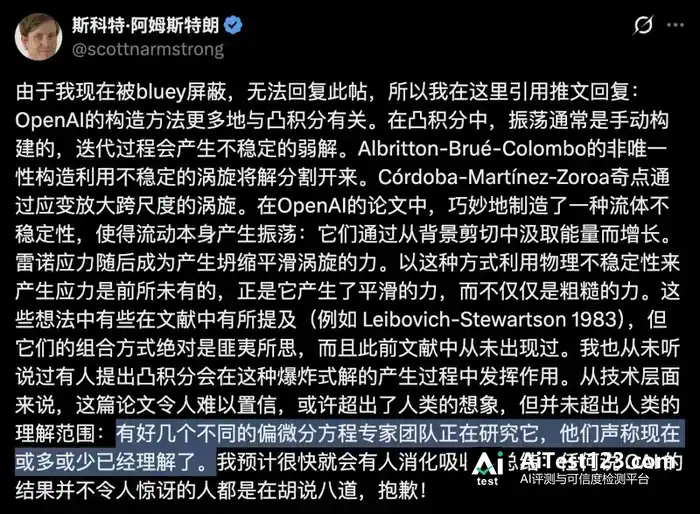
按他的转述,几组正在研究这份证明的偏微分方程专家,对其中思路已经基本读懂。也就是说,专业同行开始看清AI是怎么解题的了。
他的评价是:“它也许超出了人类原本能想到的范围,但没有超出人类的理解。”
Armstrong本人是法国国家科学研究中心研究主任,同时是纽约大学库朗研究所数学教授。他研究的方向就是流体湍流,这回算是内行看门道。
这一回,AI负责把想象的边界往外推,人类负责把它看懂。这场接力,人类刚跑完第一棒。
不过,读懂思路和确认全对,是两件事。千禧难题的下半场,眼下才刚开始。
AI 88小时交卷,人类看不懂
回到七周前。OpenAI动用的是一个尚未发布的新模型,调动约1万个智能体同时攻关。
88小时里,它们来回发了约270万条消息,生成约1300亿个token。
又过了17小时,GPT-6 Astra把证明翻译成Lean语言,交给机器逐行检查。这份震动数学圈的作业,光算力账单就以百万美元计。
证明是交出来了,可几乎没人读得动。10月14日,Nature旗下期刊《通讯-物理》(Communications Physics)刊发社论。
《通讯-物理》那篇社论打了个比方:方程炸了,飞机照样飞。作者的说法是,专家们信它是对的,可至今没人真正把它弄明白。
局面确实反过来了。从前是人出题、AI答不上;眼下成了AI交卷、人看不懂。
「这有什么好意外的?」
质疑声没等多久就到了。
有个叫Joel Fish的网友觉得,这结果「合情合理」。他的理由是,模型本来就啃过海量文献。
他还大致算了笔账:OpenAI这次烧掉的算力约合1500万美元。这笔钱要是拿去请数学家安心做研究,未必就做不出东西来。
Armstrong本想在讨论串里回一句,结果发现自己被一位网友拉黑了。他索性引用转发,拉出一长段正面回击。
话说到最后很不留情面:谁觉得这个结果不算意外,谁就是在胡说。怼完,他又客气地缀了一句「sorry!」
争来争去,核心就一个:AI到底有没有拿出新想法。要弄明白这个,得先知道AI想到了什么。
让水自己搅动自己
不妨先搅一杯咖啡。漩涡一旦被拉长,杯里的液体就转得越来越快,也变得越来越细。
这跟花样滑冰选手收臂加速是一个道理,转速陡然就上去了。
另一边,液体的黏性始终在踩刹车,把漩涡的劲儿一点点耗散成热。
一头是拉伸在给油,一头是黏性在制动。
近百年来,数学家反复追问的就是:拉伸能不能压过刹车,让速度在有限时间里冲到无穷大?
流体出现「爆炸」,在数学上被称作奇点。
这样一幅图景,OpenAI 说他们构造出来了。
设想一杯水原本静止,被一股平缓的外力轻轻推了一下。
杯中的漩涡越转越小,速度随之攀升,最后达到无穷大。
速度都到无穷大了,能量难道不会跟着爆掉?
答案是没有。这杯水的总动能自始至终保持有限。
原因并不复杂:转得最猛的那一小块水,体积也在持续缩小。
好比针尖上挂着的一滴水,转得再急,质量也只有那么一点。
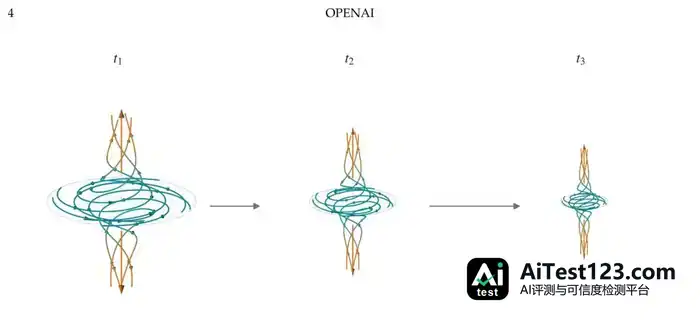
图中涡旋的核心不断收紧,长宽比例做了夸张处理。
真正的难处是,这股外力从头到尾都得温和,不能出现任何一次猛推。
如果推力本身就无穷大,水跟着「爆炸」自然不奇怪。
那相当于往杯里丢一个鞭炮,再说是咖啡自己炸开的。
麻烦恰恰在这里。
只画一个一直收缩的漩涡,放进方程里一算,想让它维持住,所需的外力同样会奔向无穷大。
怎么办?
论文给出的做法,是掺入一串有节奏的细小波动,也就是振荡脉冲。
这些波动带动水流,完成动量输运,恰好把那股快要失控的力抵消掉。
余下的小偏差,再一点点修补干净。
听着像是在打补丁。那么问题来了:这些补丁一样的振荡,究竟从哪里来?
在 OpenAI 之前,数学家已经走过好几条路。
头一条路叫「凸积分」。
数学家自己动手,搭出一层层细微的振荡,由此造出一些古怪的解,例如水流凭空冒出能量。
第二条路出自 Albritton、Brué 和 Colombo 三位数学家之手。
他们用一个不稳定的漩涡,让水流从完全相同的起点出发,最终走向两种截然不同的结局。
第三条路来自西班牙数学家 Córdoba 和 Martínez-Zoroa。他们的手段是持续拉扯,使漩涡的旋转一级一级被放大。
一开始,外界猜测AI走的也是这条路。不过,《科学美国人》采访的多组专家表示,仔细看下来,手法其实不一样。
Armstrong把关键点挑明了:AI的证明,最接近凸积分。不同之处在于,凸积分里的振荡要靠人手工造出来,AI则让水自己去造。
它设计出了一种流体不稳定性,让水流随时可能「失稳」。相邻的水层一快一慢,就好比风吹过水面掀起波纹。
这种速度差会自发长出小波动。上下两层气流一快一慢,把云层卷成一排浪花,正是「速度差产生波动」。(图源:UCAR)
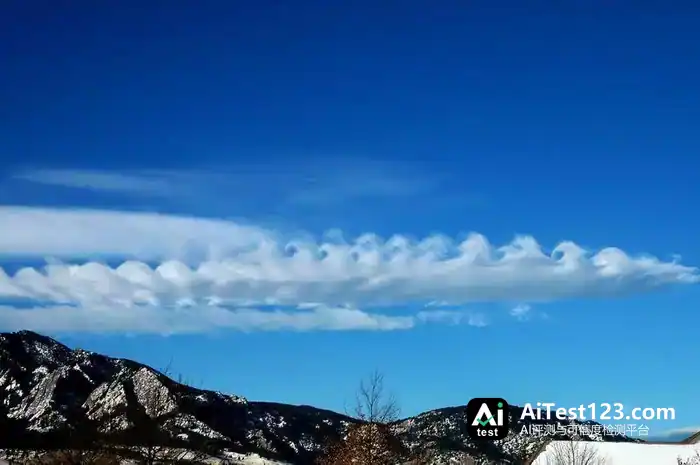
小波动产生的推力,又反过来推着中心漩涡越缩越紧。过去是数学家亲手搅水,这回是让水自己搅自己。
Armstrong认为,拿流体自身的不稳定性来「造力」,此前没有先例。也正因如此,AI造出的外力足够光滑,达到了题目的苛刻要求。
Armstrong坦言,其中一些想法,1983年的文献里就出现过。可把它们这样拼到一起,「绝对疯狂」,文献里从未有过。他也没听说有谁想过,凸积分能用来造出这样的爆破解。
整个过程中,AI没有发明新工具。它不过是拿人类的旧工具,走了一条人类没走过的路。
说AI只会复述训练数据的人,不妨先回答一个问题:材料既然都在文献里,这条路人类为什么没走?
看懂思路,还要查什么
人类这边的「消化」,已经有公开成果。9月下旬,复旦大学数学家雷震与合作者Xiao Ren发布了一篇解读预印本。
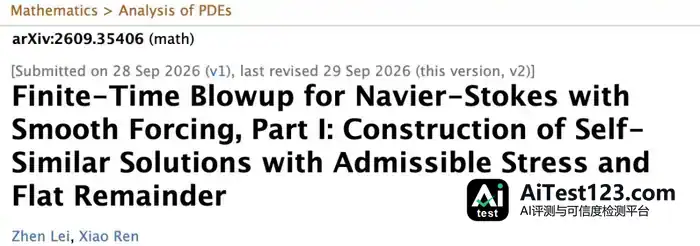
他们把OpenAI原稿中构造流动轮廓的部分重写了一遍,力求让同行读得懂。
论文中,这几位研究者把OpenAI的成果称作纳维-斯托克斯千禧难题上的一次重大推进。
AI先交出一份草稿,人类随后动手给它配起了教辅。
但把思路看明白,只是开了个头。
还有一件事要做:核对论文原文与Lean版本能否相互对应。
Lean是一款证明助手。
只要把数学命题和推导转写成形式语言,它就能逐步查验推理是否站得住。
问题是,机器只认它收到的那些内容。
这有点像校对译稿:译文读着顺,还得回头确认它有没有把原意改掉。
10月6日,Bastounis、Circelli和Hansen三位研究者发布预印本,指出原稿与Lean版本之间,部分陈述和推导对不上。
他们同时说明,OpenAI的文字证明本身是否正确,自己并未作出判断。
因此,这轮质疑不能简单归结为「证明被推翻」。
它真正要查清的是:机器验证过的那些东西,到底能替原稿中的哪些结论背书?
机器能保证每一步没算错,却保证不了题目本身没抄错。
到目前,克雷研究所对这道题的标注仍是「Active」「进行中」。
OpenAI方面也表态,无意去领那100万美元奖金。
下半场,留给人类什么作业
有人可能会问:这套方法能不能推到没有外力的情形上去?
这问题问得好,只是别把它理解成「剩下没做完的一半」。
克雷研究所列出的命题共四种,证出其中任何一个都算解答。
OpenAI声称拿下的,恰好是允许平滑外力的那两种。
无外力的情形,则属于下一个新目标。
Constantin等人新论文的分析显示,这套构造没法直接搬到无外力情形。
想啃下它,多半还得拿出全新的思路。
就眼下而言,人类手上还有三份作业要交。
先说第一份:讲解得完整、读起来顺畅,同行不必从头揣摩每一步究竟想干什么。
第二份是逐条核查与对照说明——哪些地方已经查过、哪些还需要进一步解释,都得写明白。
第三份,则是把里面的方法抽出来,移植到其他问题上。
三份都交齐,一份AI给出的答案才有可能催生新的研究。
AI这一棒的账好算:88小时、1万个智能体、数百万美元。
轮到人类接棒,账就难算了。读懂、核查、讲清楚,每一步都要耗掉专家的时间。
可少了人类这一棒,AI交出的东西没人敢用,也没法用。
从9月8日那份公告算起,七周已经过去,一些数学家开始摸清其中的思路。
下一步,他们得把这份证明转成后来者能直接接着用的知识。
AI想得比人快,人类理解、核查、传递知识的速度,也就开始决定科学能跑多快。
千禧难题的下半场,考的主要是人。
参考资料:
https://twitter.com/scottnarmstrong/status/2114412308185100522
https://openai.com/index/navier-stokes-solution/
https://www.nature.com/articles/s42005-026-02930-y
https://arxiv.org/pdf/2609.20803
https://arxiv.org/pdf/2610.08144











