OpenAI发布GPT-6.1 Terra:API价格降五成,评测分数仍落后Opus 5.5
当然,社区里也有用户肯定Terra的成本效率,认为能够以低得多的成本完成接近旗舰模型水平的任务,本身就具有价值。
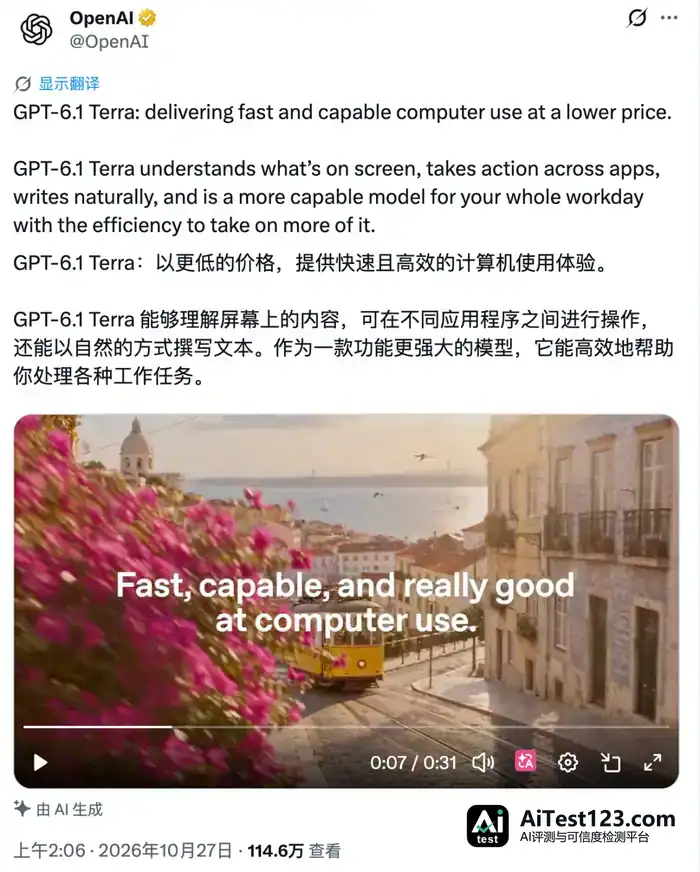
OpenAI推出新模型GPT-6.1 Terra,时间点选在Anthropic正式公开提交IPO招股书的同一天。
Terra系列上一次更新已是三个多月前,距离9月29日 GPT-6.1 Sol发布也过了27天。官方宣传里,OpenAI重点强调一句话:“以更低的价格,提供快速且强大的电脑操作能力。”不过网友的反应并不积极。
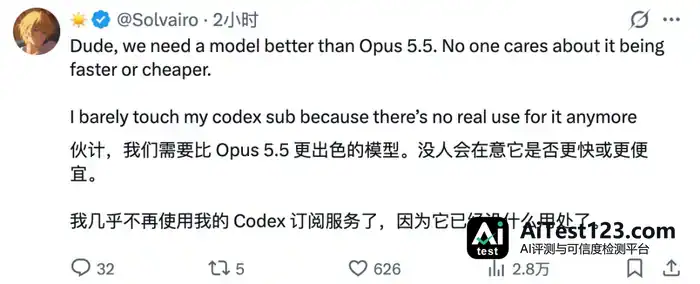
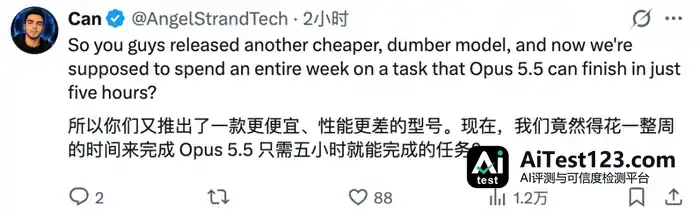
有用户直言:“老兄,我们需要的是比Opus 5.5更强的模型。没人关心它是不是更快、更便宜。”这人还表示,Codex订阅服务自己差不多已经不用了,原因是它实在没多大用处。
此前一段时间,Anthropic靠着Claude Opus 5.5在编程等领域聚拢了大量关注。很多用户盼着OpenAI拿出一款能正面硬碰的强模型,最后等到的却是一款走性价比路线、定位中档的产品。失望的情绪也就难免了。
从定位看,GPT-6.1 Terra属于“中规中矩”。价格方面,每百万输入Token收1美元、缓存输入Token收0.05美元、输出Token收5美元;相比上一代,输入和输出价格分别降了50%和约58%,并且只有GPT-6.1 Sol的一半。
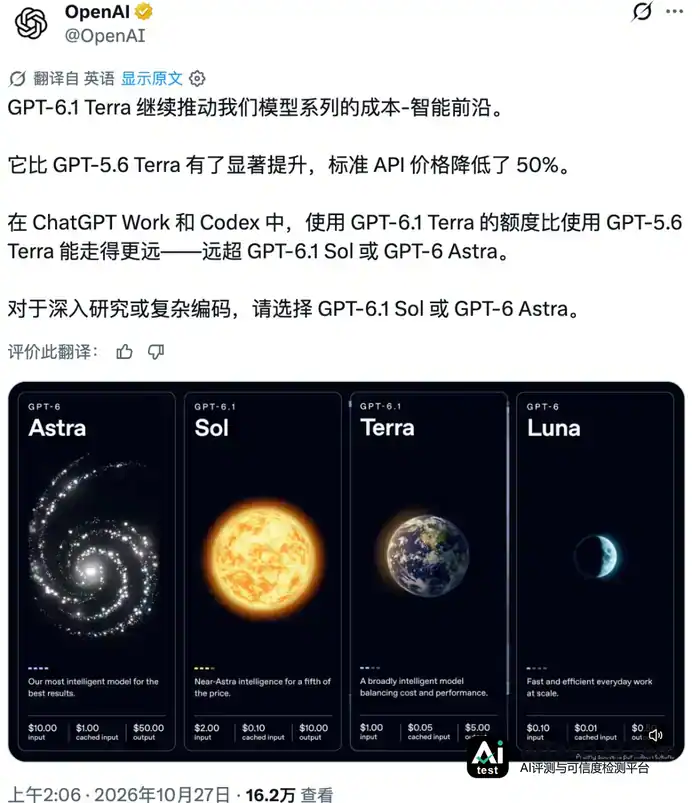
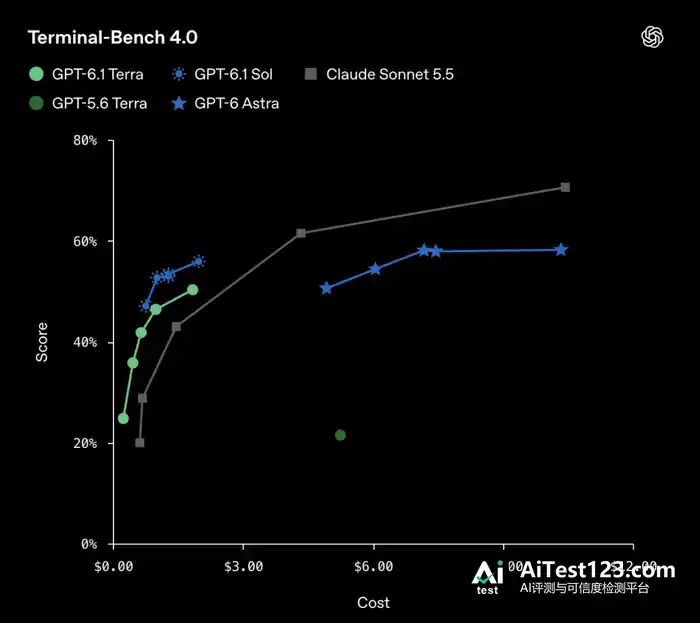
OpenAI公布的数据显示,Terra在编程、视觉理解、电脑操作等维度都比上一代有明显长进。衡量AI编程Agent能力的Terminal-Bench 4.0测试中,其任务完成率由上一代的21.5%升到50.3%。
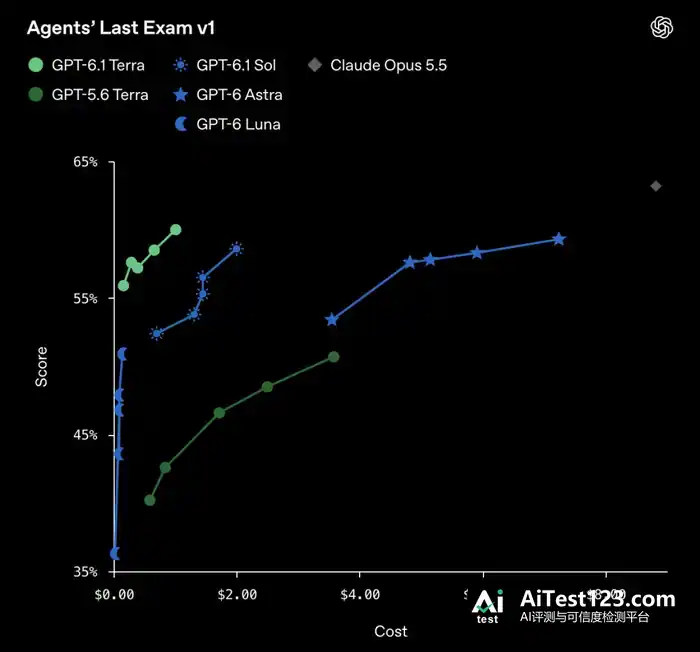
Agents' Last Exam测试里,Terra拿到60.0%,接近Claude Opus 5.5的63.2%。OpenAI还专门提到,在这项电脑操作测试的最高推理档位下,Terra用大约Opus 5.5九分之一的任务成本,换来了接近的成绩。
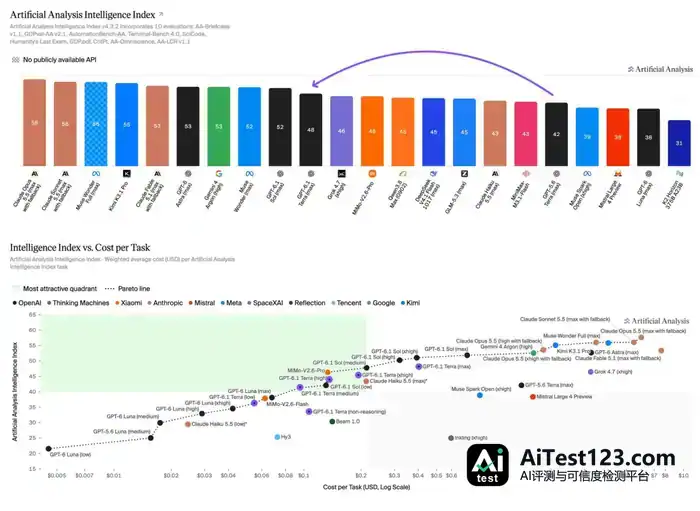
到了第三方评测这边,6.1 Terra的表现就没那么亮眼了。独立AI评测机构Artificial Analysis的测试显示,最高推理档位下Terra的智能指数为48分,比上一代多6分,可还是低于GPT-6.1 Sol的52分,和Claude Opus 5.5的58分差距更大。
成本效率倒是提升得比较清楚。Artificial Analysis发现,在其综合智能评测中,Terra完成单个任务的平均成本从1.40美元降到0.40美元,降幅超过70%。
说到底,6.1 Terra差不多就是个“中不溜”的模型:价格不高不低,能力不好不差,比上一代确实有进步。可它连OpenAI自家的Sol都没超过,追平Opus 5.5更谈不上。
对需要低成本调用模型的开发者而言,这或许算个好消息;但对那些等着OpenAI拿出下一款最强模型的用户来说,恐怕只剩一句评价:就这?
目前Terra已通过API开放,Plus、Pro、Enterprise和Edu用户也能在ChatGPT Work和Codex里用上它。普通的Chat对话暂时还调用不了。
跑分之外
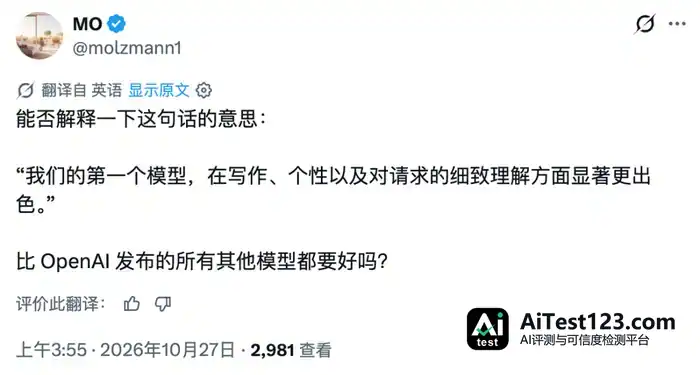
GPT-6.1 Terra被算进了OpenAI连续28天更新计划,是这段时间发布的首款新模型。Tibo表示,这是OpenAI第一款在写作、模型个性以及对用户需求的细腻理解方面取得显著进步的模型。
他还强调,新模型各方面表现都不错,尤其擅长电脑操作;在API和订阅服务中,它相比GPT-6.1 Sol能提供两倍的使用量。
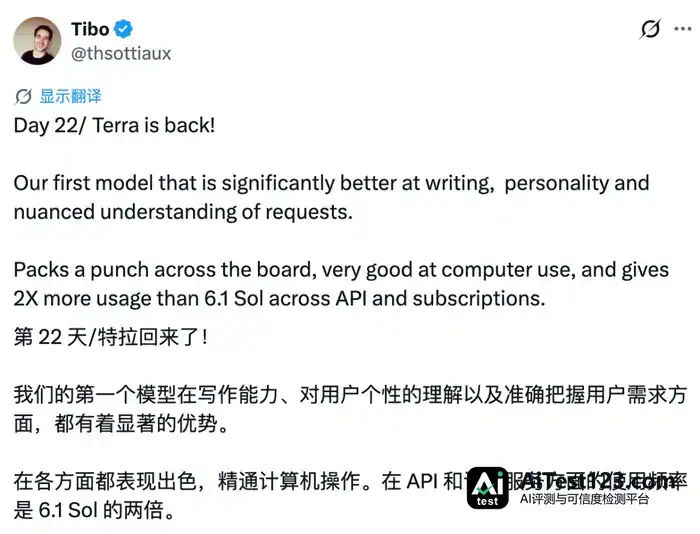
只是Tibo着重提到的写作、个性与细腻理解这几项,眼下公开材料还不足以支撑。OpenAI在发布稿里确实说Terra写出来的东西更清楚、更自然,可针对这三项能力的专门对比测试没拿出来,能说明显著进步的评测结果也没见着。
它到底是不是真更会写、更懂用户,多半要看用户上手之后的说法。
电脑操作这块的进步倒是看得见一些。宣传片里,OpenAI演示了Terra照着图片搭出3D模型。可宣传片终归只是宣传片。
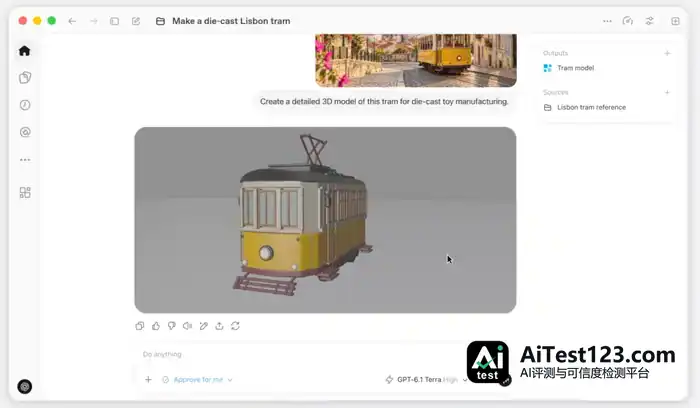
OpenAI在发布稿里还列了Terra参加过的基准测试:看建筑图纸建3D模型、逐帧核对动画并整理时间码。按官方给它的定位,填表单、把商品照片和目录条目对上号这类日常活儿也归它管。
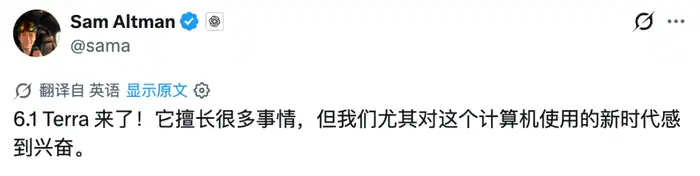
奥特曼在X上写道:“GPT-6.1 Terra来了!它擅长很多事情,但我们尤其期待电脑操作的这个新时代。”
任务执行之外,OpenAI还提了可靠性的提升。在官方专门设的高难度事实性测试里,低推理档位下Terra的事实错误率从上一代的53.6%降到16.7%,最高推理档位下则进一步压到4.3%。
这些数字出自OpenAI自己的内部测试。
网友:理解不了
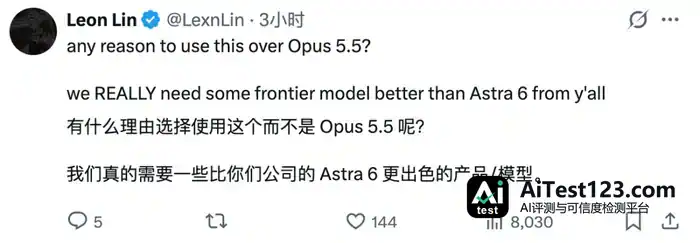
官方那边挺兴奋,网友的态度就没这么客气了。“有什么理由选择这个,而不是Opus 5.5?”
有人当面就问OpenAI,说他们真正想要的是一款比GPT-6 Astra更强的前沿模型。
也有人追问,官方这回怎么没多给几个Benchmark,以前不都是直接甩一张表出来么。
还有人说已经用上了新模型,电脑操作能力还不如6.1 Sol,速度也没宣传的那么快。“我们需要的是更出色的产品,而不是这种毫无用处的东西。”
Reddit社区里同样有怨气。在r/codex,有人直接发帖,把这次发布说成“简直是在给Claude打广告”。
另一些人认为Terra的问题出在定位上。有网友点出,Terra的API价格是Luna的10倍。想省钱可以用Luna,想要更强的模型,选Sol看上去更说得通。
连OpenAI的命名也被吐槽了。各档模型上线时间不统一,不同模型在某些任务上的表现又互有高低,不少用户已经分不清Terra、Sol和Astra该怎么挑。
面对这些声音,OpenAI研究员Ted Sanders在Hacker News上做了说明。他的说法是,Terra在技术交流上可能强过Sol和Astra,视觉理解和电脑操作方面两者接近,速度也更快,但其他大多数任务要稍弱一些。对订阅用户,他也承认:“这并不是一次重磅发布。”
当然,社区里也有人认可Terra在成本效率上的表现。他们的看法是,能用低得多的成本完成接近旗舰模型水平的任务,这件事本身就有价值。
只不过,比起这个不上不下的Terra,已经有不少人把目光投向了下一款Astra……还有对家的Fable 5.5。