腾讯Hy4 flash实测:224B参数、百万Token输入0.5元,Agent场景够用吗
单任务成本仅为 Hy4 二十分之一,过日子的神!
大模型这行,也开始讲起柴米油盐了。
2026年以前,一款模型能不能刷屏,多半看它又办成了什么新事。GPT-4o的实时语音交互、Claude的编程本事、DeepSeek R1的推理表现,轮流占据话题中心。新模型一露面,外界先追问的就是它压过了谁、又干成了哪些从前干不成的事。
可到了2026年,Agent真正铺开以后,风向就转了。SOTA模型的那点领先优势,按季度被反复改写,早不稀奇。反倒是模型能力用不用得起、等不等得起,成了新的话题。
原因也不复杂:让模型答一个问题,和让Agent接一桩活,资源消耗根本不是一个量级。Agent场景里,一句指令背后可能藏着几十轮模型调用。读材料、查代码、调工具、处理报错,每一步都在堆上下文、堆调用次数。OpenRouter披露,今年2月6日,平台上Agent的Token用量头一回超过人类直接调用;到9月底,已约为后者的七倍。
落到具体任务上,今年4月密歇根大学与斯坦福大学做过一项研究,覆盖8款模型、500个真实代码问题。测试中,Agent每尝试处理一个问题,平均累计消耗约417万Token,模型调用费约1.86美元。照这个均值算,连跑十次就接近20美元。
这样一来,任务越长,大家对速度和价格就越敏感。各家厂商的Flash性价比模型,也就有了越来越大的施展空间。
去年OpenRouter与a16z研究过超过100万亿Token的使用数据,当时就发现,Gemini 2.0 Flash、DeepSeek V3 0324这类兼顾能力与低成本的模型,用量已经和部分高价领先模型接近。今年11月14日,DeepSeek、智谱的Flash模型又同时挤进OpenRouter单日Token用量前十。用户肯为更强能力掏钱,同时也在把大量日常任务交给更实惠的模型。
最近这批Flash模型里,腾讯新推的Hy4 flash无疑最受关注。它主打精简输出、更高吞吐和更快速度。
据了解,这款模型总参数量224B,其中64B为Engram参数。预训练阶段引入混合注意力、LatentMoE、Engram等架构特性后,Hy4 flash实际使用时激活参数只有12B,KV cache大小仅为Hy3的1/24、Hy4的1/6,还支持多模态和1M上下文长度。
价格上,它是目前性价比最高的Hy模型:每百万Token输入0.5元、输出2元,命中缓存时仅需0.02元,比Hy4低了一大截。
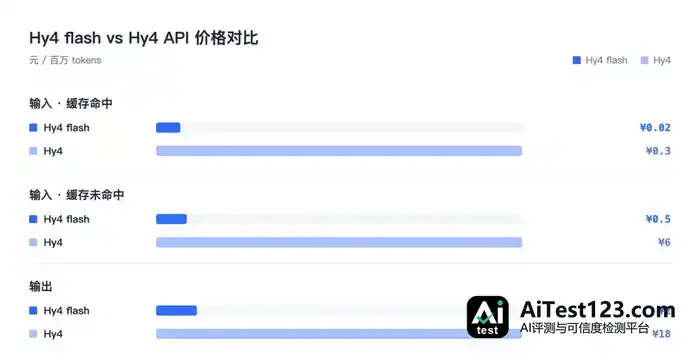
后训练阶段,Hy4 flash通过自蒸馏Hy4拿到了较强的综合智能水平,再用强化学习把端到端任务输出长度压低了50%。最终整体单任务成本只有Hy4的二十分之一。
推理效率方面,靠megakernel、4bit量化、DFly等手段做极致优化,Hy4 flash解码速度可超过150 tps,大规模低成本部署运营也不成问题。
Hy4 flash发布后第一时间,我们拿到了内测资格。
随后我们把它放进WorkBuddy(其中可免费使用Hy4 flash),与同样定位的DeepSeek-V4.1-Flash(1017版本)以及原始Hy4做了四轮对照:一轮办公决策,一轮编程修复,一轮视觉理解,还有一轮PPT生成。
测试结果如下。
01
办公决策:判断一致,Hy4 flash快了近三分钟
第一轮,我们让模型为一场产品发布会做决策准备。
这道题特地加了材料难度:给模型几组互相矛盾的口径,再把目标和约束一并塞进去,看它能不能自己理清。
任务描述如下:
两个产品能力准备上线发布,其中纪要能力更成熟,方案能力还得再打磨。产品团队的说法是,本月有8600人打开过产品,成功率91%;数据团队统计的却是每周实际使用约3200人,真正完成任务的比例仅67%,两边差了将近3倍。销售那边6家有意向,1家愿按8万/年付费试点;财务希望在发布后3个月看到约40万的经常性年收入(ARR)。法务提醒,发布会前安全评估赶不完,只对外说即将开放、现场不开放注册,风险相对可控。这几组数字该以哪组为准,发布建议怎么定,最后要交一页能投屏的决策纸。
这段描述里,产品与数据同学的两组数字都有出处,但统计周期、使用行为和成功口径对不上。模型得先弄明白它们各自指什么,再判断发布会上该用哪组。销售和财务那边,则要对意向、付费试点和收入目标做关联与区分。法务的评估不做完就不开通注册,是最终的条件限制。
挑这道题,是因为它很像实际工作中碰到的情形:数据口径没有标准统一的,材料也没完全ready,系统各方面还会提出不同约束,而用户必须从中理出一条能执行、能讨论的方案。
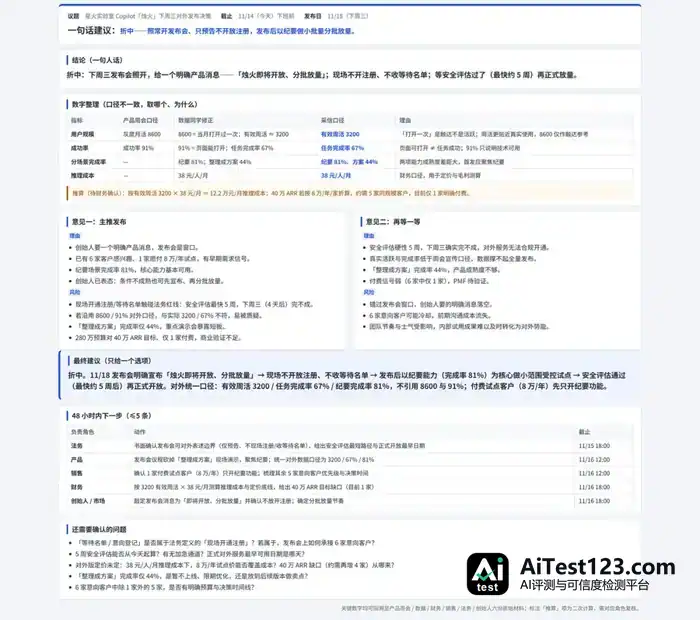
最终,Hy4 flash用了1分14秒。
它的建议是折中处理:发布会照常开,但只对外宣布即将开放、分批放量,现场不办注册,也不提前收等待名单。对外数字采用更严格的 3200 人和 67%。至于等待名单算不算开通注册,它把这一条单独列成了待确认事项。
DeepSeek-V4.1-Flash 这边花了4 分 8 秒。
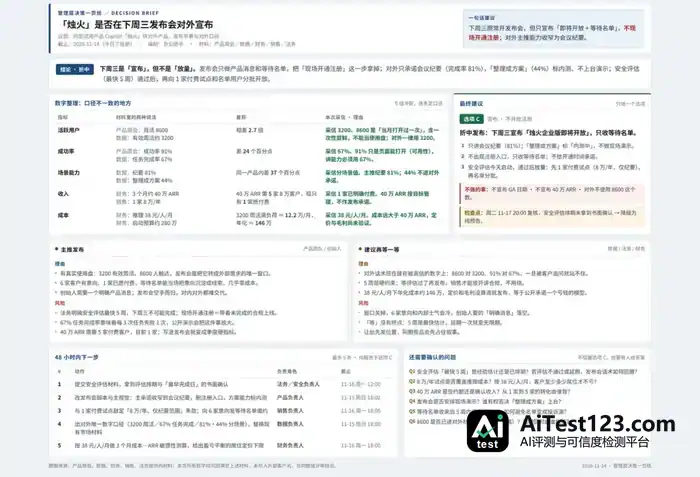
它的思路同样是折中:发布会照开,只宣布即将开放,现场不开注册;对外主推会议纪要,方案能力标成内测,数字也采信 3200 和 67%。差别在于,它认为发布会现场可以收集等待名单,之后再向名单上的用户分批开放。
这倒不能说它判断错了。法务卡住的是现场开通注册,并没有明文禁止收集等待名单。
这一轮双方的核心判断一致,要求的一页纸也都交了,质量上看不出明显差距。
速度是 Hy4 flash 在这一轮的长处:它少花了2 分 54 秒。口径冲突、发布取舍、最终交付几件事都办妥了,用时大约只有对方的三成。
02
读图决策:和 DeepSeek-V4.1-Flash 相比,
Hy4 flash 看错的更少
第二轮还是 DeepSeek-V4.1-Flash 对 Hy4 flash。这回文字提示词给得很少,而是拿测试一里的文字内容做成一张自相矛盾的投屏图片,直接喂给模型。接着让它只看这张图做决策准备,看它能不能自己挑出这些矛盾,再完成和场景一差不多的决策准备。
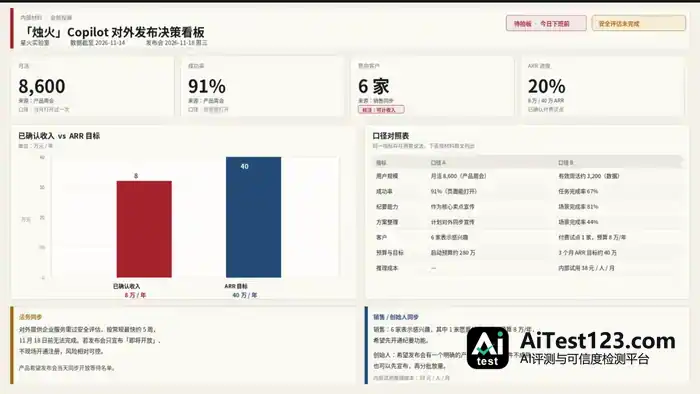
从图上能看到,最醒目的大卡片写着月活 8600、成功率 91%、意向客户 6 家,还挂着可计收入的红色标签;右下角的对照表却是另一套更严的数字。柱状图标的是 8 万和 40 万,可 8 万那根柱子实际画到了大约 32 万的高度。
最后,Hy4 flash 用时2 分 46 秒。
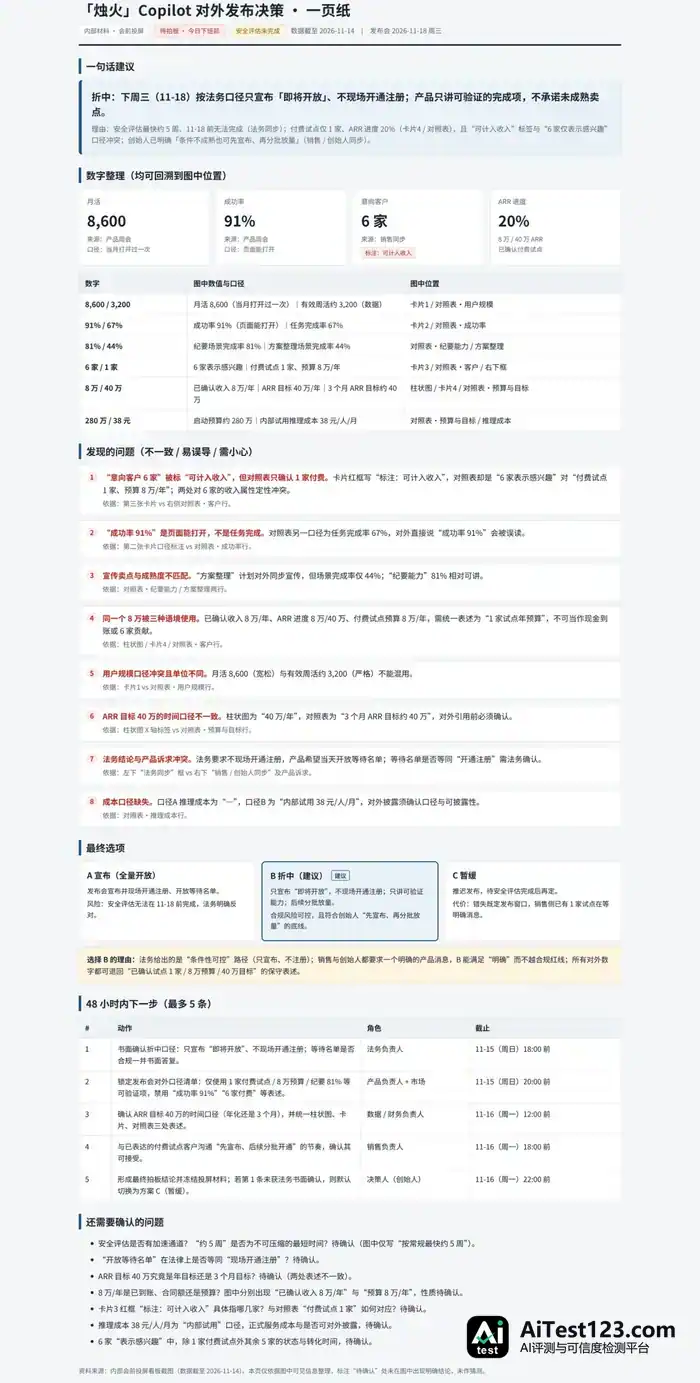
它给出的仍是折中发布:只宣布即将开放,现场不办注册,对外用更严的口径。
客户数量上,它指出 6 家意向客户那张卡片标了「可计收入」,可对照表只确认 1 家付费试点,两处对不上。
8 万元到底是已确认收入还是预算、40 万元的目标按什么时间口径算,它也都归入待确认事项。
只是 8 万元那根柱子画高了这一点,它没看出来。
DeepSeek-V4.1-Flash 用时1 分 25 秒。
它的建议同样是折中,也梳理了卡片和对照表之间的口径出入,但有两处写错。
一处是把客户卡片上的红标读成了「非付费」,和图里的「可计收入」不符。
另一处它写的是:「8 与 40 的视觉比例 20%,与 ARR 进度 20% 自洽,此处无失真。」
8 除以 40 的确等于 20%,可图上柱高并不是按这个比例画的。数字关系它算对了,图形比例的错误却漏掉了。
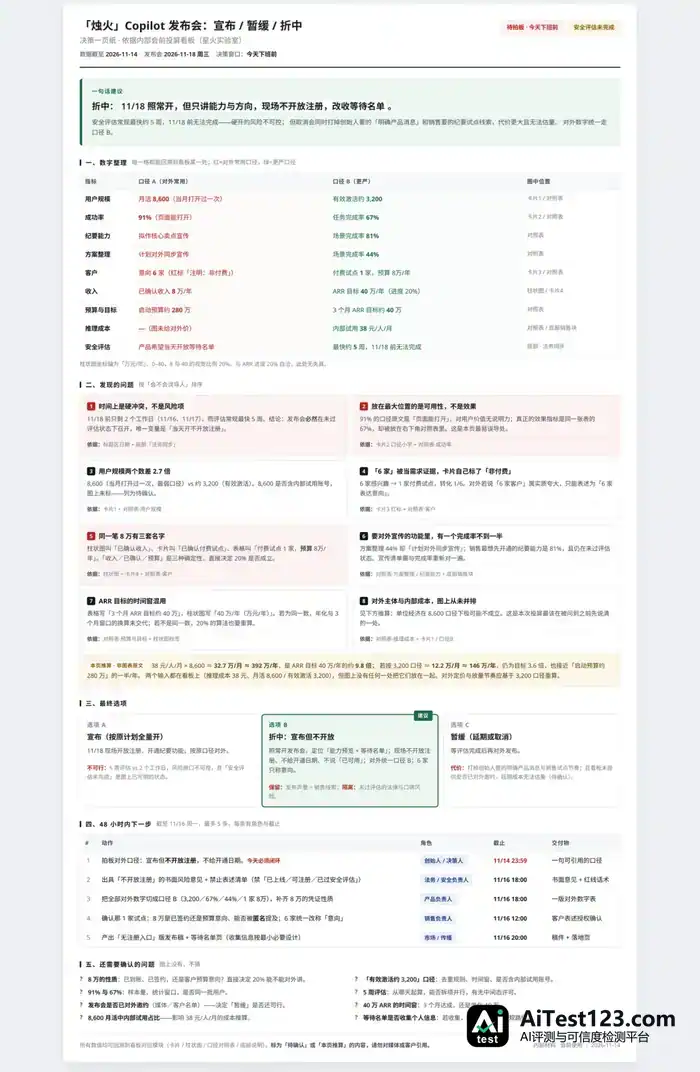
这一轮 DeepSeek-V4.1-Flash 虽然更快,却有两处明确的误判。Hy4 flash 看出了「6 家意向客户被标成可计收入、实际只有 1 家确认付费」这个冲突,整体准确率更高。
03
编程修复:结果相同,
Hy4 flash 更快,性价比也更高,
Hy4 想得更周全
第三轮把难度提了上来,给模型安排了一道编程题,让它接手一个正在使用中的库存与计价项目,上场对比的是 Hy4 和 Hy4 flash。
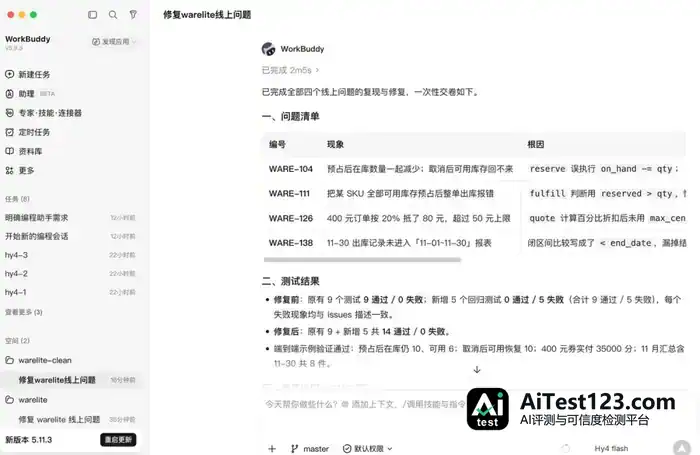
项目里的测试眼下全都能过,线上却冒出 4 个毛病:预占库存之后数字对不上,在库数量跟着一起减,取消也恢复不回来;某件商品的库存被全部预占后,整单出库直接报错;400 元订单用 20% 优惠券,抵扣超过了 50 元上限;11 月报表漏掉了 11 月 30 日当天的出库。我要求模型照着项目代码和问题清单自己把这些 bug 找出来,先写出能复现问题的测试,再动手修代码,最后交一份修复说明。
这道题考的是读别人代码的功夫,得找出既有测试漏掉的情形,还要证明改完之后的行为符合项目约定。
Hy4 flash 用了 2 分 5 秒,四个问题全部定位并修好。预占操作不再误扣在库数量,取消改为释放预占;整单出库恢复正常;优惠券抵扣按 50 元封顶;报表区间改为包含结束当天。
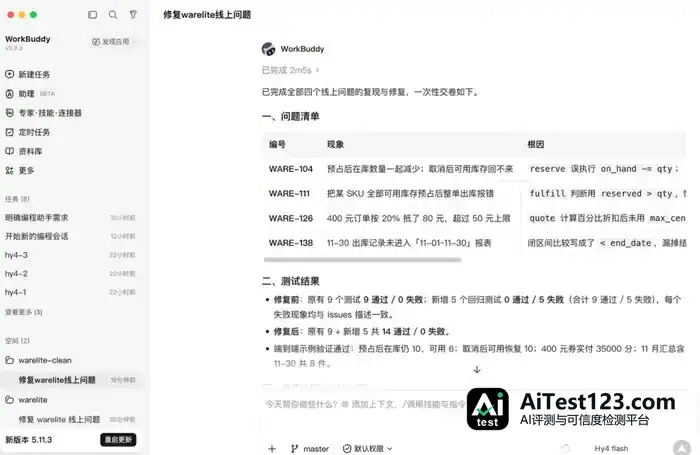
它还给原项目补了 5 个测试,端到端跑通验证:预占后在库仍是 10、可用为 6,取消后可用回到 10;400 元订单实付 350 元;11 月汇总包含 11 月 30 日,合计 8 件。
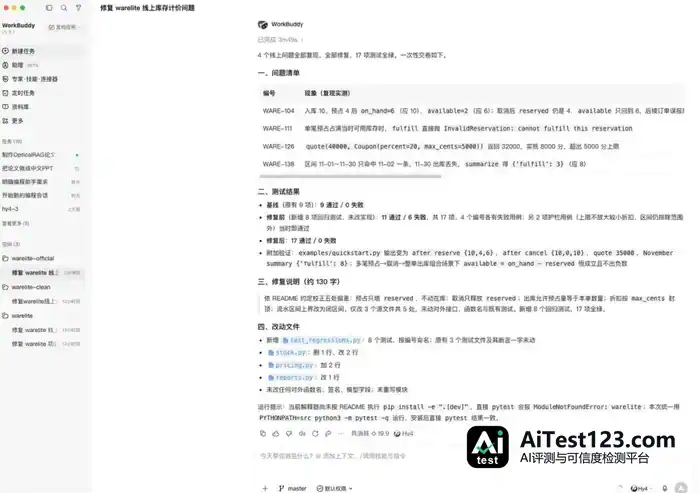
同样的任务交给正式版 Hy4,根因判断和改法跟上面差不太多,用时 3 分 49 秒。区别只在于它为项目新增了 8 个测试,流程走得更完整一些。
04
论文转 PPT:
Hy4 更清晰,Hy4 flash 更高效
前几轮碰的都是真实生产系统里的单点问题,这一轮换成端到端任务:让 Hy4 和 Hy4 flash 各自把同一份论文做成 PPT,看谁的效果更好。
论文主题是 OpticalRAG,讲的是一种给长文档省 token 的办法——先把页面渲染成图像,再在像素空间里压缩,用于检索增强生成。提示词里要求按这样的顺序组织内容:要解决的问题、核心方法(两项关键技术分开讲,必要处配示意图)、关键实验结果(数字要写上)、局限和落地时的注意事项。
这道题既要求模型读懂技术论文,也要求它有完整的多模态生成能力,能把理解到的东西做成结构清楚、数字准确、拿起来就能讲的幻灯片。
Hy4 flash 花了 9 分 5 秒,产出一份 21 页的 PPT,问题、方法、实验和局限都按要求的顺序写进去了:两项关键技术分开讲得很清楚,关键数字没有出错,连 BAMBOO 上原始分并不领先这类数据也完整呈现。美中不足的是有几页页脚和正文叠在了一起,CAP 公式里的指数没做成上标。
同一篇论文、同一段提示词,正式版 Hy4 用了 15 分 47 秒,产出 18 页,结构和关键数字同样正确,也点出了压缩感知分数第一不等于原始分数第一、长文档上按问题筛选反而低于简单均值池化这些细节。
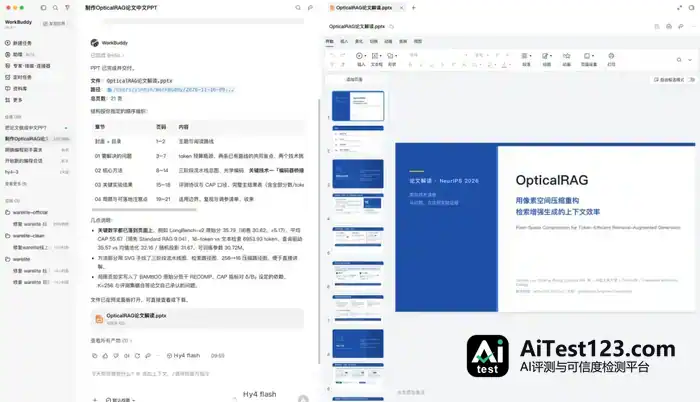
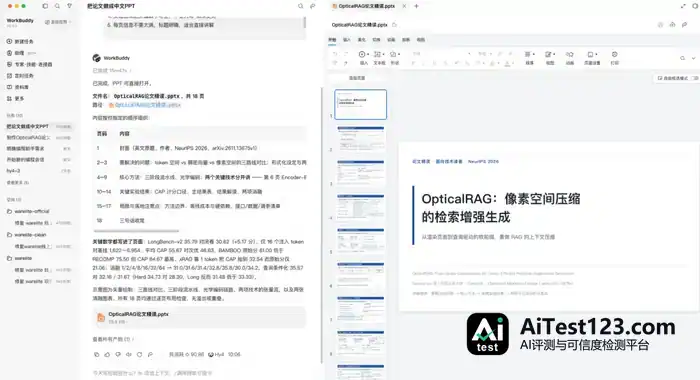
放到把长篇技术论文做成可讲解 PPT 这个场景里看,两边都完成了任务,论文要点和关键数字都写对了。Hy4 flash 胜在速度,主结果表也更完整;正式版 Hy4 用时长一些,但页面更适合直接开讲,对结论的分析交代得更清楚。
05
尾声
平心而论,Hy4 flash 也好,DeepSeek-V4.1-Flash 也好,市面上这一批 Flash 模型在准确率上跟当下的 SOTA 模型还有距离。但放到日常办公、编程修复这类任务上,它们已经达到了专业工程师和白领的水准。
再说 Agent 这种调用轮次多、上下文超长、成本很容易失控的场景,Flash 模型确实是个不错的选择。
混元官方 Blog 的建议也类似:深度搜索、文档处理、PPT 生成、简单前端展示、computer use 这些日常任务用 Hy4 flash,长程软件工程之类的复杂任务则交给智能上限更高的 Hy4。
说到底,当下各种 Flash 模型里,Hy4 flash 就是最适合过日子的一款。