Qwen4-Max与Hy4 flash同日发布:单任务成本最高降58%
大降58%!阿里、腾讯猛卷模型单任务成本,腾讯,编程,max,新模型,知名企业,单任务成本,阿里巴巴集团
11月16日,阿里巴巴与腾讯在同一天各自亮出了新一代语言模型。阿里这边推出的是全新一代基座大模型Qwen4-Max,总参数2.4T;腾讯混元上线的则是轻量旗舰Hy4 flash,总参数224B,激活参数只有12B。
双方对外披露的信息里,出现频率最高的词其实不是“参数”,而是“单任务成本”。
Qwen4-Max走的是基于Qwen稀疏注意力(QSA)的全新MoE架构,2.4T总参数仅激活71B,每个Token的激活参数比上代少了25%,还具备原生视觉能力,支持百万上下文。
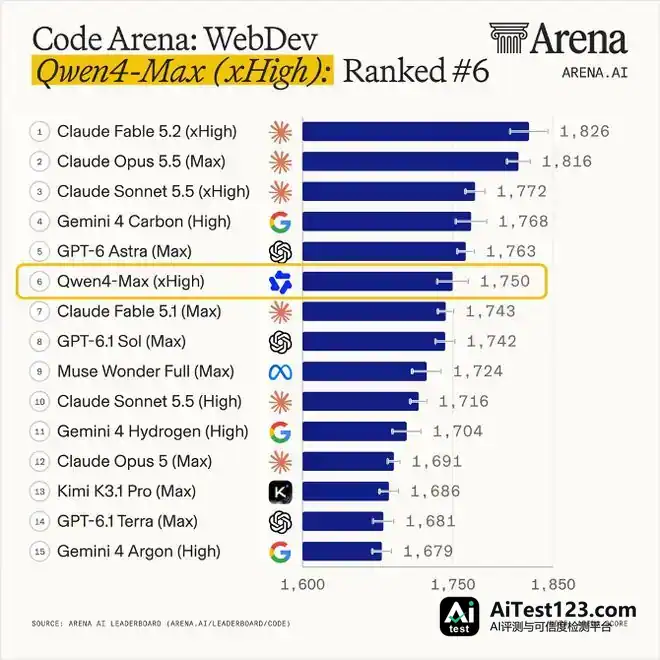
在聚焦前端编程的全球盲测榜CodeArena中,Qwen4-Max排到第六,夹在GPT6-Astra与Claude Fable5.1之间。
腾讯Hy4 flash选的是另一条路:用更小的体格换更低的成本。该模型支持多模态和1M上下文,借助混合注意力、LatentMoE、Engram等架构设计,把KV cache压到Hy4的六分之一;再配合megakernel、4bit量化等手段,解码速度超过150tps。
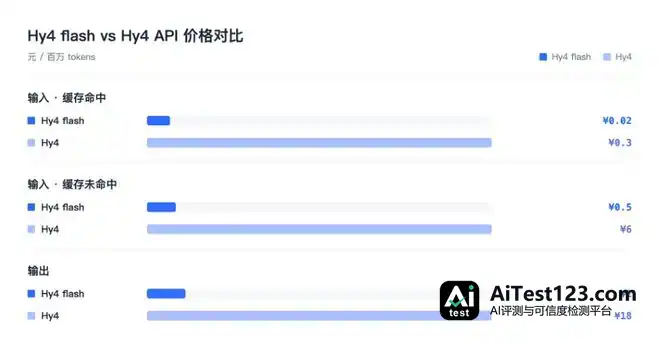
官方数据显示,Hy4 flash的综合效果略好于总参数770B的Hy4preview,可单任务成本只有后者的1/13、标准版Hy4的1/20。
成本成了第一叙事。两家谈“降本”的口径高度一致,都不再只盯API单价,而是把“完成一个任务花多少钱”(Cost per Task)摆到了台前。
阿里给出的数字是:Qwen4-Max缓存命中价格每百万Tokens低至0.5元,完成单任务的平均费用较上代大降58%。
这个数字背后是思考效率的提升。在Terminal-Bench 4.0专业编程评测中,同样处于Xhigh思考档位,Qwen4-Max每次尝试的平均Token用量从289K降到151K,少了近一半,得分却从38.9分升到48.5分。
腾讯这边,Hy4 flash每百万Token输入0.5元、输出2元,命中缓存时只需0.02元;按内部评测集综合测算,其单任务成本为DeepSeek-V4.1-Flash-1027(Max档位,忙时价格)的八分之一。
另外,腾讯在85位内部用户的盲测中显示,27类共259个任务里,Hy4 flash的用户满意度接近Claude Haiku 5.5,单任务成本在所有对照模型中最低,端到端耗时也最短。
同在一天降本,双方的方向却并不相同。阿里选择继续向上堆高智能上限:2.4T的Qwen4-Max瞄准长周期复杂任务与专业场景——编程、智能体、科研发现,并提出“迈向真实全场景”的目标。它还构建了覆盖721个细分领域的Work360全场景建模体系,并给出落地实证:在汽车制造领域,单个工件加工编程的人工用时已从475分钟降至24分钟。
Qwen4系列中的中小尺寸模型将陆续开源。
混元团队的建议很明确:深度搜索、文档处理、PPT 生成这类日常活儿,交给 Hy4 flash 就行;长程软件工程这样复杂的任务,则留给智能上限更高的 Hy4,两边形成高低搭配。腾讯走的是另一条路——往下把性价比做到极致,Hy4 flash 后续还会开源。腾讯方面对观察者网表示,混元的核心理念是“模型实用性”。