

具身智能大脑路线生变:类脑架构登场,9家公司走向4条路
机器人大脑开始分道扬镳。
本文来自微信公众号 雷科技(ID:leitech),编辑:罗超,创业邦经授权发布。
有种说法是:人跟机器人的关键差别在于,人会预判。拿运动员、电竞选手来说,有时对手动作还没做完,身体就已经先做出反应了。
可到了2026年的今天,这话已经站不住脚。预判不再是人和机器之间那条铁定的分界线。准确点讲,技术正在把这种能力交到机器人手上。区别在于,人是靠意识、经验和直觉去自然预判,机器人靠的是数据、模型和算力做“计算预判”,这就是人们说的机器人大脑。
最近这几个月,关于让机器人“先想一步”的消息扎堆出现。
6月中旬的北京智源大会上,智平方推出全球首个类脑式具身智能系统NeuroVLA,照着人脑的皮层、小脑、脊髓三层结构,把机器人的大脑重新设计了一遍。
还是6月,千寻智能的Spirit v1.6在RoboArena评测中综合得分拿下全球第一,压过英伟达的Cosmos3和Physical Intelligence的π0.5,成为首个登顶该榜单的中国模型。
VLA和世界模型这场路线之争吵了半年还没见分晓,类脑架构又冷不丁冒出来成了新热词。机器人大脑到底卷到了什么地步?以下是雷科技的看法。
VLA与世界模型走向融合,类脑架构初露锋芒
过去两年多,具身智能的主流叙事一直是VLA一统天下。
VLA是视觉—语言—动作大模型的缩写。说白了,就是让机器人把看到、听到的东西转成动作。谷歌的RT系列、Physical Intelligence的π0、智平方的GOVLA、智元的 GO-1、千寻的Spirit系列,大体都走这条路。
VLA的长处是语义理解。你让它把桌上的苹果放进篮子,它能规划出一条像样的轨迹。短板也挺明显:它对物理世界的理解,很大程度上靠训练数据里学到的经验。任务一复杂、执行时间一拉长,或者碰上训练中没见过的物体和环境,模型就容易判断跑偏,甚至做着做着就偏离了原本的任务目标。
于是,行业开始试着把世界模型引进来。
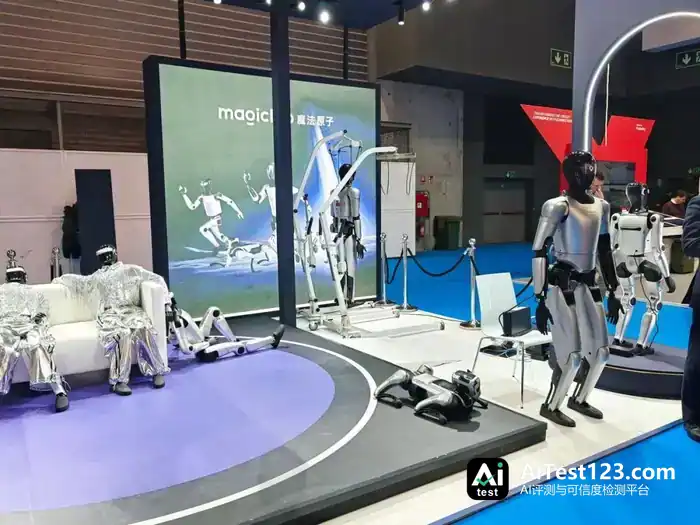
世界模型,可以先理解成机器人脑子里的预演系统。真正动手之前,它先预测环境会怎么变、自己的动作会带来什么结果。比如机械臂伸过去拿杯子,要是从侧面抓可能碰到旁边的盘子,那就得提前考虑换一条路线。
图源:雷科技
关键在于让机器人慢慢学会预测环境变化。以前它更多依赖学过的动作经验;现在研究者希望它能结合当下环境,推断下一步会发生什么,再挑更合适的动作。
从年初起,“世界模型vsVLA”在行业里吵了差不多半年。吵到最后,头部公司几乎都选了混搭。
智元就是给VLA配上世界模拟器,用模拟出的世界演变补上物理理解的短板,GE 2.0正是这套思路的代表。
高继扬(星海图CEO)在一次采访里提到,VLA与世界模型在底层是相通的,二者都用Transformer来处理交互数据;真正的差异落在监督方式和架构细节上,往后两者会融合。
智平方的郭彦东也表过态:世界模型起的是加持作用,并非颠覆者。千寻的Spirit v1.6则是把两者深度结合做出来的成果,环境感知、任务理解、动作规划、状态预判被串成一条端到端链路,它之所以能在RoboArena登顶,原因也在这里。
结果就是,上半年还在站队的公司,下半年悄悄都成了融合派。
而就在大家觉得融合就是终点的时候,“类脑”这个词,又开始高频出现在发布会和新闻里。
模仿人脑的类脑架构要普及,需解决三大难题
类脑架构说起来并不玄乎,它只是不再指望用一个巨型模型包打天下,而是改成人脑的分工方式,把思考和动作拆给不同层级去执行。
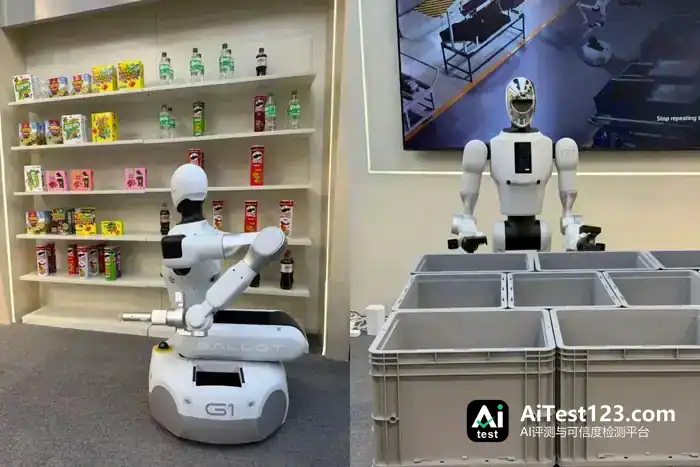
智平方的NeuroVLA就照人脑的结构分了三层。最上层叫“皮层”,负责语义理解和任务规划,管的是全局思考;中间一层是“小脑”,承担高频运动协调与动态修正,每秒几百次读取关节传感器,专治抖动、及时纠偏;最下面一层是“脊髓”,负责毫秒级的运动执行和安全反射,由脉冲神经网络驱动,功耗仅0.4瓦,碰撞发生后20毫秒内即可完成反射动作。
图源:雷科技
这三层,对应的是机器人绕不开的三大难题。
先说功耗。人脑860亿个神经元,运转起来只要20瓦左右;大模型一跑动辄几千瓦,机器人端侧根本背不动。于是最耗电的思考被交给皮层,高频协调和反射则压到小脑和脊髓上。
再说实时性。安全反射这类动作,等不起云端推理——中间可能有延迟,必须在本地毫秒级完成。数据效率方面,类脑架构的长处更多在于不同层级能针对各自任务分别训练和优化,不必让所有任务都压给同一个大模型去学。不过这不等于整个机器人系统就不需要大量数据了,底层运动控制同样得持续积累真实交互经验。
类脑也不是智平方一家在做,从各家具身智能企业的动作就能看出来。银河通用的银河星脑AstraBrain,官方定位是全球首个集“大脑—小脑—神经控制”于一模的全身端到端具身大模型,2025年还在计算机视觉顶会ICCV上提出过“世界—动作模型”WAM,今年8月又发布了通用大脑基座模型AstraBrain WAM 0.5。
星海图的EFM-1走的是“慢思考VLM加快执行VLA”的双系统架构,思路和分层类脑同源;自变量的WALL系列,则做“大小脑统一”的端到端路线。
看得出来,类脑是一个正在形成的行业方向,只是各家给出的解法并不一样。
那为什么不能指望一个巨型模型把动作也直接“承包”了?源策未来的CEO李天羽在腾讯全球数字生态大会上这样表示:
眼下大模型的主流做法,不妨理解成“把机器人当成一款游戏来通关”。可机械臂动起来时,中间还得靠coding搭桥,或者走大规模reasoning推理这条路,推理长度平均能到数千Token。到了这个Token量级,执行频率再怎么优化也上不了1赫兹,具身应用的要求根本够不着。
就算算力管够、Token秒出,让机器人以10赫兹的速率跑起来,按现在的推理强度7×24小时连跑一个月,一个月的Token成本就是千万级人民币。
这个数量级的差距,不是今天芯片的发展能够弥补的。李天羽由此认为,之后即便是具身的、用来调度的大脑,也一定会向小型化发展。
源策未来本身就是做具身智能的,主要研发“通用全身人形基座模型”,让机器人能调动四肢、躯干完成复杂全身任务。李天羽也是 WAIC 2026 云帆奖"明日之星"获得者,所以他这番话,一定程度上代表着行业对待这个趋势的态度与看法。
源策未来那边怎么看?具身智能企业先砸钱做大脑,道理在于:基础预训练模型够强之后,往下做任务适配时,要采的数据量、采集难度都会降下来,应用也就有了铺得更快、做得更大的空间。
机器人大脑路线确立,头部玩家浮出水面
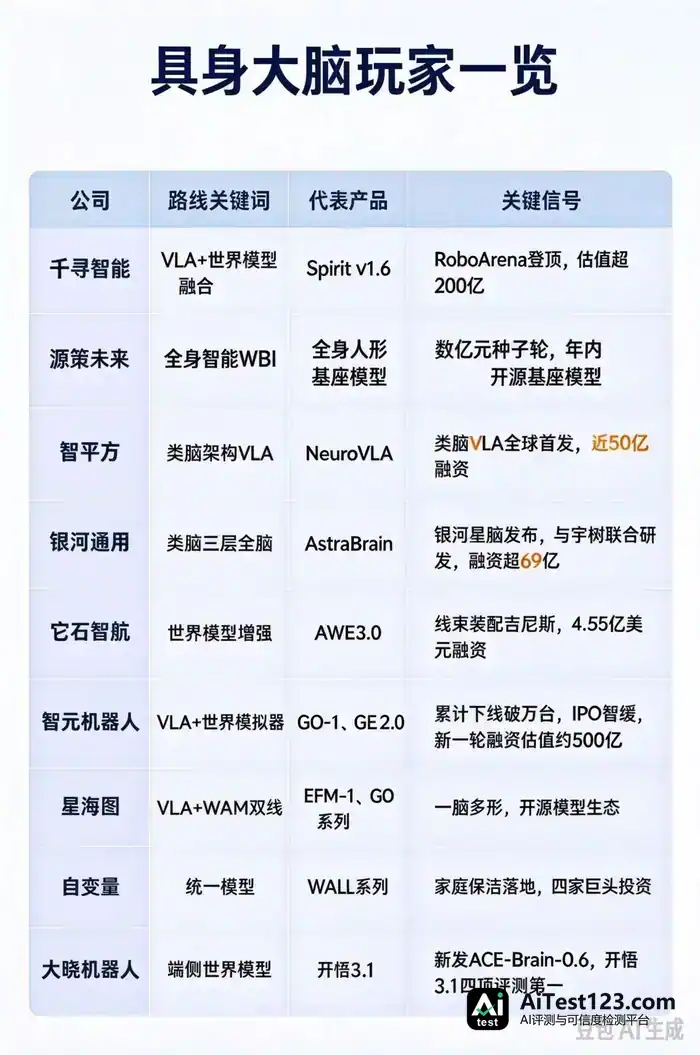
按技术路线来拆解机器人大脑,至少能看到四条清晰的路线。
分别为:世界模型原生路线、VLA与世界模型融合路线、类脑架构路线、统一模型路线。
世界模型原生这条路,是在架构上把世界理解、生成和动作预测塞进同一条推理路径。走这条路的代表有大晓机器人的开悟世界模型、优必选的Thinker-WM、智元的GE 2.0和星海图的G0.5。
VLA与世界模型融合路线,把世界模型当成VLA的增强层,代表是千寻的Spirit v1.6和星动纪元的ERA-42。
类脑架构路线,借鉴人脑机制追求小数据高效学习,代表是智平方的NeuroVLA和银河通用的AstraBrain。
统一模型路线则很好理解,就是用一个模型走到底。
具体玩家一览以及路线分布,大家可以参考下方图片:
图源:豆包制作
得说清楚,具身智能大脑眼下还没有严格统一的技术分类标准。前面那四条路线,主要是按模型的核心能力、架构设计和系统组织方式来划分,是对头部企业技术探索的一个归纳。它们之间并非完全互斥,有的企业甚至几条线同时在下。
国际玩家这半年动作同样不少。
英伟达在这条链路上的身份比较特殊——世界模型Cosmos由它提供,开源人形机器人基座GR00T由它推动,RoboArena的联合发起方里也有它。Physical Intelligence这边,π0.5在RoboArena上被千寻反超,但更新版本π0.7仍在继续迭代。
谷歌的做法是把Gemini Robotics 2一拆为二,规划模型和执行模型分别对外提供。
真正搅动局面的是通用大模型的入场。OpenAI在9月确认要自研人形机器人;也有研究尝试把GPT-6与π0.5搭配起来充当机器人策略。银河通用的研究员做过对比评测:在RoboDojo的10项双臂操控任务中,混合系统平均分62.6,明显高过GPT-6单独直驱的37.81分。但一碰上精细力控和接触稳定性这类任务,还是得靠π0.5这种真正练过物理交互的模型来兜底。
相比国际玩家,中国公司在这轮大脑竞赛里站位相当靠前,落地场景也比海外更密集。
不过,要说格局已经定了,还太早。
四条路线都还在快速演化,类脑架构刚刚冒头,终局方案是谁尚无答案。就连“类脑”这个说法本身,有多少是技术判断、多少是叙事包装,也得交给时间检验。
写在最后
具身智能有个特点很像汽车行业:模型的能力必须经由机器人本体体现出来。
大脑再聪明,机械臂抓不稳东西,或者传感器感知不准、控制系统跟不上,任务照样很难完成。反过来,硬件再强,模型只会重复固定动作,也适应不了复杂环境。
所以接下来的竞争,恐怕越来越看企业的综合能力。模型得持续进步,真实数据得不断积累,机器人本体要足够可靠,还得找到让技术真正发挥作用的应用场景。这几个环节互相牵制,缺了哪一环,整体进度都可能被拖慢。
类脑架构会不会成为主流、世界模型能不能带来新突破,眼下下结论都太早。具身智能最终要面对的,是一个不会按测试脚本运行的真实世界;机器人大脑的进步是真是假,也得在这个世界里接受检验。
该文由专栏作者授权创业邦发布,版权属于原作者。文中观点仅代表作者本人,与创业邦立场无关。若需转载,请与原作者取得联系;有其他问题可发邮件至 editor@cyzone.cn。
















