DeepSeek开放全家桶API:联网搜索等能力打包,价格不足OpenAI 8%

资讯 InfoQ 作者:褚杏娟 全文 4749 字 · 约 12 分钟读完 配图 5 张 分类ClaudeDeepSeekOpenAIAnthropicDeepseek

除收取 Token 费用外,也将收取相关工具的调用费用

所属频道 大厂动态Claude 与 Anthropic开源生态

让大模型开口答题不算难事,难的是让它上网搜索、翻读网页、解析PDF,最后把找到的信息整理成带引用的答案。这套工具系统,开发者通常得自己另搭一套。AI应用开发里,这层工程负担常被忽略。

11月13日,DeepSeek宣布开放“全家桶应用 API”,想把这部分活接过去。官方App和网页端在用的联网搜索、深度思考搜索、文件输入、网页阅读等能力,被整合进现有API;搜索、网页抓取、OCR、ASR和TTS等独立接口也一并开放。

DeepSeek表示,开发者靠这些能力,能做出与官方App基本一致的对话体验,甚至把整个DeepSeek App 1:1复刻出来。

联网搜索和网页阅读的用法是:开发者在API请求里声明相应工具,模型按任务需要自己决定调不调用,搜索、网页抓取和上下文处理都交给DeepSeek服务端。文件输入则要先经Files API上传解析,拿到返回的文件ID后再加入对话。OCR、ASR、TTS等能力,可以通过独立接口调用。

开源项目《GSYVideoPlayer》作者恋猫在知乎上评价:“产品化之后确实不一样了,DeepSeek 这都开始把自己的 App 能力拆出来了,从搜索到 OCR、再到语音,这个感觉怎么有种冲着百度来的即视感。”

价格上,官方说法是:调用DeepSeek API使用扩展能力,Token费用照收,相关工具的调用费另计。具体价目如下:
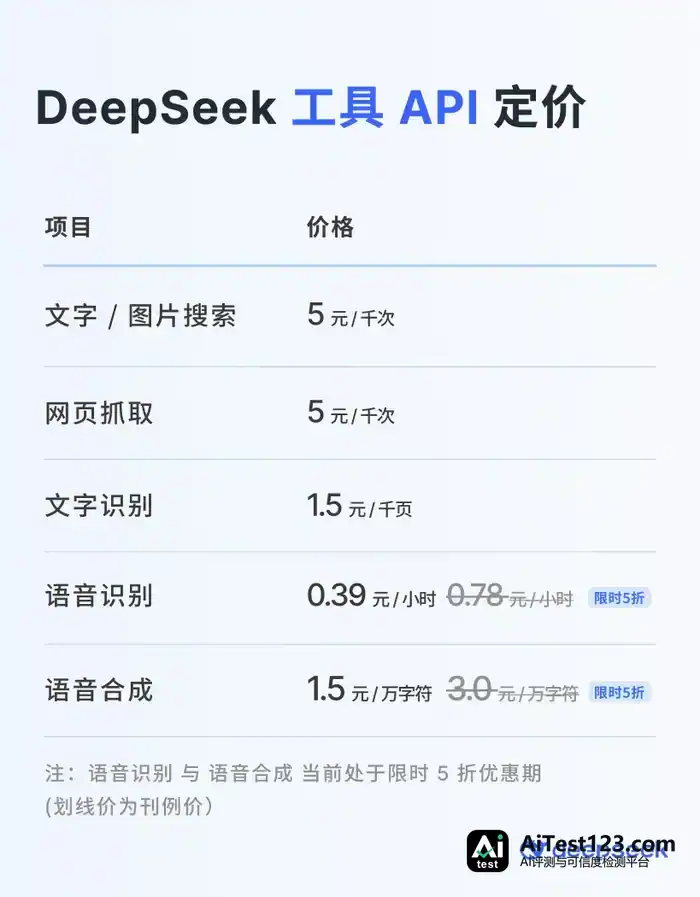
DeepSeek开放全家桶API:联网搜索等能力打包,价格不足OpenAI 8%(配图 1)

知乎用户药尘 Ray 算过一笔账:“我按官方价格表算了一下,写一篇带资料检索的文章,成本不到 4 毛钱。”他总结称,“API 的钱已经便宜到可以忽略,贵的是三样东西:控制调用次数的工程、合规,以及你自己的判断。第三样最贵。”

在DeepSeek App里用过免费语音聊天的用户说,文字转语音的效果“其实是有点拉的”。商用API要是也这水平,“那这个价格就不值了,不如火山引擎接豆包”。

也有用户提到,语音识别和语音合成的定价看着“有点抽象”,但整体不算高,估计是给没法自行部署这两类服务的用户留个兜底选项。至于文字识别,算下来未必比百度划算:百度为 2.5 元/千页,价格更高,不过提供 1000/2000 次免费额度。

这条路上其实早有先行者。OpenAI、Anthropic和Google都在用各自的API,把模型、搜索、文件处理和工具执行捆在一起。DeepSeek这次补上应用层能力,模型厂商的竞争随之伸向开发者过去自己维护的工具链。

有用户把三家的价格摆在一起比:DeepSeek联网搜索每千次5元,OpenAI和Anthropic的同类工具每千次都是10美元。

从调模型到调完整应用,开发者能省掉哪些环节?

过去的做法是,开发者在请求里向模型声明可用工具。模型判断需要查外部信息,就返回工具名称和参数,应用程序照着参数去搜索、查数据库或做其他操作,再把结果送回模型。工具选哪个由模型定,可工具怎么执行、什么时候重试、回传什么数据,主要落在应用程序身上。

任务一复杂,这套流程就繁琐起来。比如一个要多次搜索的Agent,一轮对话里可能产生好几次工具调用。每次调用都牵扯数据传递、结果整理和上下文更新。不同工具的参数格式、调用失败、模型用错工具,也都得开发者兜着。

DeepSeek这次给出的服务端工具,改的正是其中一部分流程。

官方开发文档写明,开发者可在现有API请求中声明`deepseek_web_search`和`deepseek_read_url`两个工具,前者管联网搜索,后者管读取用户给的链接。

非思考模式下,模型能根据用户问题自动搜网页或图片,生成带来源引用的回答。切到思考模式,模型还能在推理过程中反复搜索、打开网页、查找页面内容。DeepSeek称,思考模式下模型最多可执行约20次工具调用,涵盖联网搜索、打开网页和页内查找,让它在多步推理中持续检索、核对信息。

开发者自己组织搜索流程时的那摊事,新接口把搜索决策、工具执行和结果处理都挪到了服务端。客户端不必再分别向搜索和抓取接口发请求。

返回结果里,工具调用记录、搜索结果和引用信息照样保留。开发者要把这些内容正确显示在界面上,并在后续对话中按协议回传相关内容块;DeepSeek提供的服务端搜索工具,则不用自己执行。

需要联网问答、新闻检索、资料查询的应用,对这种变化尤其受用。官方维护的搜索链路可以直接拿来用,精力更多放在业务功能和用户体验上。

文件处理思路类似。新版API支持把PDF、Word、PowerPoint和图片上传到DeepSeek Files API,解析完返回文件ID,再加入对话。识别方式可选纯文本,也可选图文混排。

选后者,文档里的图片、图表和示意图能被提取出来,按原始位置跟文字一起交给模型。开发者不用再另外拼OCR和基础文档版面解析服务,就能让模型读一部分图文混杂的复杂材料。

但文件解析仍要走上传和引用两步。官方也明说,图文混排识别不保证提取所有图表,解析后的图片照样消耗模型输入Token。

DeepSeek还单独开放了Search、Fetch、OCR、ASR及TTS接口。开发者可以用服务端自动编排,也能把独立工具接进自己的工作流。

事实上,自研搜索引擎的Search和Fetch API早在10月17日就由DeepSeek放出了。这次发版真正的增量,是把这些底层工具往模型对话里再塞了一层,让服务端把过去应用端扛的那部分活儿接了过去。

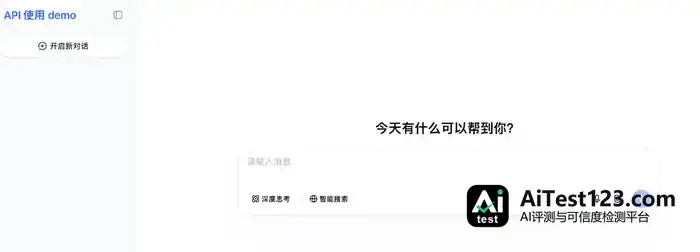
为了让外界看清这种变化,DeepSeek在GitHub上把chat-demo项目开源了。流式对话、搜索、文件输入、语音交互、历史记录导入以及多种消息渲染,这个项目都带。开发者填好API Key就能跑起来,静态版本连独立的应用后端都不用配。
DeepSeek开放全家桶API:联网搜索等能力打包,价格不足OpenAI 8%(配图 2)

OpenAI、Anthropic 早已入场

AI应用从单纯聊天走向多步骤任务之后,模型厂商慢慢发现,光给一个文本生成接口,撑不起完整的产品体验。搜索、数据检索、代码执行、文件处理、工具调度,这些开始被算进API平台的必备项。

OpenAI这边,Responses API已经能提供托管式联网搜索和文件搜索等工具,其中文件搜索让模型去查已上传的文件。开发者建好向量存储、把资料传上去,检索工具的执行就交给OpenAI,向量索引和语义搜索逻辑不用自己写。

不过要说明一点,OpenAI的文件搜索走的是知识库RAG路线,DeepSeek这次开放的文件功能,主要是上传解析之后把文档内容塞进模型上下文。两者覆盖的开发需求有部分重叠,底层的处理流程和适用场景并不完全一样。

Anthropic同样在Claude Messages API里放了服务端网页搜索和网页获取工具。

这种模式下,Claude能直接执行搜索、读取网页,开发者不必自己搭一整套执行环境。搜索次数限制、域名过滤、结果引用这些控制项,Anthropic也给了。更新的工具版本还加了动态过滤:在搜索结果或网页内容进入模型上下文之前,允许Claude用代码先筛一遍相关信息,把无关内容带来的Token消耗压下来。

Google走的是Gemini API,提供Google Search Grounding、URL Context和File Search等工具。内置搜索和网页读取能在一次模型API调用里做完,工具由Google负责跑,结果再交给模型。

几家厂商的做法各有不同,方向却已经比较清楚:原本散落在应用框架、检索工具和第三方服务里的部分能力,正在被收进模型厂商自己的API体系。

对开发者来说,门槛因此降了。以前要接好几个外部工具才能实现的功能,现在开几个参数,基础版本可能就出来了。

模型厂商这边,竞争的范围也跟着变大。开发者挑某个模型API时,看的不再只是模型质量、推理速度和Token价格,还包括搜索结果、文档处理、工具执行的稳定性、开发是否省事,以及服务端能替自己承担多少工作。

DeepSeek还有一处设计值得看:这次新增的功能同时支持Messages、Responses和Chat Completions三种接口,里面包含Anthropic和OpenAI风格的协议。

已经在用相应API协议的开发者,因此有机会沿用现有客户端或部分调用结构,迁移成本能降一些。但协议兼容不等于所有模型能力、参数和工具都能直接替换,具体还得看各家实现。

DeepSeek目前明确支持这些应用层功能的,是V4.1-Flash模型。开发者想用它的托管搜索和文档处理能力,得先掂量对应模型是否合自己的业务需求。

少写了代码,也交出了一部分控制权

工具编排挪到模型厂商服务端之后,一个问题跟着冒出来:开发者对模型执行过程的控制,还能剩下多少?

DeepSeek的新接口就是个具体例子。官方文档写得很清楚,开发者开启托管联网搜索或网页阅读工具时,不能用`tool_choice`强制指定模型执行其中某个工具,否则会返回400错误。搜不搜、读不读链接,由模型自己判断。

另外,托管搜索的域名白名单、黑名单等控制参数,DeepSeek目前还没开放。应用如果要限定搜索来源,开发者仍得走独立的Search、Fetch接口,或者自建工具链。DeepSeek还给部分API参数设了限制:开发者声明托管联网工具、开启高级安全校验或启用会话标题时,部分生成与工具控制参数由服务端决定,传了也不生效。

普通聊天应用这么处理可能挺方便,可对需要强制检索的业务流程来说,这意味着开发者没法再简单靠原有的工具选择参数来保证执行。

参数控制这块更得留意。DeepSeek文档显示,启用部分托管工具或安全功能后,某些请求参数由服务端拍板,开发者传了也会被忽略。对于靠固定配置做模型评测、重复执行任务,或者需要精确限制外部工具调用的应用,这是个得提前考虑的变化。

在Messages API中,这些参数包括`temperature`、`top_p`、`top_k`及部分思考控制参数;

在Responses API中,包括`max_tool_calls`、`parallel_tool_calls`等;

在Chat Completions API中,则涉及`seed`、`temperature`和`top_p`等。

OpenAI 和 Anthropic 的部分托管工具则能限定域名、限制调用次数,两边做法不一样。说到底,这是模型服务平台在设计上做的取舍:封装得越全,开发者要操心的细节就越少;可要是想自己定搜索策略、安排工具执行顺序、处理异常,那编排层恐怕还得自己留着。

针对这类需求,DeepSeek 把独立的 Search 和 Fetch 接口开放出来,等于多给了一条路。开发者可以不走托管式搜索,查询词自己写、返回结果条数自己定、网页抓取也自己抓,拿到结果后再决定怎么交给模型。

这么看,做简单问答、原型开发或者标准化助手,服务端托管明显省事;产品要是看重数据来源、执行可审计性和复杂业务规则,自建工具链依然有价值。

参考链接:

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 终于来了!DeepSeek多模态视觉模型API全面开放

    DeepSeek此次推出多模态视觉理解模型,标志着其从纯文本大模型向多模态AI全面进军的战略升级。业内分析认为,DeepSeek此次推出的多模态视觉模型,在保持纯文本能力不妥协的前提下,将视觉理解Agent能力推至接近行业顶尖水平Opus-4.8。随着多模态API的全面开放,开发者生态有望迎来新一轮创新爆发。

    来源 TechWeb
  2. DeepSeek发布全家桶应用API

    DeepSeek正式开放全家桶应用 API:在原有API中开启对应参数,即可获得深度思考搜索、文件输入等对话功能;语音及相关底层能力也已开放独立接口。开发者可以在自己的应用中轻松实现复杂的对话功能,甚至1:1复刻出完整的DeepSeek App。

    来源 华尔街见闻
  3. DeepSeek Harness成了第一个让我上瘾的Agent

    作者|董道力(微信ddl941110)编辑|王兆洋(微信Geisterspiele)用了 DeepSeek Harness(DSH)一段时间后,最大的感受并不是它的能力有多强,而是它能激发一种让人“随时想 build”的冲动。通常来说,没有想聊的话题,我不会打开 Claude,没有要写的代码,我也不会点开 Codex。

    来源 腾讯网
  4. DeepSeek开放全家桶API:对话功能可一键复刻,语音OCR等独立接口上线

    在 DeepSeek App(含网页端)的对话服务中,联网搜索、文件输入、阅读链接、语音交互及安全等能力与模型推理相互配合,构成了用户熟悉的对话体验。而开发者如果想要在应用中实现类似功能,除接入原有 DeepSeek API 外,往往还需耗费大量精力去对接外部工具、处理调用衔接。 今天,我们正式开放这套全家桶应用 AP

    来源 腾讯网
  5. DeepSeek开放全家桶API:对话语音OCR等能力可独立调用

    11月13日,DeepSeek把全家桶应用的API正式对外开放。开发者只要在原有API里打开对应参数,就能拿到深度思考搜索、文件输入这类对话功能;语音以及相关底层能力也放出了独立接口,OCR、ASR、TTS等都包含在内,可以单独调,也能组合着用。

    来源 网易科技
  6. DeepSeek宣布开放全家桶应用API:开发者可1:1复刻出完整的DeepSeek App

    11月13日,澎湃新闻记者获悉,DeepSeek开放了全家桶应用API(接口)。开发者只要在原有API中打开对应参数,就能获得深度思考搜索、文件输入等对话功能。语音和相关底层能力也已作为独立接口开放,涵盖OCR(光学字符识别)、ASR(自动语音识别)、TTS(文本转语音)等,可以单独调用,也能组合使用。

    来源 网易科技
  7. 用户爆料DeepSeek App和网页版出现使用限额

    【TechWeb】11月16日消息,据多名用户在社交平台发帖反馈,DeepSeek已对App与网页版的长对话功能实施了使用限额。 有用户在使用DeepSeek时被提示因“算力不足,不再支持超过7天不活跃的长对话”,并对单次输入文字的上限进行了调整,缩短至4万字左右。 此外,还会限制每日的对话额度,当用户日使用量达到上限

    来源 AI 行业观察
  8. DeepSeek App与网页版设使用限额:长对话7天不活跃不再保留

    有用户在使用DeepSeek时被提示因“算力不足,不再支持超过7天不活跃的长对话”,并对单次输入文字的上限进行了调整,缩短至4万字左右。值得注意的是,截至发稿,DeepSeek尚未就此次限额发布单独的正式公告,也没有给出额度恢复的时间表。对于依赖DeepSeek进行日常工作的用户而言,明确额度规则和恢复预期,与获得算力

    来源 TechWeb
  9. DeepSeek App与网页版设使用限额:长对话7天不活跃即失效

    有用户在使用DeepSeek时被提示因“算力不足,不再支持超过7天不活跃的长对话”,并对单次输入文字的上限进行了调整,缩短至4万字左右。值得注意的是,截至发稿,DeepSeek尚未就此次限额发布单独的正式公告,也没有给出额度恢复的时间表。对于依赖DeepSeek进行日常工作的用户而言,明确额度规则和恢复预期,与获得算力

    来源 TechWeb
  10. DeepSeek限流调整:长对话不再续用,单次输入上限约4万字

    11月16日,科创版日报,因算力资源供给紧张,DeepSeek面向普通用户的App及网页版对话服务推出限额使用措施。据多名用户反馈,DeekSeek出现弹窗提示,受算力约束,不再支持存续超过7天且无活跃交互的长对话,这类闲置会话将无法接续使用,与此同时下调单次输入文本上限,当前单次输入文字上限约为4万字。此外,还会限制

    来源 腾讯网
  11. 无界前沿开源Fx-Bio-1031:生信盲测超GPT-6与Opus-5

    无界前沿正式开源生物信息大模型Fx-Bio-1031。该模型采用125B参数MoE架构,支持本地私有化部署,确保数据不出域。在Anthropic发布的BioMysteryBench困难子集测试中,Fx-Bio-1031取得70.59%的Pass@5成绩,显著高于GPT-6-Astra和Claude Opus-5。模型具

    来源 AI 应用前沿
  12. DeepSeek把搜索压到一次半分钱,还开源了聊天界面

    11月13日晚上,DeepSeek 悄无声息地发了一份技术公告,没有新模型跑分,没有发布会直播,却让大洋彼岸恨得牙痒痒。 这一次,DeepSeek干了一件违背过去二十年互联网祖训的事: 它抄起手术刀,把自己引以为傲的国民级App“大卸八块”,然后把心肝脾肺肾摆在柜台上,按斤论两往外批发。 网盘搜索,5块钱1000次,折

    来源 AI 行业观察
  13. DeepSeek App与网页端限额:长对话7天不活跃停用,日额度触顶

    IT之家 11 月 16 日消息,昨日有部分用户反馈称,DeepSeek 已对 App 与网页版的长对话功能实施了使用限额。 多名用户收到平台提示,称因“算力不足,不再支持超过 7 天不活跃的长对话”。与此同时,单次输入的文字上限被缩短至 4 万字左右,每日对话额度也受到限制,当日使用量触顶后,页面会显示“因服务器繁忙

    来源 AI 行业观察
  14. DeepSeek调整App与网页端额度:长对话、输入字数、每日用量均受限

    11月16日,DeepSeek被曝对App及网页端部分使用场景实施限制。多名用户收到平台提示,称受算力不足影响不再支持超过7天未活跃的长对话;部分用户单次输入上限调整至约4万字,当日用量达到一定程度后会提示服务器繁忙、额度已达上限。官方状态页显示服务正常,但10月记录7起服务异常,11月部分服务仍出现过中断或性能下降。

    来源 凤凰科技
  15. NaiveAI新模型实测:速度超DeepSeek约3.3倍,编程基准领先3.7分

    硅谷硬核技术媒体Latent Space首期实测中国开源模型Naive-N0.5-Flash。结果显示,该模型在编程基准测试中超越DeepSeek V4.1和GLM 5.3,极速模式下峰值速度达2100 Token/s,响应时间仅3.1秒。文章分析了其在3D渲染等复杂任务中的表现,以及“AI驱动研发”背后的技术逻辑,折

    来源 AI 应用前沿
  16. DeepSeek调整使用规则:7天历史对话、4万字输入与每日额度

    DeepSeek近期对App及网页版实施长对话使用限制,涉及历史对话保留、单次输入长度和每日对话额度。用户反馈称,此举与平台算力资源承压有关。具体调整包括:不再支持超过7天未活跃的长对话历史,单次提问输入上限降至约4万字;新增每日对话额度,达上限后系统提示“因服务器繁忙”。

    来源 AI 产业速递
  17. DeepSeek开放App全套能力:聊天前端也开源,仅V4.1-Flash可用

    昨晚 DeepSeek 发了个挺实在的更新:把网页版和 App 背后的整套工具搬进了 API。联网搜索、读链接、解析文档图片、语音听写和朗读,都能靠几个参数接进自己的应用。甚至连前端页面也一起开源了。点开在线地址,或者下个压缩包双击 index.html,填上密钥就能用。更实在的是,它还支持把你在 DeepSeek 官

    来源 腾讯网
  18. 算力承压,DeepSeek开启限额使用

    11月16日消息,近日,多名用户反馈,DeepSeek对App及网页版的长对话功能实施使用限制。根据用户反馈,DeepSeek提示,受算力资源不足影响,暂不再支持超过7天未活跃的长对话。 与此同时,DeepSeek还调整了单次输入文字上限,将输入长度缩短至约4万字。此外,平台还对每日对话使用额度进行限制。当用户当日使用

    来源 AI 行业观察
  19. DeepSeek对免费用户限额:长对话、日额度、输入长度均受限

    据第一财经,11月16日,不少用户在社交媒体上反映,DeepSeek近期对App及网页版的使用额度进行了调整,包括限制长对话、每日使用额度以及单次文字输入长度,原因是“算力不足”。部分用户甚至在使用不到两小时后,就收到了额度耗尽的提示。截至发稿,DeepSeek官方尚未发布统一的限额规则及相关说明,也未披露限制何时解除

    来源 腾讯网
  20. DeepSeek App与网页版长对话限额,日使用量设上限

    DeepSeek对App/网页版的长对话进行了限额使用。多名用户反馈,DeepSeek提示因“算力不足,不再支持超过7天不活跃的长对话”,并对单次输入文字的上限进行了调整,缩短至4万字左右。此外,还会限制每日的对话额度,当用户日使用量达到上限时,会提示“因服务器繁忙,使用额度已达上限。”(财联社)

    来源 AI 行业观察
向下滚动自动加载更多




