

可灵Image 4.0实测:单图生成2000字,放大看细节仍清晰
像人脸上的细纹、手指的纹路、钻戒的真实感,还有脸上的雀斑,依旧是清晰可见。
可灵推出了Kling Image 4.0。
金磊在凹非寺,量子位公众号QbitAI那边写了这事儿,不过咱们还是先看图说话。
真的挺让人惊讶。
来,先看一张图:
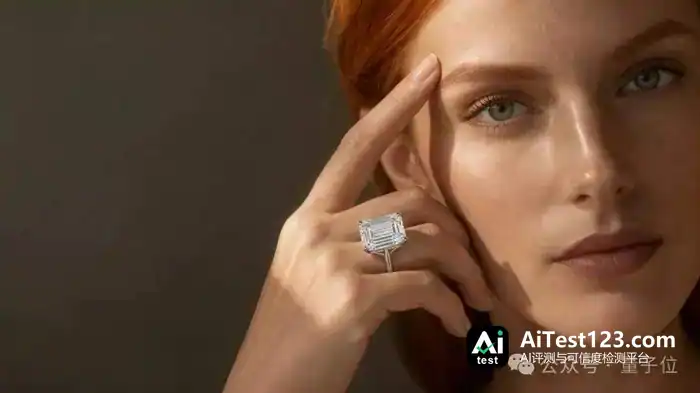
乍一看好像没什么特别?
那把它放大试试呢?
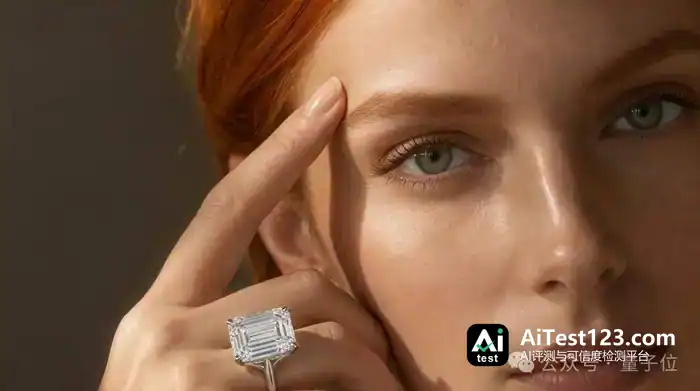
脸上细小的皱纹、手指的纹路、钻戒的质感,还有脸颊上的雀斑,放大之后照样看得一清二楚。
别停,接着往下放大:
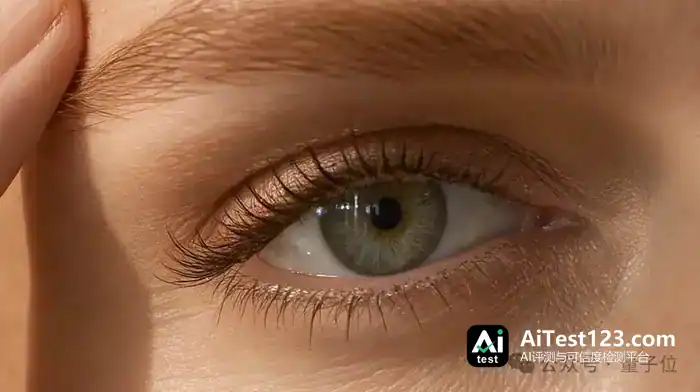
这一回眼周的纹路更明显了,连睫毛和眼妆上那些细小的颗粒都清清楚楚。
为了让大家看到整体放大的过程,我们专门做了一段视频:
视频地址:
https://mp.weixin.qq.com/s/ghQNmpCq9TE9d2E_4sh5uA
可能有人会问,这是不是单反拍出来的广告大片?
还真不是。
这些其实是AI生成的8K高清大图。
下面这张风景照也一样,先看原图:
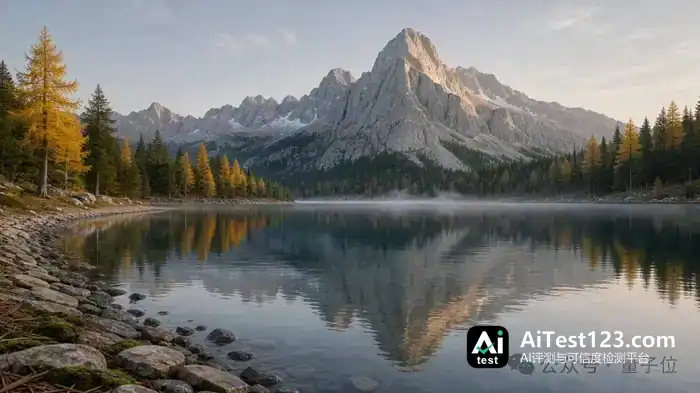
乍看是一张符合物理规律的AI风景图,真正的惊喜藏在放大之后:
视频地址:
https://mp.weixin.qq.com/s/ghQNmpCq9TE9d2E_4sh5uA
不管放大到哪一步,各处的细节都保持清晰、稳定。
那这到底是哪个AI做的?
不绕弯子了,就是可灵新推出的Kling Image 4.0:
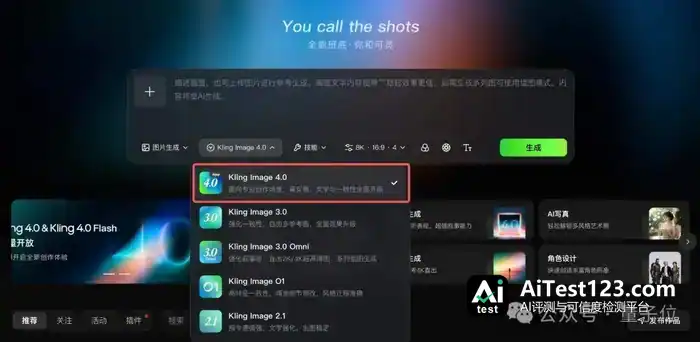
原生8K只是Kling Image 4.0这次升级的一部分,其他亮点还有这些:
- 文字表现力更强:不只是准确,单张图片里现在能生成2000个字,还支持70+款预设字体,各种排版也都能应付。
- 组图和长图能连贯生成:一次描述最多可以出10张系列组图,也能一口气生成超长的商品详情页和网页设计长图。
那接下来按老规矩,来一波实测~
先上点有难度的实测
影视剧照那种质感,先看第一项测试。测AI生图,我们照旧从“像不像”这个最基础的问题入手。
给Kling Image 4.0的Prompt大概是这么写的:古装剧画面,七位古装女子在房间内议事,气氛紧张。
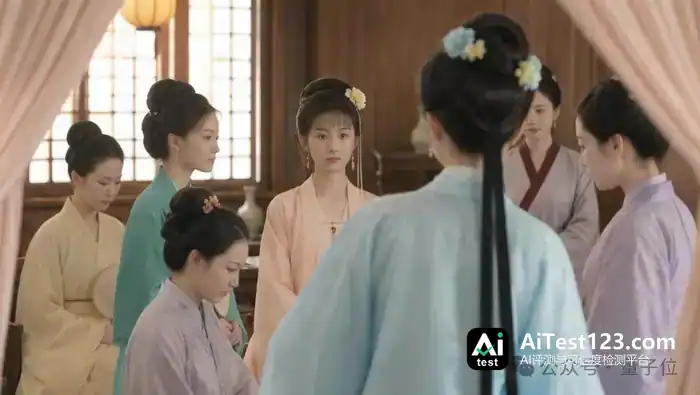
出来的结果里,视觉重心很自然地落到中间那位浅桃色衣服的女子身上,她正对镜头,神情内敛;身边几位有侧身的,也有低头的,人物前后错落有致。乍一看,真像某部电视剧里截下来的一帧。
多人物这一关,Kling Image 4.0不光把人画准了,整体氛围也撑得住影视级的要求。
影视效果看完,下一项测试盯的是字。把整首《沁园春雪》塞进一张图,这事能不能成?
前面提过,Kling Image 4.0支持70多种预设字体,输入框下方的“字体”栏就能挑:
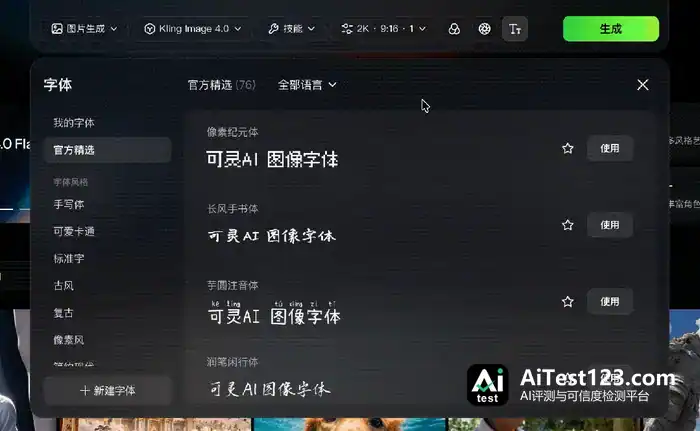
这次挑的是带古风味的劲疏墨韵体,让Kling Image 4.0在单张图里写完《沁园春雪》。Prompt是这么给的:下面是《沁园春雪》的全文,把内容精准无误地写进去,背景宣纸的效果。(此处省略原文)
效果如下:
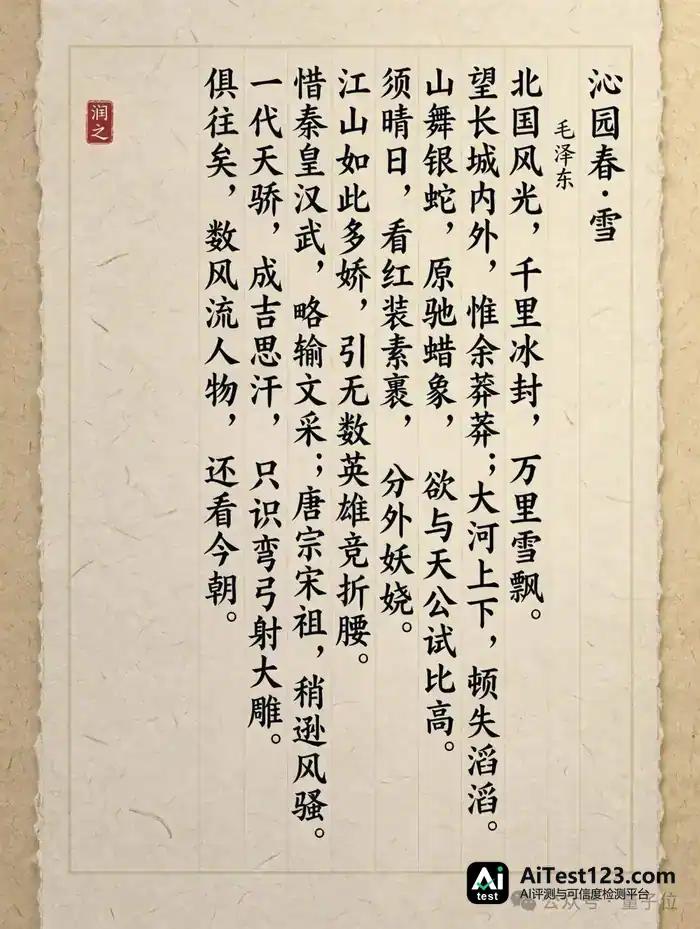
字体上,全篇都用了我们选的那款风格,内容本身也基本没出错。提示词里我们并没交代排版方式,Kling Image 4.0却按《沁园春雪》的体裁,把图排成了诗词竖排、从右往左读。
背景也不只是我们要求的宣纸质感,它还自己添了盖章图案之类的细节。海量文字一次处理完,还能读懂文字背后的意思,这两点Kling Image 4.0都做到了。
再说海报。AI生图行不行,做海报是各家必争的一环。别再一张一张做海报了。
以前做一张《万物有光》当代光影艺术展主视觉海报,效果大概是下面这样?没错,确实也能用。
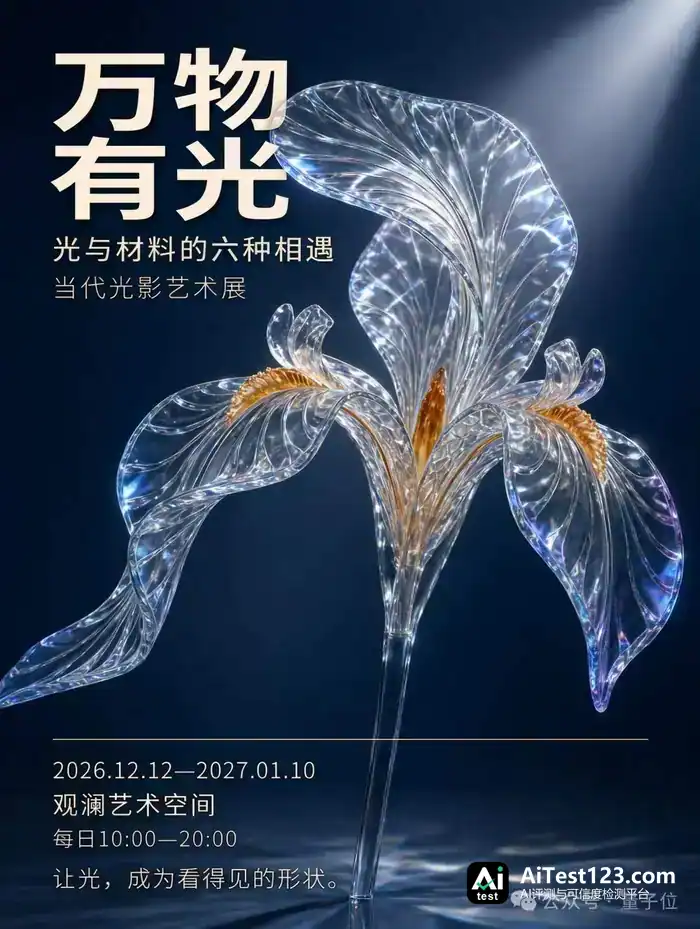
可一张海报能承载的信息终归有限,分批做系列海报,又容易碰上一致性的问题。
现在Kling Image 4.0给了另一个选项:组图模式。顾名思义,给定一个系列的主体,它一口气最多输出10张图。
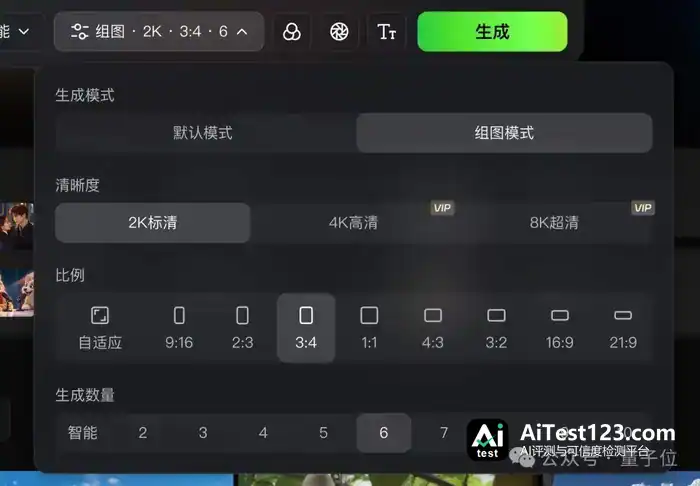
还是《万物有光》这个主题,如今可以这样呈现(左右滑动查看):
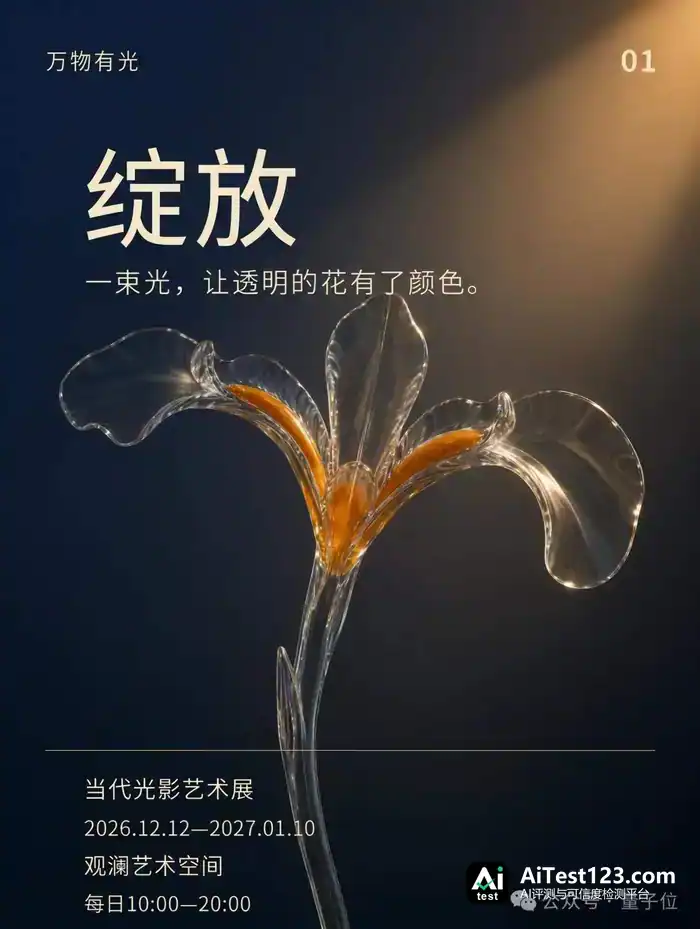
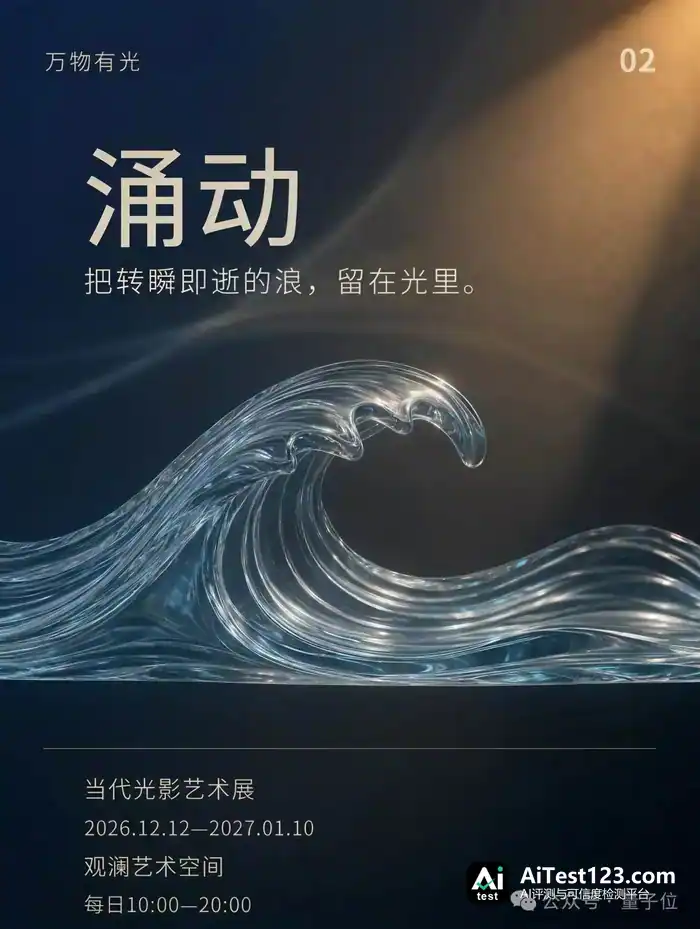
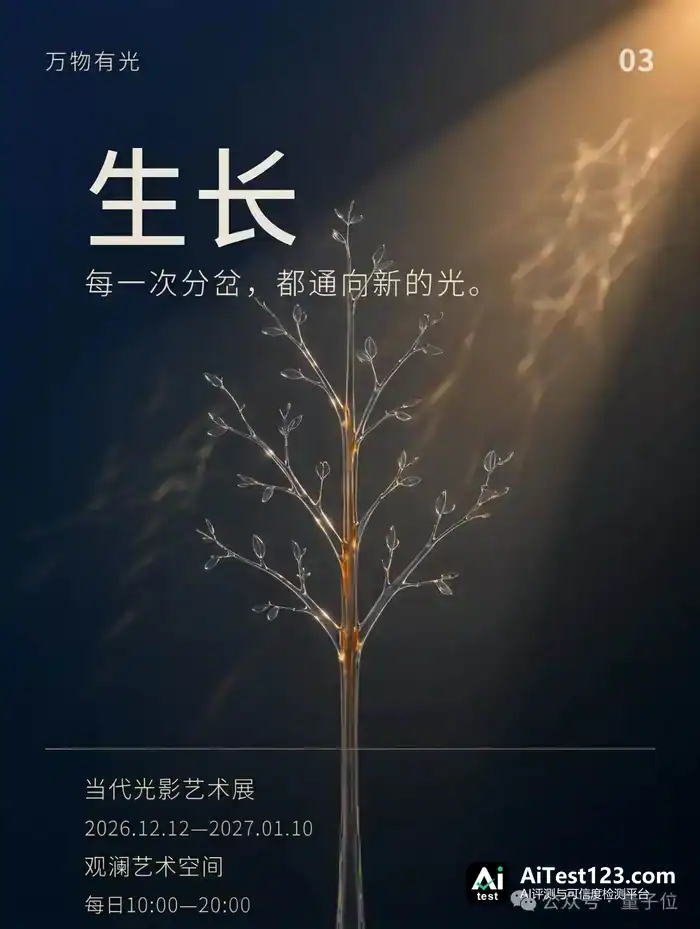
六张海报看下来,视觉色彩一脉相承,排版和页码样式也走了同一套路子。每张图讲的内容并不一样,可一眼就能认出它们属于同一场活动。
常做活动宣传的人应该深有体会:从零搭版式这件事,能省掉不少麻烦。先判断整套设计合不合适,再一页页改内容就行,字体、颜色、布局不用每张都从头琢磨一遍。
不过组图模式给出的终究是六张独立图片。要是想直接来一张超长详情页,那该怎么弄?
“技能”里的电商详情页就能派上用场。
相比组图模式,“电商详情页”用起来更省事:上传一张参考图,再把自己的需求大致写清楚,就够了。
比如传一张咖啡机图片,配上一段Prompt:
等上几分钟,出来的结果是这样(上下滑动查看):
整个过程顺得很,用起来确实省事。
几张参考图也能一起处理
海报做完,接下来要试的是Kling Image 4.0对多张参考图的处理能力。
我们为此准备了六张单独的商品图:帐篷、折叠椅、保温杯、背包、营灯和登山鞋。
接着把它们一块儿上传,让模型把这些装备放进同一个湖边露营场景,各自的主要外观要保留,摆放关系也得安排妥当。
生成结果如下:
六张参考图都稳稳落进了我们设定的新场景,新场景里的光线等细节,模型也一并考虑到了。
品牌想直观判断一整套装备摆出来的效果,这样的功能和效果已经够用。
拿来做分镜同样合适
前面提到的组图模式,还有个挺有意思的玩法——做分镜。
一样地,先给Kling Image 4.0准备一位原创女侦探形象:
人物参考图输入之后,我们给定了这样一条故事路线:
故事从车站起头。女侦探回头看向一侧,接着到了旧书店,把照片递给店主看。下一张图里,镜头推近柜台,带着椭圆形牌子的钥匙出现在她手中。再往后,她走进下雨的巷子,来到旅馆,进入房间翻看照片。之前露过面的那把钥匙,也被搁在了桌面上。
Kling Image 4.0给出的结果如下(左右滑动查看):
六张图连起来看,一条大致的故事线就出来了。照片和钥匙起到线索的作用,人物也因此有了前往下一个地点的理由。
对故事创作来说,这种能力相当实用。创作者可以先用组图把人物行动、场景变化和镜头安排呈现出来,再据此讨论剧情,或者为后续视频制作备好分镜素材。
艺术风格不妨大胆试
最后一项实测,看Kling Image 4.0能不能只凭文字描述,就做出偏艺术表达的人像。
第一张图的结果是这样的:
按我们的提示词,Kling Image 4.0用了高耸的盘发造型,环状发髻配珍珠发饰,人物回头看向镜头。背景保持简洁,视线自然落在头发、面部和铜褐色衣服上。
发丝的走向、衣服表面的褶皱,质感各有不同。整张图颜色比较克制,人物造型反而更突出。
第二张换成了大面积黑色背景:
这张图没有加复杂背景,靠人物姿态、布料走势和局部光线,透出安静的感觉。
两张都是人像,一张重在造型,一张偏重情绪。Kling Image 4.0处理不同艺术风格时,构图、色彩和材质都会跟着作出相应调整。
背后的原理是什么?
实际测下来能发现,Kling Image 4.0要应付的需求,已经牵扯到生图的好几个环节:它得认得出参考图里的商品,也得看明白人物彼此的位置关系;海报上的文字要安排妥当,一组图之间的连贯性同样得顾及。
这些能做到,靠的是Kling Image 4.0这回用的原生理解生成大一统架构。
关键落在“原生”这两个字上。语言模型和扩散模型拼接的老路子不同,Kling Image 4.0把理解与生成放进同一套架构,用单一Transformer当中枢,世界知识、视觉感知和图像潜空间都在同一个上下文里处理,模型对需求的理解因此能直接参与到画面生成中。在此基础上,模型规模和训练数据不断扩展,它把物理规律、逻辑推演带进生成过程的本事也跟着变强。图片里物体怎么摆、光影怎么变、人物动作合不合理,都跟这有关。
就说前面那组露营广告,模型得先认出六件装备各自的特征,再按提示词把它们放进湖边场景。帐篷和前景商品之间要有远近,背包靠上椅子时遮挡得处理干净,夕阳打过来,各件商品的受光与阴影也得彼此协调。
这些条件得放到整个场景里一块儿处理。理解与生成在同一架构下配合,模型才有可能同时顾及商品特征、空间关系和光线条件,多张参考图也更容易自然地落进同一个画面。
碰上要求偏多的任务,比如海报、连续故事,模型还得吃下足够长的指令。
为此,Kling Image 4.0的指令处理能力最高支持15K Token,并用结构化视觉语言来组织画面主体、空间关系、镜头光影和跨画面时序这些信息。
拿前面那组女侦探来说,人物造型要始终一致,她又得先后走进车站、书店、雨巷和旅馆。每个场景的动作和景别都不一样,照片、钥匙这些道具还得前后对得上。
只要漏掉其中一项,故事的连贯性就可能打折扣。结构化视觉语言干的就是这个活:帮模型把这些条件理清楚,谁站在哪儿、镜头怎么走、前后画面之间怎么接。
中文长海报也一样。标题、正文、活动安排和配图各管一摊,模型得照着内容排版面,读者才能顺着图看下去。
另外,Kling Image 4.0还带来了原生Agentic能力,感知、推理、规划、执行都能在同一体系里完成,工具也可以按需调用。
这套能力针对的是更复杂的视觉任务。用户递过来一份夹杂多种要求的需求,模型可以先拆任务、排步骤,再动手做相应的创作。
从统一架构,到长指令处理,再到任务规划,这几项升级都朝着同一个方向去:让模型接得住更完整的创作需求。
做图时,要求再多也不慌
说回使用体验,Kling Image 4.0这次吸引人的地方其实分两层。
一层是图片一打开就能看到的清晰度。人像放大之后,眼周细纹、睫毛、钻戒切面都还留着细节,风景里的山体和倒影也扛得住近看。碰上需要裁切、放大展示的图,后续能操作的空间就更大。
另一层,得真正动手做图时才感受得到。
做一张活动海报,一般不会只丢一句“好看”就完事。活动名称要跳出来,日期地点得写明白,内容一多还得分主次。要是后面再补几张介绍海报,字体、配色、版式也得接得上。
商品广告、故事分镜也是这个道理。用户手里往往已经攥着产品图、角色设定和现成文案,指望AI在这些条件下把活干完。所以模型能吃下多少具体要求,直接决定后面要花多少时间返工。这次实测的结果显示,Kling Image 4.0已经能把一部分复杂需求落成初稿,拿来讨论、调整都行。
放到整个行业里看,图像工具近来的升级方向,也正一点点扎进这些具体环节。
11月4日亮相的OpenAI Images 2.6,把编辑过程中对角色、商品和品牌细节的保留摆到了显眼位置;11月10日,Adobe在MAX上把Creative Agent又推了一步,主攻复杂、多步骤的创作任务。
这些动作透露的信号是:用户交给AI的活儿,重心正慢慢挪向后续修改、素材复用和成套内容制作。
顺着这个方向,Kling Image 4.0的图像本事,也让可灵多了些不依赖视频的用武之地。
不少人最初知道可灵,是因为AI视频。可前面这些实测,已经对上了内容配图、活动宣传、电商设计和艺术创作等需求。就算暂时不碰视频,用户也能拿它把图片这一环做完。
对还要接着做视频的创作者来说,角色图和连贯组图又能变成后续素材。人物长什么样、场景用什么色调、镜头怎么接,都能提前用图片聊清楚,少掉一些只靠文字沟通时的理解偏差。
说到底,大家要的AI生图工具,既得让人眼前一亮,也得听得懂那些细到字体、位置、道具和光线的要求。
前面的实测,让人看到了Kling Image 4.0应对这些要求的实际表现。第三方评测里,它的成绩也不差。
截至发稿,Kling Image 4.0在Artificial Analysis(简称AA)的文生图榜单上排全球第七,在上榜国产模型中居首,位列Nano Banana 2.1之前。
从8K人像到中文排版,再到多图参考和连续分镜,这一轮体验下来,可灵在图片创作上的能力,确实该重新认识一下了。
感兴趣的朋友赶紧去试试吧~
Kling Image 4.0体验地址: https://klingai.com/














