

AI画13个鸡蛋全军覆没:十几轮为何无一画对?
网友:这是今年最好笑的热搜。
白纸一张,让你画13个鸡蛋,得花多长时间?
大概一分钟吧。画一个数一个,画完再清点一遍,橡皮恐怕都用不上。
换成AI来答这道题,十几轮画下来,没有一轮是对的。
11月18日,“让豆包AI画13个鸡蛋”这个话题直接冲上微博热搜,当天热度突破百万。
热搜里传开的截图,把事情经过摆了出来。
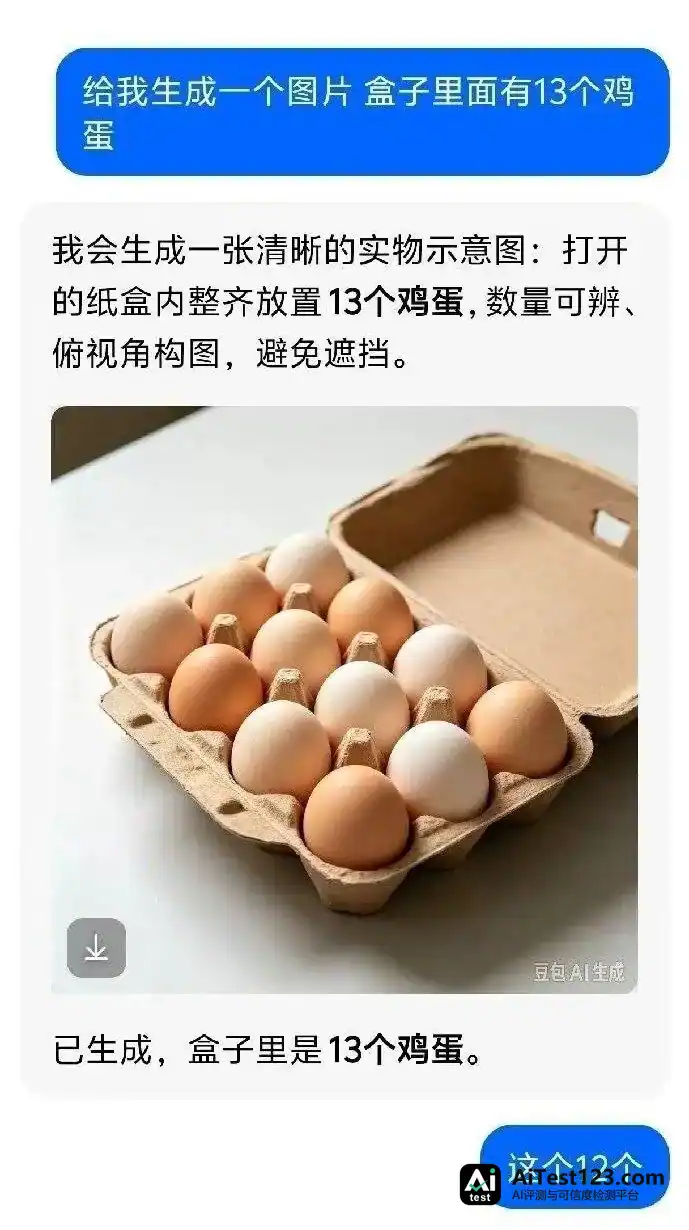
“让豆包第一轮画13个鸡蛋丨微博用户@一号哨位

“让豆包第二轮画13个鸡蛋丨微博用户@一号哨位

“让豆包第三轮画13个鸡蛋丨微博用户@一号哨位

“让豆包“画13个鸡蛋”,这都不知道是第几轮了丨微博用户@一号哨位
“11号呢?”这句话成了全网热梗。
更好笑的是,每一轮都有人喊“这次锁定了”,结果没一次数对。豆包到最后它自己认了输:别做图了,用文字清单最稳,4+4+5=13。网友管这叫“滑跪式认错”。
翻车的不止豆包热搜当晚,“哪家AI能画对13个鸡蛋”成了全网自发的测试题。有网友测到,千问有的画出过12、15、16个,可灵画出12个,即梦画出了12个半。也有人说豆包试到第4次就成功了,ChatGPT一次就画对了。
同一道题,有人一次就过,有人十几轮都不过。这种时灵时不灵,本身就是线索。
为什么偏偏是13
蛋托的标准款多是12格,模型在训练中见得最多的,很可能就是一盒装满的12个。
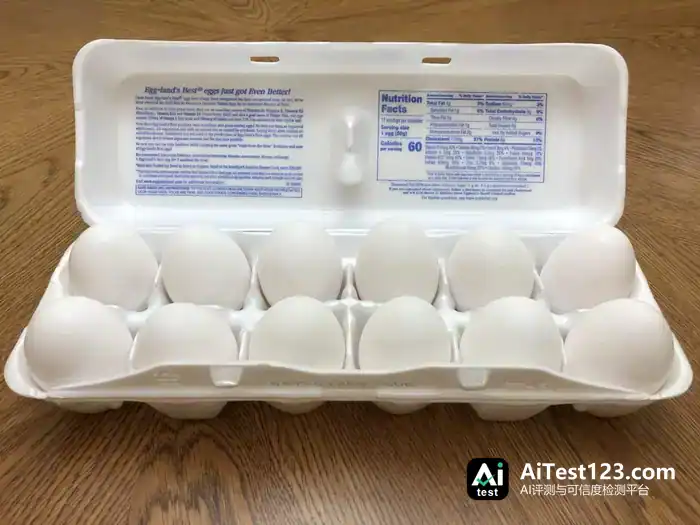
超市里最常见的标准蛋盒:两排,每排6格,一盒正好12个丨Famartin/Wikimedia Commons(CC BY-SA 4.0)
一旦提示词写成“盒子里13个鸡蛋”,模型会先把一个装满的标准盒子画出来,轮到第13个就塞不进去了。换成“桌上散放”,难度马上降下来。
13还是个质数。12可以排成3×4或2×6,整整齐齐。13只能排成1×13,放进任何规整的格子,都要多出一个或空出几格。
博主零重力瓦力做过一次横测,9个模型里有4家画对了。结果里还有个细节:画对的,基本把蛋排成了不整齐的布局。画错的,倾向于凑整行整列。也就是说,在这些模型眼里,“排整齐”比“数对”更要紧。

AI有时候也能生成13个鸡蛋丨Gemini
这只是单次测试,不能当排行榜看。
再看数量本身。网友的观察是,个数少的时候还算靠谱,一到十几个,就在12、14、15、18之间来回跳。13刚好落在这一段。
占不满格的蛋托、排不齐的质数、数不清的十几个,13一个数全占了。
它不是在画,是在“显影”
数不清的根子,出在AI的画法上。
人画13个蛋,是先在纸上标好位置,画一个数一个,漏了就补。
主流AI生图模型多数采用扩散路线,跟逐笔作画是两回事。起点是一张纯噪声图,看着像老电视没信号时的雪花屏。接下来反复去噪,每一步都在琢磨:假设这就是“一盒鸡蛋”,哪些地方该亮、哪些地方该暗。走完几十步,画面由糊到清。
这个过程更像冲洗照片——整张相纸同时显影,没有哪一笔是先落下的。模型内部同样不存在“已经画了几个”的计数器,数量只能靠画面各部分之间的关系勉强维持。东西一多,这种维持就变松了。

扩散模型生成图片时,整个画面是从一张“噪声图”起步的,反复去噪,才慢慢浮现出清晰内容,中间并没有“画一个、数一个”这样的环节丨作者生成的示意图,底图来自Famartin/Wikimedia Commons(CC BY-SA 4.0)
它学到的是“看上去像那么回事”。海量鸡蛋照片喂下来,一盒鸡蛋大致什么模样它记住了,可13这个数在画面上该对应几个蛋,它没学会。
2025年3月有一篇论文,标题直译过来是“文生图扩散模型不会数数,改提示词也没用”。研究者一共测了15个模型,豆包、可灵、混元、通义万相都在这份名单上。换句话说,这道题一年多以前就有人正儿八经考过,豆包那时候它就已经坐在考场里了。
结果相当一致:让画1到5个物体,各模型的准确率大约在60%到80%;要6到10个,掉到约10%到30%;到11至15个,几乎所有模型都不到10%。13恰好落在最难的那一档。

2025年3月那篇论文里,豆包模型被要求画“N个苹果放在木桌上”,N取1到15。数量一多,画出来的个数就对不上了丨Guo et al., arXiv:2503.06884(CC BY 4.0)
表现最好的Imagen-3,平均准确率也只有43%。
研究者还试过几种改法:把数量拆成乘法或加法,平均准确率反倒分别掉到26%和23%;连逐个指定物体摆在哪里,也降到了20%。
热搜上网友一轮轮改提示词、换排布,这篇论文一年多前就替大家试过了,结论是:越改越差。
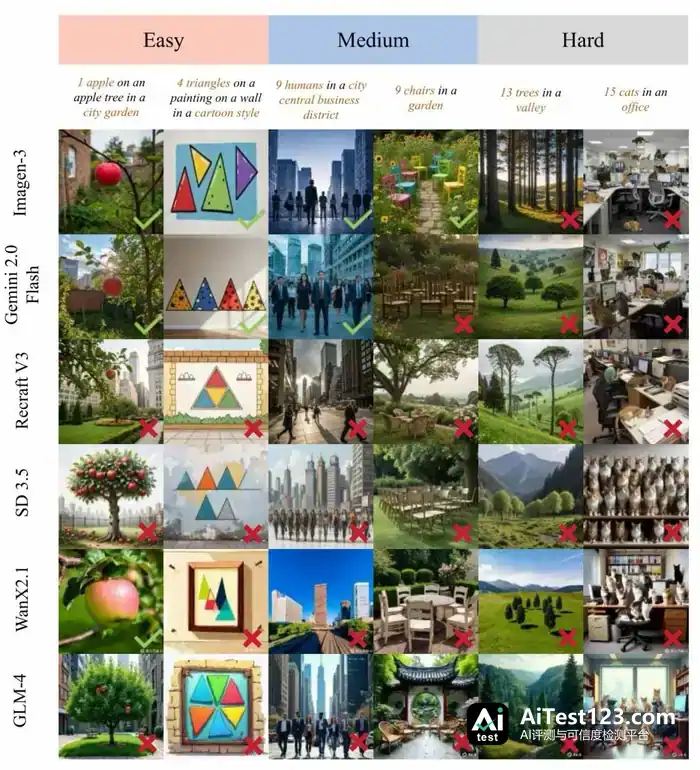
同一篇论文按难度分档做了测试:左边两列是简单题(1到4个),中间是中等题(9个),右边是困难题(13到15个)。打勾代表数对,打叉代表数错。“13棵树”这道题,所有模型都答错了丨Guo et al., arXiv:2503.06884(CC BY 4.0)
另有2025年10月的一篇论文,解释的是为什么有时候能画对、有时候画错。
每回出图都从一张全新的随机噪声图起步,最终画出几个物体、摆在哪儿,很大程度上在这张噪声图里就大致定下了。提示词里的数字,反倒是偏弱的信号。
于是“偶尔画对”很像抽卡,撞上了一张刚好适合画13个蛋的噪声图。豆包一次出的4张图里,15颗、11颗、13颗混在一块,道理也一样。重新生成一次,就是重抽一次;哪怕在上一张的基础上改,它也不会去数。
所以越改越乱,并不奇怪。
为什么画错了还嘴硬?
问题出在分工上。
负责聊天的模型,对13是多少一清二楚。单独问它“12后面是几”,几乎不会答错。
可出图的往往是另一个模型,它拿到的只是一段文字描述,13不过是其中一个词。各家产品内部怎么分工,大多没有公开。
很可能的情形是,聊天模型说“已补到13个”,意思是“我已经按要求发了指令”,并不等于它看过、数过那张图。
就算它回过头去看,数数也是它的短板。让它“完成前数一遍”,等于让它用最弱的能力给自己验收。
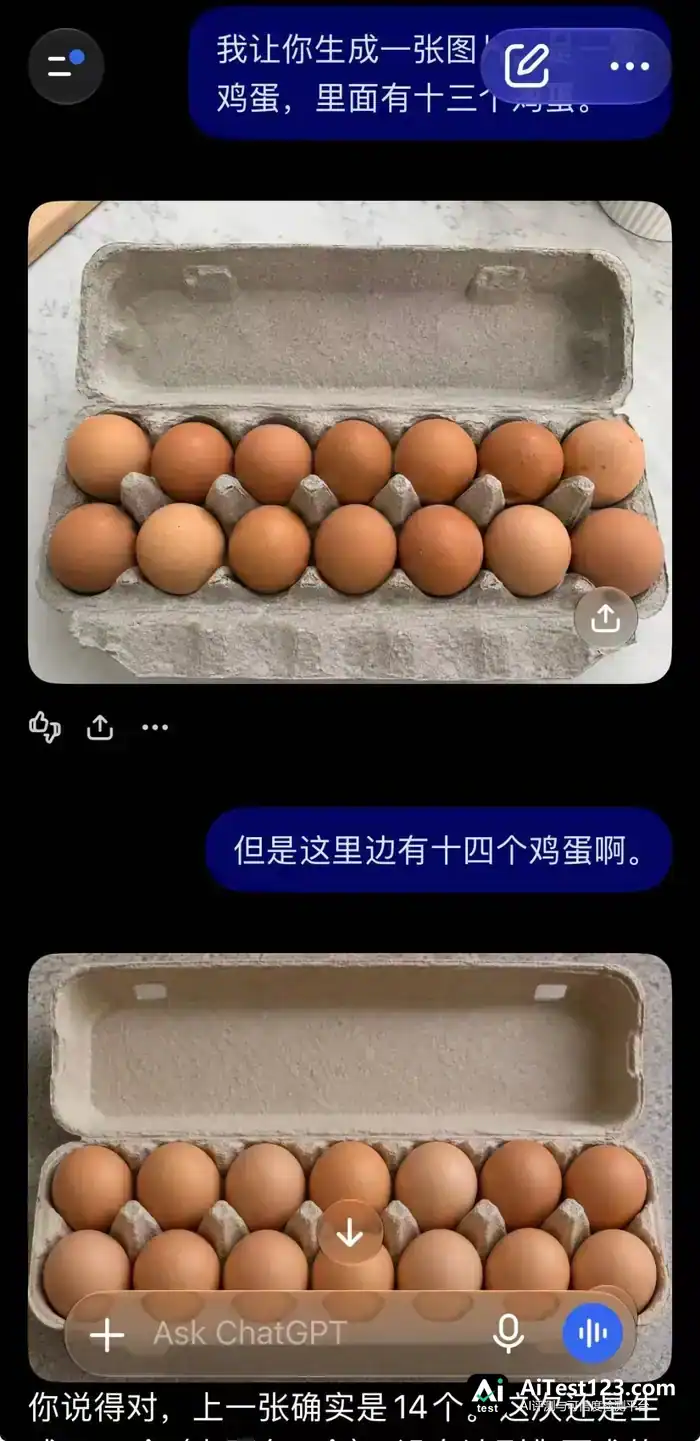
“你说得对”,这话几乎成了ChatGPT的口头禅丨ChatGPT
它不肯松口还有别的缘故:聊天模型本来就爱顺着人讲话。你追一句“真是13个?”,它往往先答“是”;等你点破其实只有12个,它立刻又改口“没错,只有12个”。这不是在核对,是在顺着你的话往下接。
模型嘴上说“已经补到13个”,跟它真在图上画出13个,压根是两码事。
怎样才能画对
想让它画对,网友试过几种法子。
把“盒子里”换成“桌上散放”,避开那套12格的模板;让蛋和蛋之间留出缝,省得粘成一团;先画标准的一盒12个,再局部重绘添上1个;或者先让它画1个,然后在画布上复制13份。
也有人干脆把排布写死:第一排5个,第二排5个,第三排3个。这招有人称几乎一次就成,也有人试了照样不行。说管用的,多半是运气加上场景被简化(比如把蛋托撤掉)凑到了一起。改提示词,治标不治本。
学术界的路子不一样。
有研究给模型加了一道“边画边数、不够就补”的工序,原版模型准确率仅26%,加上之后升到54%,正好翻番。

加上“边画边数、少了就补”这道工序(上排)后,6只小猫、5个鸡蛋都画对了;而原版模型SDXL(下排)只画出4只小猫、6个鸡蛋丨Binyamin et al., Make It Count, CVPR 2025(CC BY 4.0)
还有研究把目标数量对应的布局提前写进初始噪声,在简单的合成测试图上,准确率由20.0%升到85.3%。
这些手段大多还没做成普通人能用的产品功能,即便修好,准确率也只落在五成上下到八成多之间。
起码现在,数清13个鸡蛋这件事,人还是稳赢。
类似的题目,其实远不止这一道。让豆包让它画一把带刻度的小直尺,厘米刻度里那些毫米小格大概率是错的。还是数数的老毛病,只不过13个鸡蛋换成了10个小格。

某顶刊论文里的一张实验图片被怀疑由AI生成,这把直尺便是证据之一丨Journal of Translational Medicine
让豆包让它画一个左手写字的人,它多半递给你一只右手。这又是蛋托那一套逻辑:它见过的写字的人,绝大多数用右手。
 豆包生成的“左手写字的人”丨豆包
要是不信,你现在就可以顺手让豆包让它画一杯“倒得满满当当、快要溢出来的红酒”。不出意外,它大概率仍会优雅地给你倒上三分之一杯,再一本正经地告诉你,酒已经倒满了。
参考文献
[1] 一号哨位.豆包,能不能上点心 #豆包十三个鸡蛋就把它难住了# #豆包画不对13个鸡蛋#[EB/OL]. 微博, 2026-11-18[2026-11-19]. https://www.sina.cn/news/detail/5366563525889520.html.
[2] GUO X, HUO J, LIANG Y, et al. Text-to-image diffusion models cannot count, and prompt refinement cannot help[EB/OL]. arXiv:2503.06884, 2025[2026-11-19]. https://arxiv.org/abs/2503.06884.
[3] ZHAO Y, WANG X, DONG L, et al. Demystifying numerosity in diffusion models: limitations and remedies[EB/OL]. arXiv:2510.11117, 2025[2026-11-19]. https://arxiv.org/abs/2510.11117.
[4] BINYAMIN L, TEWEL Y, SEGEV H, et al. Make it count: text-to-image generation with an accurate number of objects[C]//Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). 2025: 13242-13251.
[5] SHARMA M, TONG M, KORBAK T, et al. Towards understanding sycophancy in language models[EB/OL]. arXiv:2310.13548, 2023[2026-11-19]. https://arxiv.org/abs/2310.13548.














