微软全球宕机超两天:漏洞潜伏数月,80% Outlook服务器一度无响应
全球大宕机内幕曝光,对微软的依赖早该降低了
彭博社等媒体披露,上周微软旗下包括人工智能服务在内的软件出现系统故障,全球用户遭遇服务中断、业务停摆。这个引发故障的漏洞,从7月起就藏在微软数据中心里,一直没被发现。11月11日,微软对用户流量做例行重定向时,系统出了问题。紧接着,支撑Outlook、Teams、Copilot AI助手等多项服务的关键服务器接连失灵,最终演变成全球范围的服务中断。
微软11月15日向客户发布的初步报告显示,首次故障发生后15个小时里,服务器仍有零星故障,公司却几乎没意识到更大的麻烦正在酝酿。大规模故障爆发后,微软又用了15个小时才定位问题、开始推送修复方案。互联网世界对微软软件依赖如此之深,影响自然不小。
职场匿名论坛Blind上,一名自称微软员工的用户发帖说,Microsoft 365核心基础设施团队近些年经历多轮裁员和自愿离职,部分长期维护旧系统的工程师已经走人,剩下的人很难快速定位复杂故障。按这名用户的说法,过去系统回滚大约45分钟就能完成,现在可能要5个小时;这次事故中,内部故障管理工具一度加载不出来,工程师只能深夜跨部门去啃前人留下的代码和服务架构。
故障前后持续超过两天,可能是微软历史上持续时间最长的故障事件之一。到11月16日下午,微软股价下跌约1%。
这次故障的影响形式和范围,再次让外界看到全球经济活动对美国大型科技公司的依赖,也引出了对相关业务替代服务和方案的呼声。
服务器系统漏洞引发故障
彭博社11月17日报道,纽约时间11月11日晚8点刚过,Teams视频会议和聊天服务的流量被自动重定向到另一套独立服务器系统,这套系统同时也在处理Outlook流量。本周早些时候,一个无关问题已经造成服务器容量损失,两者叠加触发了该漏洞,服务器在流量意外激增后内存耗尽。
服务器开始出问题。更麻烦的是,自动化系统会把电子邮件和用户流量重定向到微软认为正常的其他服务器,漏洞于是也蔓延到这些机器上。直到11月12日上午11:30,美国企业流量正处高峰,微软才完全认清问题。
公司又花了15个小时排查,才开始部署修复方案。这期间,电子邮件收件箱打不开、Teams邀请丢失,许多企业和政府客户的工作停摆,员工只能靠电话和纸笔沟通。
面向微软365套件技术人员的一份更新里,有更完整的时间线,显示微软为保障软件运行采取的自动化措施如何引发连锁故障。周四最低谷时,超过80%的Outlook服务器无响应。
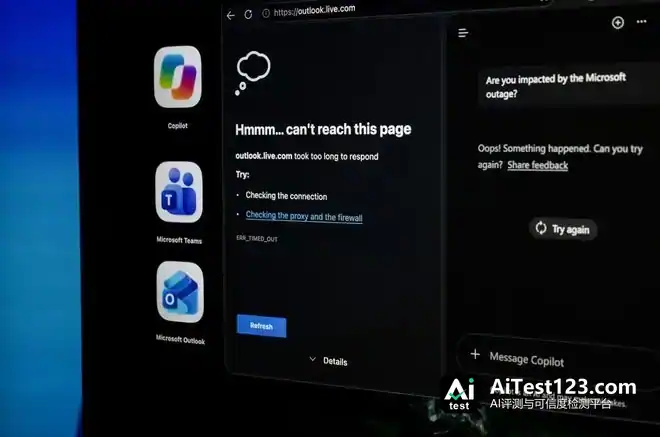
微软Outlook和微软Copilot页面上的错误信息 彭博社
这类故障通常最多持续几个小时。这次却拖得更久:服务器恢复服务后,立刻被大量等待中的流量淹没,再次宕机。加上漏洞已潜伏数月未被发现,靠回滚最近更新来稳定系统的尝试也没起作用。
负责办公软件业务的微软执行副总裁查尔斯·拉曼纳(Charles Lamanna)周一早些时候在微软社交媒体平台X上发文,为这次系统故障致歉,并详细说明了原因。他说,漏洞没被发现,是因为公司实验室模拟的流量模式和硬件配置反映不了服务器后来遇到的真实环境。微软的测试通常针对较旧、性能较弱的系统,用来评估更新是否会影响云服务中最薄弱的环节。而让服务器崩溃的这个漏洞出在新硬件上,处理能力更强,破坏性也更大。
系统性瘫痪
彭博社11月13日报道,微软这次系统故障已造成全球范围内政府机构、贸易商和企业的系统性瘫痪。
瑞士奢侈品集团历峰集团、美国卡车及巴士制造商Workhorse集团等多家依赖微软系统的公司,本周不得不推迟发布财报。
旗下拥有Calvin Klein和Tommy Hilfiger等品牌的服装集团PVH周四宣布,将裁减约4%的全球员工。一位知情人士透露,原定周五上午在亚洲举行的部分沟通因网络故障没能进行,员工对自己在公司的前景感到迷茫。PVH尚未就此置评。
知情人士称,英国国家医疗服务体系(NHS)因网络中断导致通信中断,不得不重新安排部分手术。盖伊和圣托马斯医院已通知患者电子邮件服务中断,但这所伦敦医院的手术仍按计划进行。《卫报》报道说,一些地方警方也表示无法在线接收报案。
11月13日,新加坡的交易员、印度的券商以及东京的官员也报告微软服务出现问题。泛欧交易所警告称,其电子邮件通信服务无法使用。
日本财务省在一份声明中表示,当天大部分时间都收不到电子邮件。由于访问不了邮件,各政府部门只能张贴纸质通知,告知每日日程安排。
澳大利亚储备银行的员工同样受到影响,该行各部门的Outlook系统均出现故障,但关键业务仍正常运转。新西兰移民官员则暂停了所有签证申请的处理。
对微软过度依赖
路透社11月13日报道称,“从某种意义上说,微软是自己成功的受害者”。微软报告称,第二季度其Microsoft 365办公应用套件全球使用率达到99.994%。全球市场对微软业务的依赖、替代服务的缺失,放大了这次系统故障对全球经济及各类机构运行的冲击。
云计算出现之前,企业自己运营服务器;相比之下,微软、谷歌这类云服务供应商通过集中化供应和捆绑销售,把成本和责任分摊给庞大的客户群。这次事故暴露的,正是这种集中化模式的弊端。
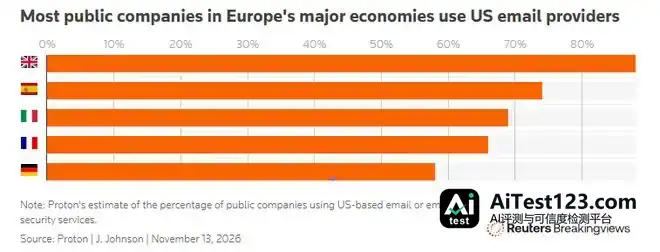
路透社的数据显示,部分欧洲国家的公司正在使用的云计算服务中,美国供应商占了相当比例。
据Downdetector统计,70多个国家的用户报告无法访问微软产品,该网站记录到的投诉达数十万起。网络安全软件、文件共享服务和管理工具同样受到波及。微软把上述产品与Word、Excel等办公必备软件打包出售,统一冠以M365之名。
牛津经济研究院和Splunk的一项研究给出了另一组数字:关键数字业务系统若发生计划外中断,全球2000强企业每分钟平均损失15000美元。
这次微软宕机过后,企业寻找替代方案的压力随之而来。可选的路子有这么几条:美国网络安全公司Mimecast等厂商提供所谓连续性服务,主要电子邮件系统宕机时,用户能借助临时收件箱照常收发邮件;以隐私为重点的科技集团Proton则提供备用电子邮件账户,企业可在危机来临前配置好,等主要系统出故障时再启用。
从历史上看,对连续性服务兴趣最浓的是法律这类有截止期限压力的行业。不过,外部故障可能造成数百万美元损失,这种可能性会把需求推向会计师事务所、医院以及其他受监管企业。
政治因素或许也会拉动需求。特朗普政府执政期间,对关键美国技术存在“致命开关”的担忧,在欧洲已是常见话题。本周Outlook崩溃则说明,技术故障也许更现实,破坏力也不相上下。