Snowflake动态表增量刷新:复用已有聚合结果,性能成本怎么优化

资讯 InfoQ 作者:Lukas Sigmund 王玮 全文 3349 字 · 约 9 分钟读完 配图 3 张 分类存储

对于动态表定义中位于顶层的受支持聚合操作,Snowflake 现在可以利用已经存储的聚合结果进行刷新,无需从头重新计算受影响的数据分组。

所属频道 算力与芯片

2026 年,智能体在企业级应用里会有哪些实质性突破?《2026 年 AI 与数据发展预测》白皮书现已开放下载,专家前瞻一手掌握,提前拥抱新的工作方式。

在 Snowflake 动态表(Dynamic Tables)的客户中,聚合流水线是最常见的模式之一:订单数据按客户汇总、会话数据按账户汇总,或者传感器读数按设备汇总。用户只要在动态表里定义GROUP BY,流水线自己就能让数据保持最新,刷新逻辑一行都不用写。

针对这种模式,Snowflake 已经把运行效率提上去了。动态表定义中处于顶层的受支持聚合操作,现在可以直接拿已经存下来的聚合结果来刷新,受影响的数据分组不必从头重算。

整个过程全自动:不用加新关键字,也不用配任何选项。只要动态表的定义符合相应结构要求,优化就会自己生效。下面说说它到底怎么运作。

增量刷新里有个问题容易被忽略

设想一张动态表,持续汇总每块电表的累计用电量和峰值读数:

CREATE OR ALTER DYNAMIC TABLE dt_meter_consumption  TARGET_LAG = '5 minutes'  WAREHOUSE = pipeline_whAS  SELECT    meter_id,    SUM(kwh) AS kwh_total,    MAX(kwh) AS kwh_peak  FROM meter_readings  GROUP BY meter_id;
复制代码

按说这条查询应该能增量更新,成本也该划算。毕竟meter_readings里变动的数据只占一小部分,计算量理应不大。

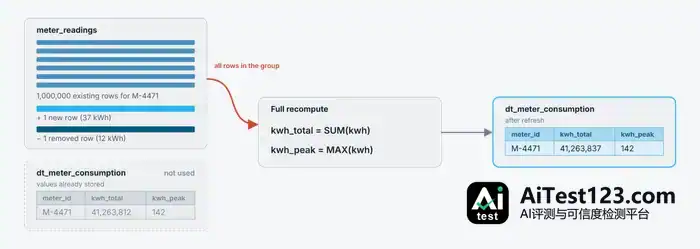
这个判断对了一半。假定新进来 100 条读数,涉及 40 个电表,那受影响的就只有 40 个数据分组,剩下数百万个分组没动,完全可以跳过。把计算范围收窄到受影响的分组,是最容易做的优化,动态表一直具备这个能力。

难的是另一半:知道哪些分组变了,不等于就能直接算出它们更新后的值。聚合值得根据分组内所有行算出来,所以最直接的办法,就是把该分组的所有数据行重新读一遍再算一次。结果就是,某块电表哪怕只多了一条读数,只要它历史上已有 100 万条读数,这 100 万条就得重新读进来参与计算。变动的只有一行,成本却按整个分组来算。

动态表此前的不对称性正在这里:计算量看的是受影响分组的大小,而不是引发变化的数据量。
Snowflake动态表增量刷新:复用已有聚合结果,性能成本怎么优化(配图 1)

用已有结果做增量计算

优化的关键在于,动态表本身就存着上一次刷新的计算结果。如果某块电表此前的累计用电量是已知的,之后又多了一条读数,那算新的累计值时,多年的历史数据根本不用再翻一遍。

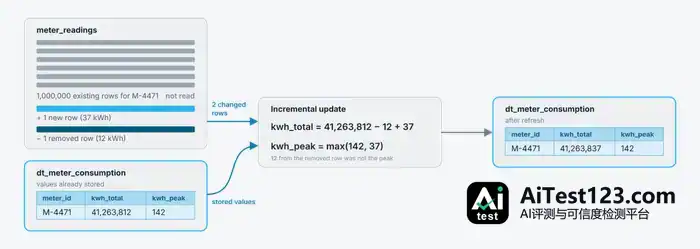
Snowflake 现在走的就是这条路。对符合条件的动态表定义,刷新时会复用动态表里已存储的值,只根据真正发生变化的行来更新聚合结果。计算量于是和变化的数据量成正比,不再由受影响分组的大小决定。

具体怎么实现,要看聚合函数是哪个。SUM是最简单的情形,新值可以直接在旧值上做算术:

newSum = oldSum + insertedSum - deletedSum
复制代码

换成直白的话:新值等于原来存的值,加上新增数据的汇总值,再减掉删除数据的汇总值,源数据行一条都不用读。计数也是同样的路子,Snowflake 基于求和与计数推导出的其他聚合结果同样沾光,平均值、标准差、方差都算在内。

对于 MAX,只要数据变化只涉及新增行,也能用类似办法:新读数要么超过此前存的峰值,要么没超过。所以新值就是max(oldPeak, insertedPeak)。

删除操作就更麻烦一些,因为不是所有聚合函数都可逆。对于SUM,照着公式做减法就行:如果从meter_readings从累计值里删掉一条重复的 12 kWh 读数,总数自然就少 12 kWh。可换成MAX就不一样了:被删掉的如果是当前最大值,原先存下的那个最大值已经作废,新的最大值可能藏在同组其余 100 万条数据里的任何位置,光靠旧值算不出来。Snowflake 能认出这类情况并重算聚合值,不过只对确实需要重算的分组动手,其余分组照样吃到新优化的红利。
Snowflake动态表增量刷新:复用已有聚合结果,性能成本怎么优化(配图 2)

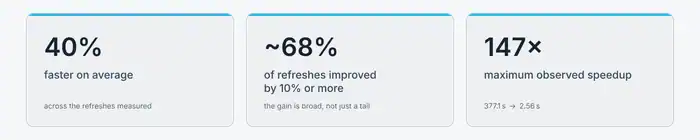
能提速多少,要看聚合函数和数据怎么变,但整体幅度相当可观。Snowflake 的内部测量只统计符合此次优化条件、带顶层GROUP BY操作的动态表,且范围限于此前刷新超过 3 秒的情况。结果是总刷新耗时平均下降约 40%,超过三分之二的刷新任务耗时至少少了 10%。单次最大提升出现在一次原本约需 377 秒的刷新上,优化后约 2.5 秒就跑完了,提升 147 倍。
Snowflake动态表增量刷新:复用已有聚合结果,性能成本怎么优化(配图 3)

聚合之上再叠连接操作时,

这套优化对结构卡得很死:GROUP BY聚合必须是动态表的顶层操作。一旦聚合上面还压着别的操作,比如连接(JOIN)或联合(UNION),优化就开不了。HAVING子句则没问题,它本来就属于分组操作的一部分。

举個例子:一张表记录每个电表的用电读数,再通过关联电表所属站点来补充信息:

CREATE OR ALTER DYNAMIC TABLE dt_site_consumption  TARGET_LAG = '5 minutes'  WAREHOUSE = pipeline_whAS  SELECT    s.site_name,    s.tariff_band,    m.kwh_total,    m.kwh_peak  FROM (    SELECT meter_id, SUM(kwh) AS kwh_total, MAX(kwh) AS kwh_peak    FROM meter_readings    GROUP BY meter_id  ) m  JOIN dim_sites s ON m.meter_id = s.meter_id;
复制代码

这个定义里,聚合藏在子查询内部,上面还套着连接,所以GROUP BY并非顶层操作,定义不满足优化条件。

办法是把两件事拆进两张动态表:第一张只管聚合,第二张拿聚合结果去做连接:

CREATE OR ALTER DYNAMIC TABLE dt_meter_consumption  TARGET_LAG = DOWNSTREAM  WAREHOUSE = pipeline_whAS  SELECT    meter_id,    SUM(kwh) AS kwh_total,    MAX(kwh) AS kwh_peak  FROM meter_readings  GROUP BY meter_id;CREATE OR ALTER DYNAMIC TABLE dt_site_consumption  TARGET_LAG = '5 minutes'  WAREHOUSE = pipeline_whAS  SELECT    s.site_name,    s.tariff_band,    m.kwh_total,    m.kwh_peak  FROM dt_meter_consumption m  JOIN dim_sites s ON m.meter_id = s.meter_id;
复制代码

这样一来,聚合有了自己独立的动态表,GROUP BY只要动态表位于顶层、分组键和两个聚合值又都直接出现在查询的选择列表里,它就满足这次优化的条件。满足条件后,这张表能依据下游使用方的需求,按对应的调度计划刷新;连接操作则被挪到另一张专门做连接的动态表上。TARGET_LAG = DOWNSTREAM

拆分还带来一个额外好处:聚合结果如今可供其他需要它的对象复用。

怎样才能拿到这项优化带来的收益?

对于带顶层聚合操作的动态表,这次优化让它的性能和成本效益都往上走了一步。可以去查动态表刷新优化文档,看看自己用的动态表能不能从中受益。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 奥尔特曼称个人电脑浪费内存引众怒,马斯克发图补刀

    IT之家 11 月 2 日消息,萨姆 · 奥尔特曼近期关于内存的言论引发越来越多人反对,埃隆 · 马斯克也加入了这场声讨。上周,这位 OpenAI 首席执行官的一番话在全网、尤其是玩家群体中引发强烈不满。他称,人们把内存装在个人电脑里,而不是放在数据中心,是一件“很糟糕”的事。在和博主 Cheeky Pint 的访谈中

    来源 腾讯网
  2. Surface Laptop Ultra搭载RTX Spark,Windows端侧算力短板怎么补?

    (本文作者为 硅碳变量,钛媒体经授权发布)文|硅碳变量,作者|胡一刀在AI PC赛道热闹了两年之后,Windows阵营终于拿出了真正对标Mac生态的旗舰筹码。微软联合英伟达推出搭载RTX Spark超级芯片的Surface Laptop Ultra,这不再是微软单独下场做硬件的一次常规迭代,而是Windows生态首次拿

    来源 腾讯网
  3. 拍照好看能打游戏的手机内存大:2亿像素K100+FAQ

    2026年挑一台拍照好看、能打游戏、内存又够大的手机,难处往往不在单项配置,而在三项需求能否落在同一台机器上:影像强的机型未必把散热做足,游戏取向的机型又常在长焦与存储上做减法。 衡量

    来源 快科技
  4. 腾讯混元Hyra 2.0:AI科研转向造工具,三层架构曝光

    腾讯混元11月2日发布AI科研系统Hyra 2.0。与1.0版本直接用AI攻关科学难题不同,2.0重点转向让通用Agent参与科学模型、研究工作流及软件工具的研发与升级,推动科研范式从“刷题解题”走向“造工具”。系统以Overall、Mission、Worker三层架构组织研究工作,并配备项目状态、分层记忆与共享知识库

    来源 凤凰科技
  5. 存储估值仅2-3倍PE,野村称其为科技避风港

    野村认为,存储短缺将延续至2028年,股东回报进入增长周期;但市场仅给予三星、SK海力士2027年2-3倍预期市盈率,隐含盈利见顶预期,估值错位或带来配置机会。

    来源 华尔街见闻
  6. 闪迪:AI推理重塑NAND供需,长期订单排到2030年

    快科技11月1日消息,闪迪在2027财年第一财季财报电话会议上表示,人工智能推理正在改变NAND闪存市场的供需格局。 公司管理层称,客户普遍低估了运行人工智能基础设施所需的NAND容量,目前正在追

    来源 快科技
  7. 想买高颜值、拍照好的手机?双十一看看 nova 16 系列

    今年的手机市场,涨价成了一个绕不开的话题。受存储芯片价格持续上涨影响,手机厂商普遍面临着更大的成本压力。从高端旗舰起售价上调 1000 元,到中端新品相比前代同存储版本普遍上涨 200 至 400 元,手机价格的变化,让不少准备在下半年换机的消费者陷入了观望。在这一轮行业调价潮中,华为 nova 16 系列的表现有些不

    来源 腾讯网
  8. 苹果CEO特努斯首场财报会:存储芯片涨价与AI、Siri成焦点

    中新经纬11月2日电 路透社2日报道,约翰·特努斯将于美国当地时间2日美股收盘后(北京时间3日早5:00)主持就任苹果CEO后的首次财报电话会议,投资者希望通过公司的预测来确定推出的新产品是否‌可以帮助抵消存储芯片成本的上涨。 特努斯于9月从库克手中接过帅印,此后苹果推出了首款折叠屏手机、智能家居中枢设备,以及首款..

    来源 腾讯网
  9. 一个会跳舞的骨架,能瘦身到原来的三分之一吗

    你有没有想过,一段游戏里角色挥刀的动作,存起来到底要花多少存储空间?一个角色身上可能有几十到上百个关节,每一帧都要记录每个关节转了多少角度、挪了多少位置。一部动作捕捉的影视级动画,几十秒钟的数据量就能轻松超过一兆字节。如果是一个拥有几百小时素材的动作数据库,那存储和传输的压力可想而知。游戏行业早就意...

    来源 腾讯网
  10. 奥尔特曼赴韩会见三星约50名高管:存储芯片供应与AI基建合作

    IT之家 10 月 31 日消息,据彭博社报道,全球存储芯片供应短缺问题日益严重之际,今天(31 日)下午,OpenAI CEO 萨姆 · 奥尔特曼在韩国与三星集团高层会面,双方计划进一步加强在存储芯片供应和 AI 基础设施建设方面的合作。 据三星发布的声明,奥尔特曼此次在龙仁市与三星旗下电子、金融和生物科技业务的约

    来源 AI 行业观察
  11. 544亿利润,与20%良率:长鑫的存储超级周期站在一道窄门上

    长鑫科技交出了一份足以让任何一家半导体公司侧目的季报:第三季度归母净利润544亿元,营收1187.1亿元,同比增长613.2%,环比增长19.3%。一家几年前还在亏损边缘挣扎的DRAM厂商,在一个季度里赚到了许多人不敢想象的数字。扭亏为盈本身已经足够有新闻性,但更值得拆解的,是这544亿元究竟从哪里来、又能持续多久。

    来源 AI 行业观察
  12. OPPO/vivo/荣耀/华为11月齐发新机:中端混战价格定胜负?

    9月和10月的旗舰新机大战刚刚结束,没想到11月新机潮又来了。过去的两个月里,小米、OPPO、vivo、华为、苹果、荣耀等厂商陆续拿出了自家的年度旗舰。随着这批旗舰的上市,也意味着接下来登场的就是各家的中端产品线了。根据目前的官方预热和相关爆料,OPPO Reno17、vivo S70、荣耀700、华为nova17等系

    来源 腾讯网
  13. 30+巨头股东曝光!DeepSeek豪华朋友圈曝光:AI竞争焦点变了

    近日,外媒The Information爆出了国内AI圈的重磅猛料:DeepSeek最新一轮融资规模扩大到了1055亿元人民币,估值直接来到了6155亿元。除了打破纪录的融资金额,报道还披露出一份长长的投资方名单,除了宁德时代、中国移动,还集齐了长鑫存储、中芯国际、vivo、美的、立讯精密、吉利、美团、小红书等近30家

    来源 腾讯网
  14. 长鑫科技第六代DRAM平台完成样片验证,首次确认基于4F²架构

    【长鑫科技:基于4F²架构的第六代技术平台DRAM完成工程样片验证】财联社10月31日电,长鑫科技10月30日在第三季度业绩交流会中透露,在4F²垂直沟道DRAM(动态随机存取存储器)架构取得关键突破的基础之上,第六代工艺技术平台已完成工程样片的验证。此前长鑫曾在学术论坛上介绍4F²架构进展,此次是长鑫首次宣布第六代工

    来源 腾讯网
  15. 存储五巨头单季利润首超美国科技五强:AI需求推高芯片景气

    IT之家 10 月 31 日消息,据日经亚洲今天(31 日)凌晨报道,AI 投资热潮推高了存储芯片需求,市场已出现供不应求的局面。受此推动,铠侠、三星、SK 海力士、美光、闪迪五家全球主要存储芯片厂商,上季度的营业利润和净利润总额首次超过美国五大科技公司。 QUICK FactSet 数据显示,2026 年 7 月至

    来源 AI 行业观察
  16. Claude发现Linux内核11年漏洞:53分钟生成Root利用代码

    【TechWeb】安全研究正在进入一个新阶段:AI 不仅能找漏洞,还能写出能用的攻击代码。近日,Anthropic 发布的安全研究披露,其内部一个未发布的 Claude 模型在系统性测试中发现了一个潜伏在 Linux 内核中长达 11 年的高危漏洞,并为它生成了可用的两阶段远程利用程序。 漏洞本体:IPv4 TCP 握

    来源 AI 行业观察
  17. 思科用AI重构98%遗留代码:27岁工程师获无限Token

    一位 27 岁的年轻工程师,被思科总裁兼首席产品官吉图·帕特尔(Jeetu Patel)赋予了近乎“无限”的权限——无上限的 Token 预算,以及一个雄心勃勃的目标:在 24 个月内,利用 AI 重构公司 98% 的遗留代码。

    来源 TechWeb
向下滚动自动加载更多




