高德开源ABot-Recon:万帧流式3D重建,显存只要6.71GB

资讯 TechWeb 作者:Techweb 全文 1187 字 · 约 3 分钟读完 配图 1 张 分类阿里模型发布

阿里巴巴集团旗下高德正式发布首个无长程依赖的万帧级流式3D重建模型ABot-Recon。该模型无需长程记忆,仅凭连续12帧局部画面,即可实时稳定重建上万帧的3D场景,实现“边拍边建”。

所属频道 大厂动态模型发布

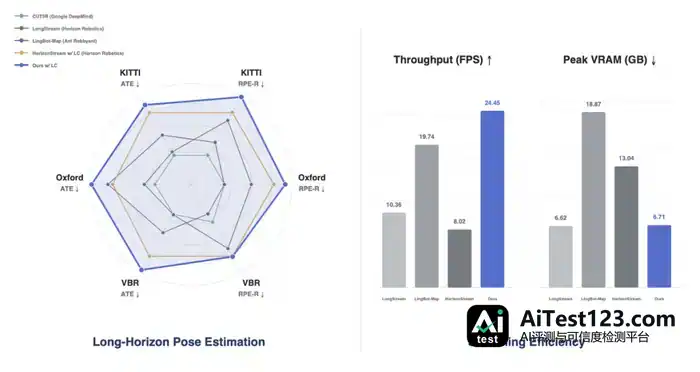
8月28日,阿里巴巴集团旗下高德推出ABot-Recon,这是首个不依赖长程记忆的万帧级流式3D重建模型。它不用长程记忆,只凭连续12帧局部画面,就能边拍边实时、稳定地把上万帧3D场景建出来。在KITTI、Oxford Spires、VBR等权威评测里,ABot-Recon的误差都是最低的,拿到SOTA。
高德开源ABot-Recon:万帧流式3D重建,显存只要6.71GB(配图 1)

自动驾驶、具身智能这些技术往开放环境走,物理AI要的不只是"看见",还得在移动中持续弄明白空间关系:自己在哪、周边有什么、下一步往哪走。商场、园区、仓库这类私域场景定位信号弱、变化又快,系统很难靠一次性建图或事后重建来应付。

现在主流做法是用流式3D重建技术实时建三维场景,可这条路会碰上误差累积、显存过大等麻烦。传统流式3D重建为了保住长距离场景的全局一致,会在重建过程中设记忆锚点,模型得靠长程记忆不停保存、检索、融合历史信息。序列一长,速度就慢下来,精度跟着变差,显存也越吃越多。

ABot-Recon换了一条技术路线:"局部位姿预测+残差优化",专门对付长序列在精度、速度、显存上的压力。它没用长程记忆锚点做记忆对齐,只把最近12帧连续画面当局部上下文窗口,每次仅预测当前相机坐标系下的局部点云以及相邻两帧的相对位姿,计算复杂度因此保持恒定,轨迹也够平滑,再靠在线组合一点点拼出完整的全局轨迹和三维场景。预测目标始终是局部的,跟序列长度无关,内存和单帧计算量就不会随视频变长而膨胀。

局部预测难免积累误差,ABot-Recon在预测端和训练端各设了一套机制,前者纠偏,后者约束误差,实时把轨迹误差校准回来。

精度方面,Oxford Spires长序列基准测试中,ABot-Recon平均轨迹误差比行业代表方法LingBot-Map低40.6%;相对旋转误差RPE-R最低到0.12°,是同类流式方法里最好的,较前代SOTA降了约40%。

速度方面,KITTI-02测试中ABot-Recon跑到24.45FPS,能实时重建,推理速度是行业代表方法的1.24倍。平均轨迹误差低于20米的方法里,它的吞吐最高,显存占用最低。

显存上,ABot-Recon峰值占用只有约6.71GB,差不多是同类模型的三分之一。换句话说,一张消费级显卡GTX 1080Ti就能跑起来,流式3D重建的入门门槛被拉低了不少。

ABot-Recon只要单目RGB视频输入,不需要额外的深度传感器,也不用预先知道相机参数,就能完成万帧级实时三维重建。测绘行业的私域建图、底图更新用得上它,具身智能、自动驾驶、3D内容生产等场景同样可以铺开。

据了解,ABot-Recon的推理及评测代码和权重已经在GitHub开源,魔搭社区也上线了体验专区。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. NVIDIA Cosmos 3新增四款开放模型:96GB显存门槛如何落地?

    2026年11月5日,NVIDIA在HuggingFace发布四个Cosmos 3 Nano开放权重检查点,涵盖自动驾驶多视角仿真与双臂机器人交互模拟。每个模型含160亿参数,采用OpenMDW-1.1许可支持商业使用。这是继5月31日Computex主体发布后的重要扩展,但Nano级别要求96GB显存的硬件门槛,让"

    来源 AI 科技快讯
  2. NVIDIA Cosmos 3上线四款开放模型:96GB显存门槛成落地难题?

    2026年11月5日,NVIDIA在HuggingFace发布四个Cosmos 3 Nano开放权重检查点,涵盖自动驾驶多视角仿真与双臂机器人交互模拟。每个模型含160亿参数,采用OpenMDW-1.1许可支持商业使用。这是继5月31日Computex主体发布后的重要扩展,但Nano级别要求96GB显存的硬件门槛,让"

    来源 AI 行业观察
  3. GPT Images 2.6 发布:生成提速50%,还能用文字生成GIF

    猝不及防。 就在刚刚,OpenAI 正式发布新一代图像生成模型 Images 2.6,并同步向 ChatGPT、Codex 和 API 开放。 此次升级带来了几项重要变化。 一是图像生成速度提升 50%,二是支持通过文字提示词生成 GIF 动图,三是进一步改善多轮编辑的一致性,让 AI 生图开始更接近专业设计素材的生产

    来源 AI 开发者社区
  4. OpenAI 发布 GPT Images 2.6:出图快 50%,支持文字生成 GIF

    猝不及防。 就在刚刚,OpenAI 正式发布新一代图像生成模型 Images 2.6,并同步向 ChatGPT、Codex 和 API 开放。 此次升级带来了几项重要变化。 一是图像生成速度提升 50%,二是支持通过文字提示词生成 GIF 动图,三是进一步改善多轮编辑的一致性,让 AI 生图开始更接近专业设计素材的生产

    来源 AI 行业观察
  5. 百度文心发布ERNIE-5.5-Flash-Base:280B参数,开放预训练权重

    IT之家 11 月 5 日消息,百度文心大模型今日发布 ERNIE-5.5-Flash-Base,开放 ERNIE 5.5 Flash 预训练终点的权重。 这是一个稀疏 MoE 语言模型,总参数 280B,每 token 激活 14B,在 33.5T tokens 上从零完成预训练;最长训练上下文为 128K,微调与推

    来源 AI 行业观察
  6. OpenAI图像模型升级:一句话生成GIF,还提速50%

    OpenAI发布Images 2.6,ChatGPT支持一句话或一张照片生成循环GIF,并可调速度、改单帧,新模型整体提速50%且价格未涨。文章认为,当修图、排版、格式转换等功能被收进模型,靠单点功能收费的AI图像工具公司将受冲击,美图、Canva、Adobe均被提及。

    来源 凤凰科技
  7. 具身智能,变天了

    一家成立一年半左右的具身智能数据服务公司,最近两周接到的数据采购订单超过了此前两个月的量,这在整个具身行业融资环境收紧的背景下就像是一针强心剂。 “订单不仅来自具身行业,一些曾经只询价不下单的基模大厂也开始下单了。”这家公司的创始人告诉「定焦One」。 变化始于GPT-6 Astra的发布,9月初,OpenAI发布最新

    来源 AI 行业观察
  8. Anthropic报告:80%能力增量由AI推动,进化速度翻倍

    编辑|泽南AI 帮助研发下一代 AI 的速度,终于有了具体数字。11 月 5 日,第三方评估机构 METR 发布一份关于 Anthropic 的调查报告表示:这家公司过去一年取得的基准能力进步,大致相当于此前两年的进步。从 8 月 12 日到 10 月 29 日,这个机构花费了约 11 周时间进入 Anthropic

    来源 腾讯网
  9. OpenAI发布GPT-6 Cyber:Firefox挖出81个高危漏洞,评级升至Critical

    人工智能安全领域迎来重磅突破。OpenAI 于2026年11月6日正式发布了迄今为止最强的网络安全专用模型 —— GPT-6Cyber。该模型在软件漏洞的主动发现、自动化验证以及漏洞利用开发等核心能力上实现了质的飞跃,在实战测试中交出了一份震撼业界的亮眼成绩单。 实战表现惊艳:Firefox 挖出81个高危漏洞,Lin

    来源 AI 开发者社区
  10. 蚂蚁百灵发布 Ling-3.2-flash:560B 总参数,前两周限时免费

    IT之家 11 月 6 日消息,蚂蚁百灵官方团队今日宣布推出原生多模态模型 Ling-3.2-flash,拥有 560B 总参数、25B 激活参数,1M 上下文窗口。 该模型原生支持图像、文本与视频输入,重点强化复杂视觉理解、多模态长程 Agent、3D 理解与交互、医疗多模态四大能力,可通过对话页在线体验,并兼容 O

    来源 AI 行业观察
  11. 英伟达破局 AI 内存瓶颈:HBM 仅增约 3%,每美元智能体吞吐量最高提升 30 倍

    IT之家 11 月 6 日消息,英伟达昨日(11 月 5 日)发布技术解读,指出随着大模型参数规模、上下文长度和智能体应用快速增长,GPU 显存正面临前所未有的压力,HBM 供应趋紧、价格上升,在可以预见的未来仍将持续。 为了破解当前 AI 内存瓶颈,英伟达探索引入了“全栈协同设计”理念,将 GPU、CPU、网络、存储

    来源 AI 行业观察
  12. OpenAI新模型或周五亮相:Astra、Sol与Cyber三线齐发

    据《The Information》报道,OpenAI 最快于当地时间 11 月 6 日发布 Astra、Sol 系列及网络安全 Cyber 模型,具体型号、定价和基准成绩尚未公布。此前 Codex 用量统计中已出现“gpt-6.2-astra”标识,灰度用户反馈物理效果和动画生成有所提升。#OpenAI# #GPT6

    来源 IT之家
  13. 雷军晒小米机器人做家务视频,Xiaomi-Robotics-1支撑长程任务

    小米创办人、董事长兼CEO雷军近日在微博发布视频,展示小米机器人在家庭场景中的最新测试进展。该机器人在小米青年公寓试运营,可完成垃圾清扫、物品分类归位等家务任务,视频中清扫瓜子壳、收拾遗落手机充电器等场景引发网友关注。 这套机器人依托Xiaomi-Robotics-1具身基座模型,搭建完整自动执行系统,实测能够连续运行

    来源 AI 开发者社区
  14. OpenAI新模型最快周五发:Astra、Sol与网安Cyber齐亮相

    IT之家 11 月 5 日消息,据《The Information》当地时间 11 月 4 日报道,OpenAI 最快可能于当地时间周五(11 月 6 日)发布新一代 Astra、Sol 系列模型,以及面向网络安全领域的 Cyber 模型。 不过,报道没有披露具体型号编号,也未提供定价、上下文窗口长度或基准测试成绩。目

    来源 AI 行业观察
  15. OpenAI发布网络安全模型:够不够用,谁说了算?

    OpenAI发布新的网络安全模型,正值AI实验室保护数字基础设施的能力受到审视。本文梳理该发布的时间背景、可能能力与局限,并分析AI攻防双用途带来的治理难题。结论是:单一模型难以回答信任问题,透明度、独立评测和跨机构协作才是关键。

    来源 AI 科技快讯
  16. 李飞飞团队发布Frameboy:浏览器里实时体验世界模型

    智东西作者 | 王涵编辑 | 云鹏智东西11月6日报道,刚刚,“AI教母”李飞飞的世界模型团队World Labs发布Frameboy,是一个基于Atlas优化的实时流式生成演示Demo。Frameboy从云端GPU流式传输画面,速度最高可达15FPS,这意味着每隔约67毫秒就能获得一帧新画面。与之对比,谷歌DeepM

    来源 腾讯网
  17. 英伟达发布Realtime-Bench:GPT-6-Astra实时任务成功率仅44%

    人工智能大模型在文本创作、代码编写和图像生成等静态任务上已经展现出惊人的实力,但在瞬息万变的实时交互场景中,它们的真实表现究竟如何?近日,英伟达携手得克萨斯大学奥斯汀分校(UT-Austin)等顶尖机构正式发布了全新的实时交互任务基准——Realtime-Bench。该基准的诞生,旨在为评估人工智能在动态环境下的综合表

    来源 AI 开发者社区
  18. OpenAI发布GPT-6 Cyber:网络安全能力首次评至Critical级

    本文来源:时代周报 北京时间11月6日,OpenAI正式发布网络安全专用模型GPT-6 Cyber。上述模型在漏洞发现与利用开发能力上较GPT-5.6 Cyber显著跃升。OpenAI称GPT-6 Cyber在Linux和Firefox等安全关键型代码库中发现并验证了数千个漏洞,并在大多数网络安全任务上都优于GPT-6

    来源 腾讯网
  19. 基元律动NeoHorse-1.5内测:1250亿参数RSI智能体模型

    智东西作者 | 孙小雯编辑 | 程茜智东西11月5日消息,今日,北京大模型创企基元律动(TokenRhythm)发布面向智能体任务的大模型NeoHorse-1.5-Flash Preview,并开放内测。据基元律动透露,该模型基于Qwen3.8-Flash进行递归自我改进(RSI)迭代,主模型参数为1250亿,激活参数

    来源 腾讯网
向下滚动自动加载更多