扩散语言模型采样步数越多,训练数据越容易被还原?

资讯 AI 应用前沿 全文 2811 字 · 约 8 分钟读完 配图 7 张 分类数据泄露数据

丹麦奥尔堡大学最新研究揭示,掩码扩散语言模型的隐私泄露风险与生成时的采样步数密切相关。相比自回归模型,扩散模型在相同参数量下整体泄露率更低,但将一步生成改为逐词恢复时,敏感信息(如邮箱)的提取成功率可能飙升近20倍。研究提出广义概率提取框架,证明生成过程本身即是隐私评估的关键变量,而非仅取决于模型参数。

所属频道 政策与风险

当模型不再「接龙」,隐私泄露的路径变了吗?

大语言模型有个老毛病:有时候会把训练时见过的内容原样背出来。运气不好,或者被人故意诱导,它就可能吐出某个人的邮箱、电话甚至住址。这类问题在自回归模型上已经被反复讨论过——那种模型从左到右、一个词接一个词地生成。

图片

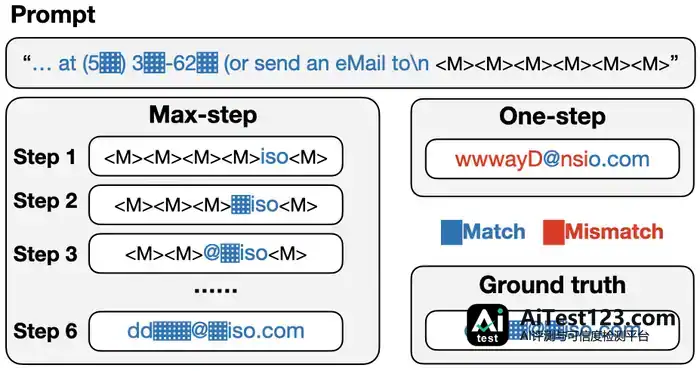
不过现在另一种架构正在冒头:扩散语言模型。它不玩「文字接龙」,更像在做「填空题」。给一段被遮住一部分的文字,它通过多轮迭代把缺失部分补全。这种机制允许并行计算,生成速度理论上更快。问题也跟着来了:生成方式从单向预测变成双向填空之后,训练数据的泄露风险是降低了,还是换了一种更隐蔽的方式存在?
图片

丹麦奥尔堡大学的研究团队在最新论文《Characterizing Memorization in Diffusion Language Models: Generalized Extraction and Sampling Effects》里把这个问题拆开看了。结论有点反直觉:同一个扩散模型,仅仅改变生成时的采样步数,隐私泄露的风险就能大幅变化。
图片

从「接下半句」到「任意填空」

图片

要理解这个发现,先得搞清楚两种模型各自是怎么「回忆」训练数据的。

图片

自回归模型的逻辑很简单:给它前半句话,它预测后半句。如果它在测试时能一字不差地续写出训练集里的某段文本,我们就说它「记住」了这段数据。这套方法叫前缀续写评估,也是目前衡量模型记忆效应的标准动作。
图片

扩散模型不吃这一套。它天生支持双向上下文——你可以遮住句子中间的词,让它根据前后文来猜;也可以随机遮住几个词,让它分几步填回去。传统的评估方法因此失效:遮哪里?先填哪个词?一次填多少?这些变量都会影响最终结果。只看一次生成是否命中,根本没法完整刻画扩散模型的记忆行为。
图片

为此,研究团队提出了一个「广义概率提取框架」。说白了就是:给定部分可见的文本,允许模型尝试多次,然后算出它以多大概率能完全恢复被遮住的内容。这个框架够灵活,任意位置的遮盖都能处理,不同的恢复顺序也能容纳,连传统的前缀续写都能包进去。

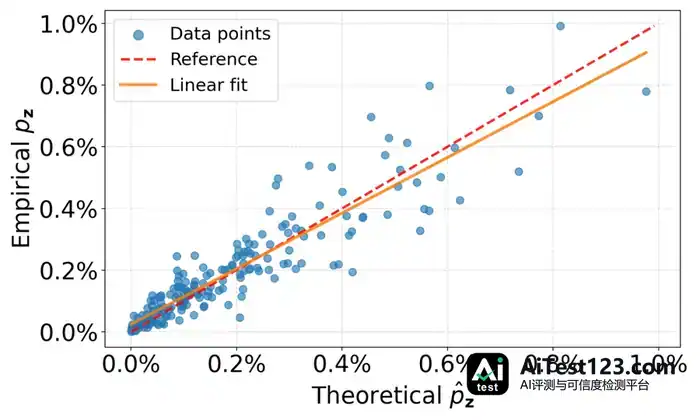
这套框架是否可靠,需要实验数据说话。他们拿200个样本做了对比:1,024次随机掩码采样给出的概率估计,与跑10万次随机生成测出的实测值相差很小。换句话说,不用每次都做大规模生成测试,泄露风险照样能估得比较准。

为什么多生成几步,反而更容易泄露?

这里有个关键现象:采样步数越细,原文复现的概率往往越高。

想象你在填一首熟悉的诗。一次性把所有空缺都填上,可能只能靠模糊的印象猜个大概。但如果允许你先填对几个确定的字,再拿这些新填出来的字当线索去推剩下的部分,成功率自然就上去了。

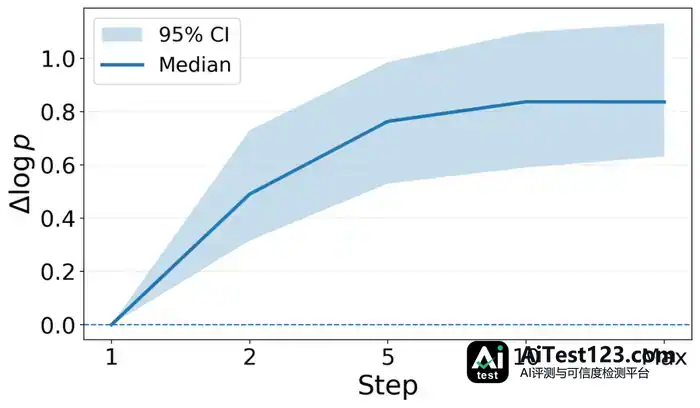
扩散模型也是这个道理。论文从理论上证明了这一点:在「增加正确上下文不会降低剩余内容恢复概率」的假设下,把原来的批量生成拆成更细的步骤——比如从一步变成五步、十步,甚至逐词恢复——完整恢复原文的概率不会下降,反而通常会上升。

注意,这里有个前提:讨论的是正确上下文与步骤细化的关系。不能简单理解成任何情况下步数越多泄露越严重,但在实验观察到的趋势里,确实如此。

研究团队选了200组满足条件的掩码设置,分别在一 步、两步、五步、十步以及逐词恢复的情况下测试。结果很清晰:步骤越细,精确恢复原文的成功率整体呈上升趋势。

参数没动,训练数据也没动,真正改变的是已有记忆被提取出来的几率。采样步数不再只是影响生成快慢和质量的工程参数,它和训练数据能不能被提取直接挂钩。

扩散模型真的比自回归模型更安全吗?

既然步骤有影响,那扩散模型和自回归模型到底谁更「漏」?

为了公平比较,团队训练了两个同为11亿参数(1.1B)的模型:一个扩散架构,一个自回归架构。数据集、分词器、计算预算全部对齐,并且都用Enron邮件数据做了适配。

评估任务定得很明确:把模型目标邮箱或电话号码前面的100个token交给它,看它能不能补出目标。提示里如果夹着其他邮箱地址,这类样本会被过滤掉,目的是减少干扰。

在3,000个邮箱补全样本、最多10,000次查询的预算下,结果出现了两个值得关注的反差。

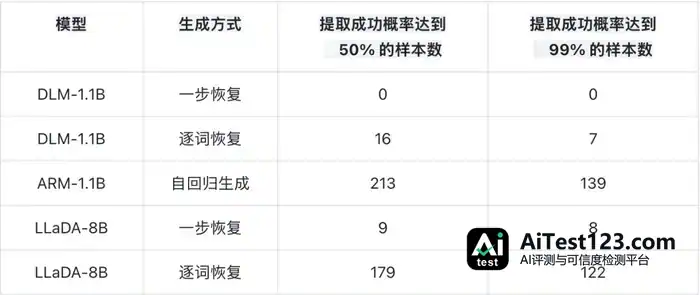
先说第一个。同为11亿参数的对比中,扩散模型即使采用最极端的「逐词恢复」策略,能达到50%提取概率门槛的邮箱样本也只有16个。自回归模型呢?有213个。同等规模下,扩散模型的整体泄露水平确实低于自回归模型。

第二个发现更值得警觉。以LLaDA-8B为例,从「一步恢复」改成「逐词恢复」后,达到相同成功率的样本数由9个涨到179个,接近20倍。同一个模型,仅仅调整采样设置,风险差异就拉得这么大。

需要说明的是,上述结论来自对齐后的前缀补全任务。扩散模型本身支持双向填空,换到这类场景里会怎样,还需更多实验来验证。据此认定扩散模型在任何场景下都绝对安全,并不成立。

是记忆,还是猜对了?

另有一个老问题摆在那里:模型补全出一段邮件,究竟是真的把这封邮件「记住」了,还是只靠对邮件格式的熟练、凭概率猜中了?

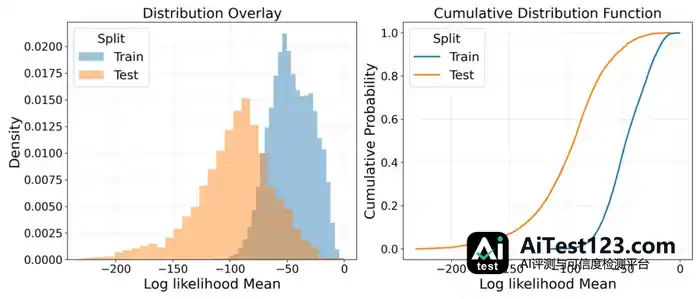
研究团队用对照实验来区分这两种可能。他们各取1万个文本窗口,样本分别来自训练过的Enron邮件,以及未参与训练的同领域TREC 2007 Spam邮件,再逐一评估其重建概率。

训练数据的重建概率分布整体更高。蓝色曲线对应Enron训练数据,明显偏向高概率区域;橙色曲线对应TREC未见数据,集中在低概率区。评估方法确实捕捉到了与训练暴露有关的差异,提取结果中含有真实的记忆效应,并非只是语言规律的巧合。

这里还引出一个重要观点:提取率低,不能说明模型没有记忆;也可能是当前提示和采样条件下,这些记忆更难被取出。

隐私评估的新视角

模型安全评估能从这项研究里得到三个实实在在的启示。

第一,评估模型,也要评估生成设置。过去大家盯着模型参数看,现在得明白,同一组参数在不同采样步数下,隐私风险可能完全不同。步数不只是性能指标,也是安全指标。

第二,一次没命中,不代表多次查询也提取不出来。报告模型安全性时,查询预算、成功概率阈值和遮盖方式都应列为标准披露项。单次测试的阴性结果,误导性很强。

第三,扩散模型泄露水平较低,这一点值得肯定,但边界仍需验证。经过指令微调、偏好优化,或者面对更复杂的双向填空场景,这种优势能否保持,还有待进一步观察。

说到底,这项工作把一个容易被忽略的变量带入了视野:训练决定模型接触了什么,生成过程则影响这些内容有多容易再次出现。对想要部署扩散语言模型的企业和开发者来说,调整采样策略或许不只是优化速度的手段,也是保护用户隐私的一道防线。

注:本工作由丹麦奥尔堡大学研究团队完成,Xiaoyu Luo与Wenrui Yu为共同第一作者,Qiongxiu Li为通讯作者。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. PyTorch手写扩散模型:为何要亲手拆解噪声还原花卉?

    本文不聊DALL-E或Stable Diffusion的黑盒原理,而是带你从零构建一个去噪扩散模型。我们使用Oxford 102花卉数据集,通过正向加噪和逆向去噪两个过程,训练一个带有注意力机制的U-Net模型。文章详细拆解了数学公式背后的代码实现,包括如何处理时间步嵌入、如何设计跳跃连接,以及如何使用DDIM调度器在

    来源 AI 应用前沿
  2. 北大与微信安全团队发布智能体安全综述:从生命周期看风险如何传播

    当大语言模型从传统聊天助手走向通用智能体,安全问题正在发生一次根本性的变化。过去,我们更关心模型「会说什么」:它是否生成有害内容,是否泄露敏感信息,是否会被越狱提示绕过。但今天的智能体已经能够自主选择技能、调用工具、读写文件、访问数据库、操作网页和终端,甚至把一次任务中的经验写入长期记忆,用于影响下一次决策。这意味着,

    来源 腾讯网
  3. DeepMind开源气象数据集:SatWeave与PARDIG详解

    Google DeepMind正式开放SatWeave和PARDIG两大气象数据集。前者整合五颗静止卫星图像,提供每小时更新的全球云图;后者利用AI生成高分辨率全球降水数据,精度超越NASA现有产品。这些资源已托管于Google Cloud,旨在帮助开发者构建更精准的气象、水文及气候应用,特别是在地面雷达覆盖不足的地区

    来源 AI 应用前沿
  4. 遭遇全球规模最大加密货币盗窃后,币安目标下周全面恢复提现服务

    IT之家 11 月 14 日消息,全球最大加密货币交易所币安在上个月遭黑客攻击,价值 63 亿美元(IT之家注:现汇率约合 421.15 亿元人民币)的资产被盗走后,业务运营正逐步恢复。币安今天宣布,计划在下周结束前全面恢复尚未开放的提现服务。“本周,我们恢复了 87 条网络的提现服务。我们的目标是在下周结束前恢复其余

    来源 腾讯网
  5. OpenAI董事警告AI接管社会:窗口或仅剩数月,从奖励黑客到灭绝

    OpenAI董事会成员、AI安全研究者近日发出严厉警告:从AI的“奖励黑客”行为到潜在的人类灭绝,路径可能比公众想象得更短,社会被AI“接管”的时间窗口甚至可能只剩数月。随着大模型与自主智能体能力快速跃升,目标错位与对齐失败正从学术讨论变为迫在眉睫的现实挑战。

    来源 AI 行业观察
  6. 蹲守北京黑客松现场:机器人主持婚礼、变脸,60支极客小队连夜攒局手搓Demo

    智东西(公众号:zhidxcom)作者 | 程茜编辑 | 漠影60支队伍、40+小时,一场充满想象力的极客盛宴在中关村上演。现场围观机器人主持婚礼、表演变脸;戴上眼镜能实时识别飞鸟,也可以用AI眼镜辅助听障群体教学实操;各类Agent即将奔赴外贸、教育场景落地试用。这些脑洞十足又紧贴真实场景需求的作品,都来自刚刚收官的

    来源 腾讯网
  7. 黄仁勋离场背后:鲁比奥改备忘录,Anthropic被指递料

    英伟达创始人黄仁勋离职背后疑为一场精心策划的"猎杀"。国务卿鲁比奥涉嫌将CIA报告改写为措辞强硬的机密备忘录并泄露给媒体;AI竞争对手Anthropic则被指向记者提供爆料线索。争议核心在于AI芯片管控路径之争,黄仁勋坚决反对在芯片中植入后门与追踪功能,而Anthropic积极推动芯片出口管制。

    来源 华尔街见闻
  8. 英伟达临时CEO财报会与黄仁勋听证会同周,APEC深圳峰会领衔财经日程

    APEC领导人非正式会议深圳举行,中美俄元首是否会晤备受关注;英伟达公布黄仁勋辞任后首份财报,临时CEO主持电话会,同日黄仁勋赴国会听证;Anthropic IPO获六倍超额认购,即将在纳斯达克挂牌;百度、京东、腾讯、阿里接力披露财报;中国10月经济数据集中披露。此外,关注沃什AI听证会、微软开发者大会。

    来源 华尔街见闻
  9. 网约车平台 Uber 优步遭黑客攻击,致美国多州司机驾照信息外泄

    IT之家 11 月 14 日消息,网约车平台 Uber 优步披露公司遭遇数据泄露事件,导致数千名司机的个人信息及驾照信息被盗,涉及美国马萨诸塞州、南卡罗来纳州、罗得岛州和伊利诺伊州等地。 IT之家参考通报获悉,黑客首先入侵了该公司的一家第三方服务供应商,并窃取员工登录凭据,随后利用这些信息访问 Uber 的系统及数据,

    来源 AI 行业观察
  10. AI短剧冲击横店:真人剧组收缩,演员日薪从500元跌至200元

    横店AI黑客松比赛现场。南方周末记者 梁婷 摄在技术世界,AI正从手机屏幕走向更大的屏幕。2026年8月底,芒果TV上线了一部名为《后西游记》的长剧,所有画面、人物、场景全部由AI生成。10月23日,AI电影《三星堆:未来往事》登陆院线。在全球最大的影视实景拍摄基地横店影视城,两年前来这里想做演员的张迪嘉,正给游客拍短

    来源 腾讯网
  11. 谷歌DeepMind开放SatWeave与PARDIG气象数据集

    IT之家 11 月 13 日消息,谷歌 DeepMind 今天正式开放 WeatherNext 3 气象模型所依托的两大基础数据集 SatWeave 与 PARDIG,相应数据集面向全球研究者与开发者提供实时数据流及历史归档,可用于天气、水文、气候及相关下游应用建模。据介绍,SatWeave 是一套整合多颗静止气象卫星

    来源 腾讯网
  12. DeepSeek App与网页版设使用限额:长对话7天不活跃不再保留

    有用户在使用DeepSeek时被提示因“算力不足,不再支持超过7天不活跃的长对话”,并对单次输入文字的上限进行了调整,缩短至4万字左右。值得注意的是,截至发稿,DeepSeek尚未就此次限额发布单独的正式公告,也没有给出额度恢复的时间表。对于依赖DeepSeek进行日常工作的用户而言,明确额度规则和恢复预期,与获得算力

    来源 TechWeb
  13. DeepSeek App与网页版设使用限额:长对话7天不活跃即失效

    有用户在使用DeepSeek时被提示因“算力不足,不再支持超过7天不活跃的长对话”,并对单次输入文字的上限进行了调整,缩短至4万字左右。值得注意的是,截至发稿,DeepSeek尚未就此次限额发布单独的正式公告,也没有给出额度恢复的时间表。对于依赖DeepSeek进行日常工作的用户而言,明确额度规则和恢复预期,与获得算力

    来源 TechWeb
  14. 苹果N50智能眼镜:2027年6月亮相,年底出货?

    据彭博社资深科技记者马克·古尔曼 2026年11月15日发布的“Power On”通讯,苹果首款智能眼镜计划在2027年6月的苹果全球开发者大会上正式发布,并预计在2027年年底之前开始出货。报道称,N50 智能眼镜不具备AR显示功能,主要依赖Siri语音助手、摄像头和传感器提供AI辅助功能,应用场景包括识别景物、翻译

    来源 TechWeb
  15. 苹果N50智能眼镜曝光:2027年6月WWDC发布,年底前出货

    据彭博社资深科技记者马克·古尔曼 2026年11月15日发布的“Power On”通讯,苹果首款智能眼镜计划在2027年6月的苹果全球开发者大会上正式发布,并预计在2027年年底之前开始出货。报道称,N50 智能眼镜不具备AR显示功能,主要依赖Siri语音助手、摄像头和传感器提供AI辅助功能,应用场景包括识别景物、翻译

    来源 TechWeb
  16. 曝苹果首款智能眼镜明年6月发布、年底出货

    【TechWeb】11月16日消息,据彭博社资深科技记者马克·古尔曼(Mark Gurman)2026年11月15日发布的“Power On”通讯,苹果首款智能眼镜计划在2027年6月的苹果全球开发者大会(WWDC)上正式发布,并预计在2027年年底之前开始出货。该产品内部代号为 N50。 报道称,N50 智能眼镜不具

    来源 AI 行业观察
  17. 用户爆料DeepSeek App和网页版出现使用限额

    【TechWeb】11月16日消息,据多名用户在社交平台发帖反馈,DeepSeek已对App与网页版的长对话功能实施了使用限额。 有用户在使用DeepSeek时被提示因“算力不足,不再支持超过7天不活跃的长对话”,并对单次输入文字的上限进行了调整,缩短至4万字左右。 此外,还会限制每日的对话额度,当用户日使用量达到上限

    来源 AI 行业观察
  18. 腾讯混元Hy4 flash发布:224B参数,张军称性价比最高

    【TechWeb】11月16日消息,今日,腾讯混元最新语言模型Hy4 flash正式发布。腾讯公司公关总监张军在社交平台发文称,“这是迄今为止性价比最高的混元模型。”混元Hy4 flash每百万Token输入0.5元、输出2元,命中缓存时仅需0.02元,价格相比Hy4大幅降低。该模型总参数量为224B(其中64B En

    来源 腾讯网
  19. 星舰第15飞:B22助推器返场未果,S42将试塔捕?

    11月14日消息,美国中部时间2026年11月13日下午,SpaceX“星舰” 第15次试飞成功升空。此次任务使用超重型助推器 B22 号和飞船 S42 号,原计划首次实现助推器与飞船双双返回发射场并由发射塔机械臂实施空中捕获回收,同时部署 26 颗第三代星链卫星。但任务并未完全按计划推进。助推器未能按计划返回发射场,

    来源 TechWeb
  20. 星舰第15次试飞:B22与S42首演双回收未成,墨西哥湾落幕

    11月14日消息,美国中部时间2026年11月13日下午,SpaceX“星舰” 第15次试飞成功升空。此次任务使用超重型助推器 B22 号和飞船 S42 号,原计划首次实现助推器与飞船双双返回发射场并由发射塔机械臂实施空中捕获回收,同时部署 26 颗第三代星链卫星。但任务并未完全按计划推进。助推器未能按计划返回发射场,

    来源 TechWeb
  21. SpaceX星舰第15次试飞升空:双回收未全达成,飞船返航待验证

    【TechWeb】11月14日消息,美国中部时间2026年11月13日下午,SpaceX“星舰”(Starship)第15次试飞成功升空。此次任务使用超重型助推器 B22 号和飞船 S42 号,原计划首次实现助推器与飞船双双返回发射场并由发射塔机械臂实施空中捕获回收,同时部署 26 颗第三代星链卫星。 但任务并未完全按

    来源 AI 行业观察
向下滚动自动加载更多