

不刷题也能拿高分:星衍智能 Auriga 框架的零样本具身实践
在机器人仿真评测中,大多数方案依赖反复重置环境来“刷”出最优解。星衍智能推出的 Auriga 框架反其道而行,在禁止预调优、禁止重置的严苛条件下,凭借一套通用的物理执行系统(Harness),在 RoboDojo 和 RoboCasa365 榜单上取得领先。文章解析了 Auriga 如何通过“感知即测量”、“所见即所执
当机器人失去“无限读档”特权
玩电子游戏时,我们习惯了一个特权:打不过就重来。存档、读档,直到找到完美通关路径。在机器人仿真训练里,这种“无限读档”对应着 env.reset——环境重置。算法可以成千上万次地重置场景,试错、调整参数,最终背下针对特定任务的“标准答案”。
但如果把这个特权收回呢?
如果不允许提前刷题,不允许中途重置,只给一次执行机会,机器人还能完成任务吗?最近,星衍智能发布的通用具身 Harness 框架 Auriga 就在这样的限制条件下交出了一份答卷。在 RoboDojo 和 RoboCasa365 两大权威基准测试中,Auriga 在 Zero-shot(零样本)评测协议下取得了领先成绩。
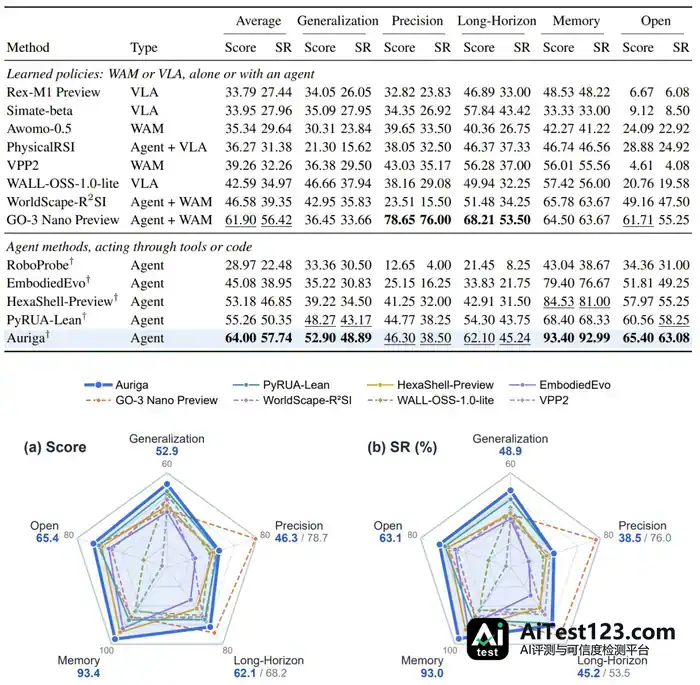
这里的 Zero-shot 定义非常严苛:不针对目标任务进行预调优,不使用专家演示数据,且每个案例仅允许单次执行,中途失败不得重置环境。在这种“一镜到底”的压力测试下,Auriga 的平均任务成功率达到 57.74%,过程评分 64.00,均位列榜首。
这引出了一个值得思考的问题:机器人的智能,究竟是在背诵无数道题的答案,还是在进化一套解题的系统?
具身智能进化的三个层次
要理解 Auriga 的设计思路,先得看清当前具身智能(Embodied AI)发展的不同阶段。星衍智能将物理世界的递归自我改进(Physical RSI)划分为三个层次,这不仅仅是技术路线的区别,更是对“智能”定义的不同理解。
L1:进化答案(任务级搜索)
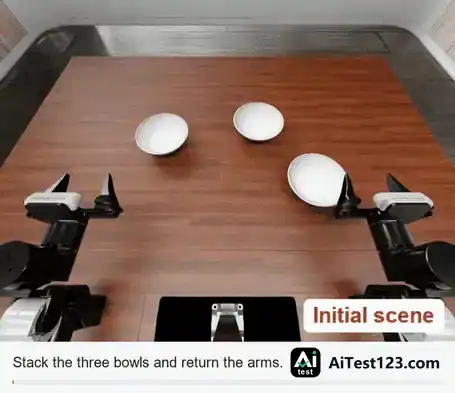
这是目前大多数仿真训练采用的模式。系统通过反复重置环境,修改动作脚本或控制参数,为某一个特定任务寻找最优解。比如,为了让机械臂抓起一个杯子,算法可能尝试上万次不同的抓取角度,直到成功率高企。这种方法在特定任务上表现极佳,但一旦换个杯子位置,或者换一种物体,之前的努力往往归零,需要重新优化。
L2:进化过程(单次在线适应)
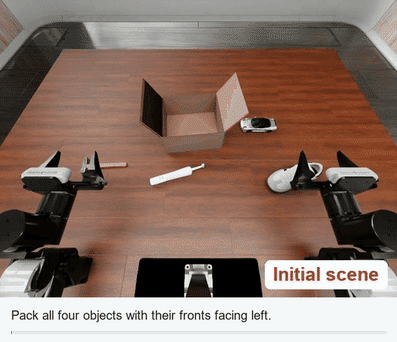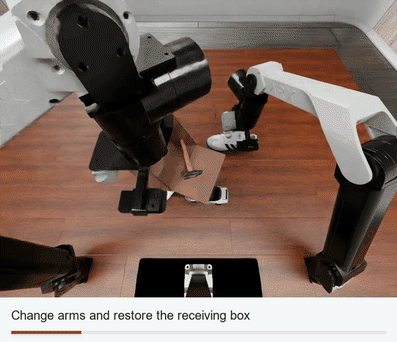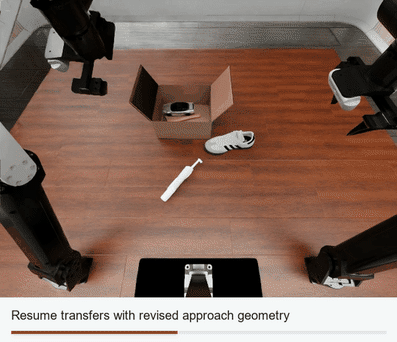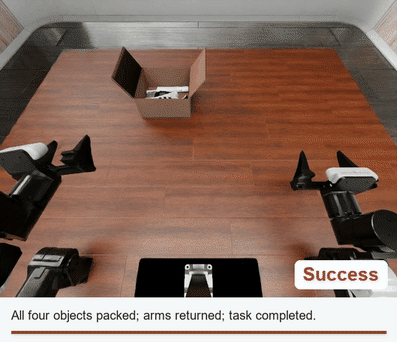
这一层级的系统不再依赖环境重置,而是在一次连续的执行过程中,根据实时观测反馈调整动作。如果手滑了,它能立刻修正。这种改进发生在当前任务的执行流中,具备一定的鲁棒性。但这些调整通常是临时的,不会沉淀为可供其他任务复用的通用能力。
L3:进化系统(系统级能力改进)
这是 Auriga 瞄准的目标。系统从不同任务的交互中识别共性问题,改进底层的通用工具、控制原语或技能机制。关键在于,这些改进会被保留在系统中。当下一个新任务出现时,机器人不需要从零开始,而是调用已经升级过的底层能力。这就好比人类学习骑自行车,一旦掌握平衡感,这种能力可以迁移到骑摩托车甚至滑板上,而不是每次骑车都重新学习如何不倒。
从 L1 到 L3,核心变化在于能力改进的范围:从解决一道题,到优化一次执行,再到升级整套解题系统。
Auriga:为大模型装上“物理手脚”
大语言模型(LLM)擅长推理和规划,但它们生活在文本和符号的世界里,缺乏对物理世界的直接触感。Auriga 的角色,就是在大模型与物理世界之间构建一个通用的 Harness( harness 原意为马具,此处指约束与连接装置)。
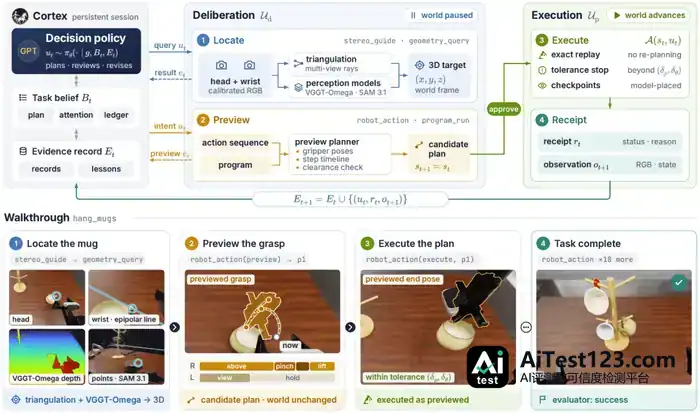
这个 Harness 不是简单的指令翻译器,而是一个整合了感知、执行验证与状态管理的交互系统。它让大模型在陌生任务中不仅能决定“做什么”,还能确认“能不能做”、“有没有做到”,并在出错时知道“接下来怎么办”。
Auriga 的架构围绕三个核心理念展开:
1. 感知即测量:给模型一双带刻度的眼睛
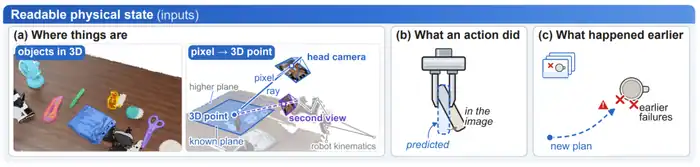
大模型看图,通常只能识别出“这里有个杯子”。但对于机器人操作来说,这远远不够。它需要知道杯子的精确三维坐标、朝向、尺寸,以及夹爪应该以什么角度接触。
Auriga 融合了 VGGT-Omega、SAM 3.1 等视觉模型,结合相机标定和多视角几何技术,将二维图像转化为具有真实物理尺度的空间信息。模型可以主动查询目标物体的位姿,系统会通过双视角三角测量和三维重投影来验证关键接触点。
更细致的是,对于已经抓取的物体,系统还能结合腕部相机和夹爪状态,实时监测物体在手中的微小滑移。这种“带刻度”的感知能力,让大模型的推理建立在坚实的物理事实之上,而非模糊的视觉猜测。
2. 所见即所执:先预演,再动手
在物理世界中,动作一旦发出就无法撤回。为了避免“盲目执行”,Auriga 引入了 Preview–Execute–Verify 流程。
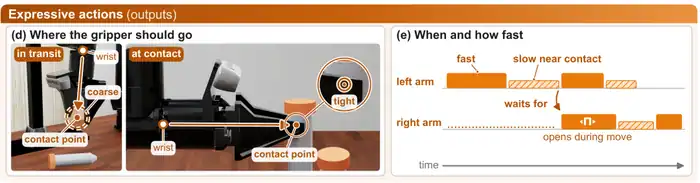
当大模型生成动作指令后,Harness 并不会立即驱动电机,而是先在虚拟空间中编译出一段可视化轨迹。这段预演展示了双臂的运动路径、关键姿态、预计耗时以及潜在的碰撞风险。模型可以在实际执行前检查这段轨迹,如果发现可能撞到桌子或者角度别扭,可以即时调整计划。
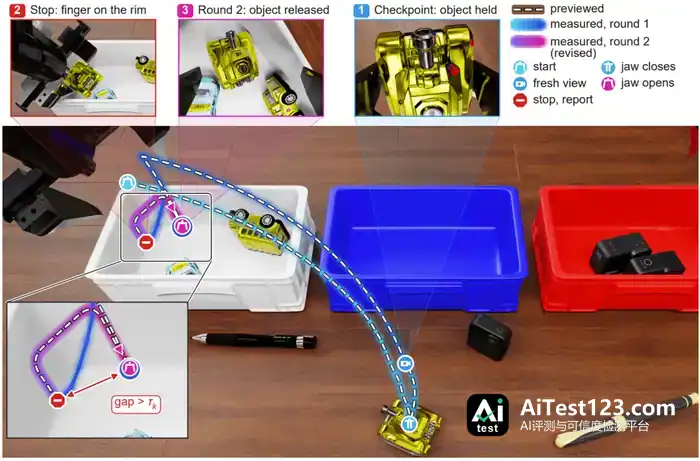
在执行过程中,系统会持续对比机器人的实测状态与预演轨迹。一旦偏差超出设定容限(比如机械臂被意外阻挡),系统会自动截停后续动作,并将偏差位置、最新观测数据返回给模型。这种机制确保了“所见”与“所执”的一致性,大幅降低了物理执行中的不可控风险。
3. 失败即证据:让错误有价值
在长程任务中,失败是常态。传统的做法往往是重置环境,从头再来。但 Auriga 选择记录失败。
系统建立了显式的任务状态管理和可检索的执行历史。模型的动作意图、规划轨迹、实际运动数据、视觉观测以及最终结果,都被结构化地保存下来。即使长程任务导致模型上下文窗口压缩,关键的任务状态依然保留。
当执行出现异常时,模型可以回溯此前的动作序列,分析预期与实际执行的偏差。更重要的是,这些结构化的失败记录成为了跨任务分析的素材。系统可以识别出不同任务中反复出现的物理执行难题(例如某种特定形状的物体容易滑脱),从而为后续通用工具和控制机制的改进提供证据。
严苛评测下的表现
为了验证这套框架的有效性,星衍智能基于 GPT-6 Astra 基础模型,在 RoboDojo 和 RoboCasa365 两个基准上进行了系统评测。
RoboDojo:零样本下的综合竞争力
RoboDojo 榜单涵盖泛化、精细操作、长程任务、记忆与开放任务五大维度,共 42 项任务。Auriga 在 3 个随机种子、共计 6300 个测试 Episodes 中,取得了 57.74% 的平均成功率和 64.00 的平均过程评分。
值得注意的是其在“记忆”任务上的表现,成功率高达 92.99%。这表明 Auriga 的状态管理机制能够有效维持长程任务中的上下文一致性。在泛化测试中,面对物体布局的随机化,Auriga 的综合指标 G 得分 46.3,领先第二名 2.4 分。这说明其感知与执行模块并非针对特定场景过拟合,而是具备真正的空间泛化能力。
RoboCasa365:跨形态与跨场景迁移
如果说 RoboDojo 考验的是同一台机器人在不同任务上的表现,那么 RoboCasa365 则考验了系统的迁移能力。
测试环境从双臂桌面操作平台切换到了搭载 Franka 单臂的移动机器人,场景也从固定桌面转移到了 10 个从未见过的厨房。任务包括开关柜门、操作抽屉、旋转旋钮等,部分长程组合任务包含多达 15 个子步骤。
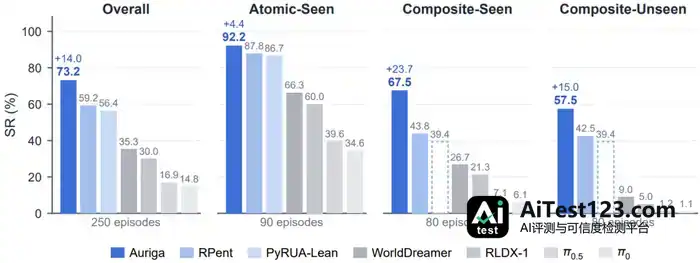
在这种本体结构和场景双重变化的情况下,Auriga 在 Target50 的全部 50 项任务中取得了 73.2% 的总体成功率。其中单技能任务成功率 92.2%,长程组合任务 62.5%。这一结果证明,Auriga 的 Harness 框架确实具备一定的跨机器人形态复用潜力。
一镜到底:失败后的自我救赎
在禁止重置的规则下,机器人必须具备在线恢复能力。Auriga 的执行日志展示了几种典型的自救行为。
局部纠错:
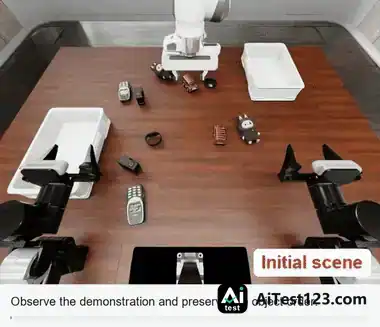
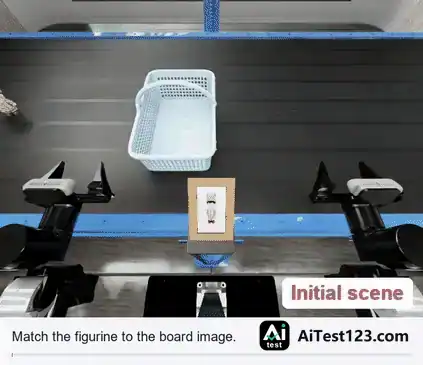
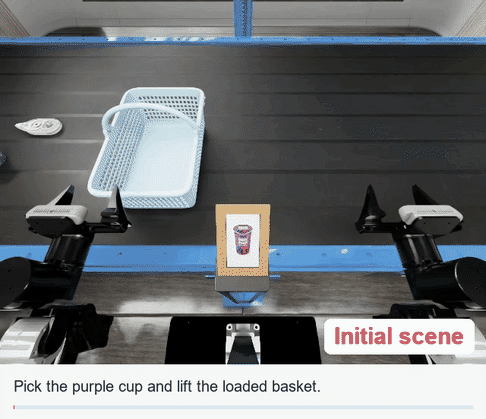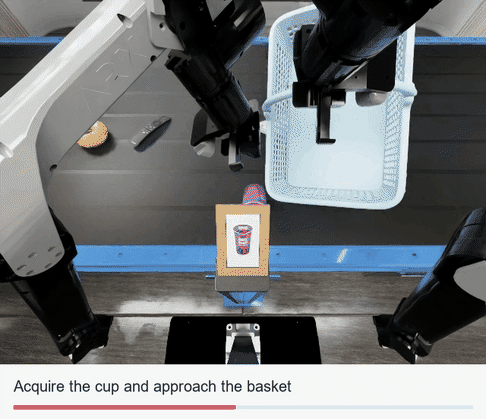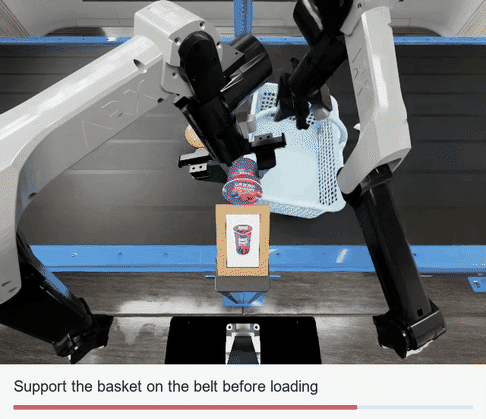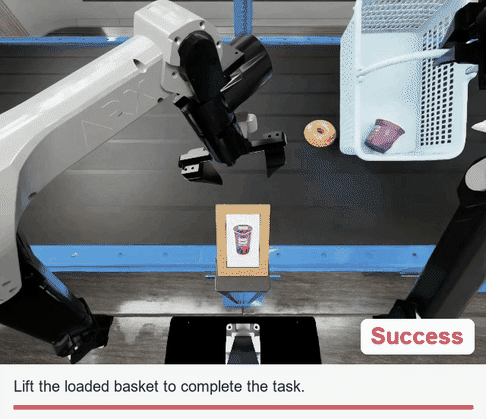
在玩具抓取任务中,如果物体从夹爪滑落,GPT-6 会利用 Harness 提供的最新观测,重新定位目标,调整抓取位置和力度,然后继续尝试。在传送带分拣任务中,面对物体位置的动态变化,模型能实时调整搬运策略。
策略重规划:
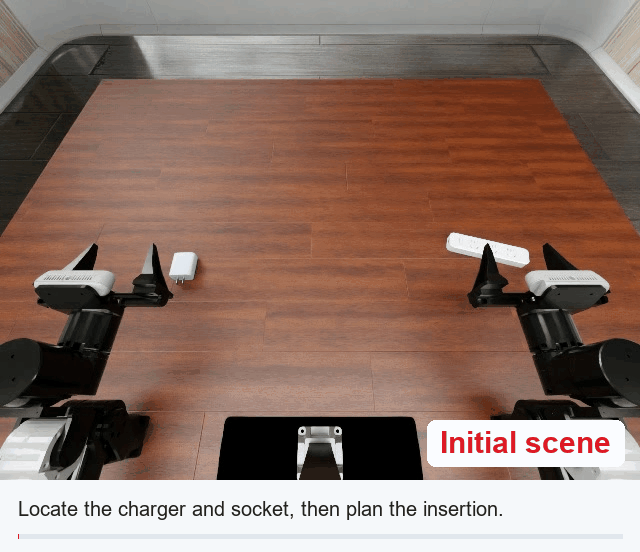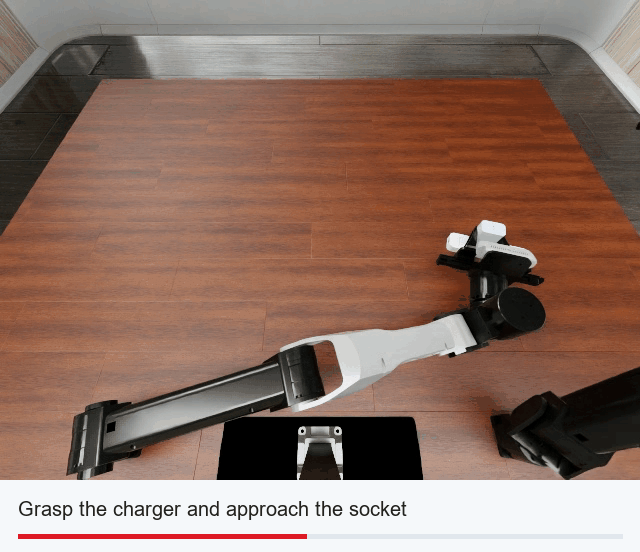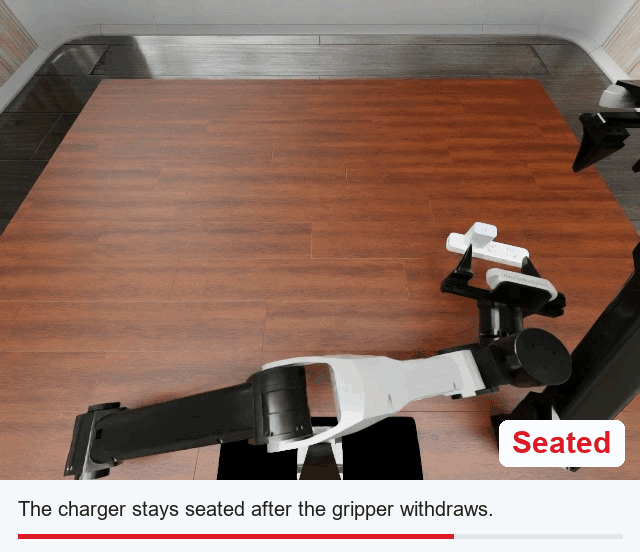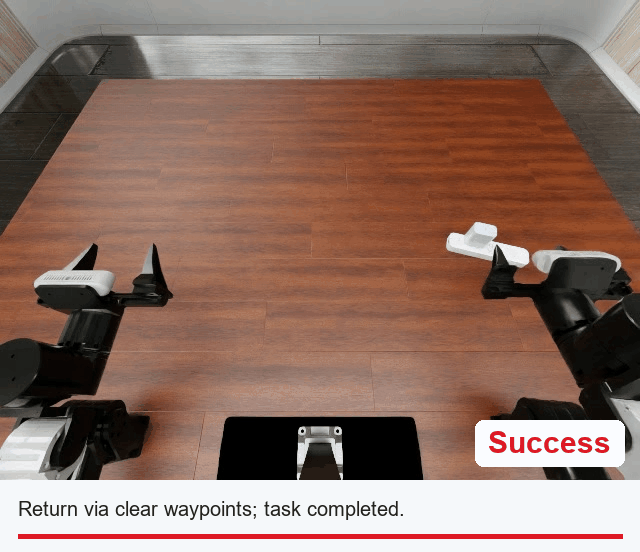
更复杂的情况涉及整体策略的改变。在物体装箱任务中,模型发现箱体因碰撞发生位移,原有的放置路径已不可行,于是主动调整机械臂分工,重新规划放置顺序。在充电器插入任务中,面对毫米级的位置偏差,模型没有强行插入,而是根据反馈进行微调和重新对位。
这些案例表明,Auriga 让模型具备了在物理世界不确定性中持续推进任务的能力。它不再是执行一段写死的代码,而是在一个动态反馈闭环中不断做出决策。
从 Failure as Evidence 到 Failure as Improvement
Auriga 目前的成果主要验证了通用大模型通过共享 Harness 完成陌生物理任务的可行性。但星衍智能的野心不止于此。
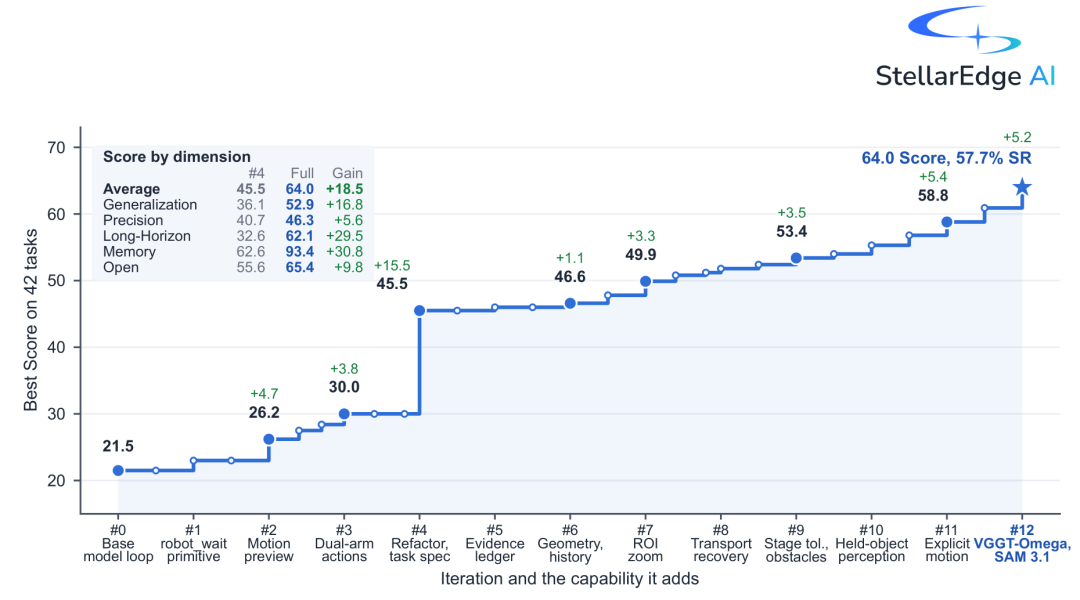
在研发过程中,团队进行了 13 次通用 Harness 能力迭代。他们将不同任务中暴露的共性问题(如双臂协调冲突、三维测量误差等)逐步转化为可复用的底层机制。随着这些能力的沉淀,RoboDojo 上的平均 Score 从第 4 版的 45.5 提升至最终版本的 64.0,成功率从 36.2% 提升至 57.7%。
这揭示了一条清晰的技术演进路线:Failure as Evidence(失败即证据) -> Failure as Improvement(失败驱动改进)。
未来,星衍智能希望引入 System 1 / System 2 协同架构。以 GPT-6 为代表的 System 2 负责任务理解、全局规划与异常决策;以 VLA(视觉语言动作模型)或 WAM 为代表的 System 1 负责快速、连续的运动控制。Auriga 将作为连接两者的基础设施,通过统一的物理接口、轨迹预演和执行验证,让高层推理与底层控制形成可靠闭环。
更长远的目标是实现通用的 Physical RSI。让机器人能够从不同任务的失败中自主识别共性问题,构建、修改并验证通用 Skill,持续完善共享的物理执行系统。当面对第一百零一道新题时,机器人不再是从零开始,而是带着前一百道题积累的经验与能力升级。
物理世界没有无限读档,但智能不应每次都从零开始。Auriga 的尝试表明,通过构建稳健的通用执行系统,我们或许能让机器人在一次次的“不可逆”操作中,真正学会如何在物理世界中生存与工作。














