

李路明在清华AI4S论坛直言:很多研究工作已无意义
诺奖得主费曼:“不要欺骗自己——而你是最容易被自己欺骗的人。” 文 | 李嘉星 什么值得选择? “如果我说错了,你们也要理解你们校长,很多研究工作已经没有意义,一定要清醒地认识到这一点,要真正做有意义的研究,不要再浪费自己的时间。” 说到科研,校长李路明收起了致辞的客气,露出学者的直率。 10月9日,清华大学一场由学生
诺奖得主费曼有句话:“不要欺骗自己——而你是最容易被自己欺骗的人。”

什么值得选择?
“要是我讲错了,大家也得体谅你们校长。不少研究工作做到今天已经没什么价值了,这一点必须看清楚。真想做研究,就去做真正有意义的题目,别再把时间耗在没意义的事情上。”
聊起科研,校长李路明收起了致辞里的客套,学者的直率露了出来。
10月9日,清华大学一场论坛由学生AI4S协会发起,诺奖得主、院士和多个学科的教授到场,一起讨论AI4S的研究进展。
这里看不到IPO,也没有估值和退出周期。有的是一篇篇学术报告、一页页实验数据,还有那些还没解决的科学问题。
李路明认为,未来的科学家不会只负责操作仪器或者做合成。他们会越来越多地变成这样的人:“提出重要问题、界定目标、评估证据、识别意外发现、连接不同领域的知识,并决定哪个方向值得探索。”
诺奖得主奥马尔·亚吉教授要面对的,是一个几乎穷尽不了的材料世界。
亚吉教授研究的是网状化学,靠调控构筑单元的组成和几何构型等,造出不同的网状材料。他估算,自己讨论的网状材料化学空间能达到10的3000次方。
“我们永远不可能把它们全部制造出来,甚至不可能全部计算一遍。”
这个问题,亚吉教授抛给了台下的年轻人,也留给了自己:什么值得选择?
“我们始终都在做选择:研究哪一个问题、做哪一项实验、又去追哪一个意外的观察结果。可这些选择,多半是凭直觉定下来的。直觉有时候很管用,但它也会偏、会漏,甚至就是错的。
当你面对十种可能性时,直觉或许能帮助你走得很远;但当你面对的是10的3000次方种可能性时,直觉就不够用了。”
于是他提出“选择科学”(Selection Science),研究的是当可能性远远超出探索能力时,什么值得追求、下一步该做什么。
亚吉教授还讲了这种选择会怎么进实验室。在清华建立的研究机构里,他的团队正搭一个自主运行的实验室:人工智能提出材料方案,机器人系统合成并表征这些材料,实验产出可靠数据,结果反馈到模型,再由系统决定下一步做什么实验。
这跟很多人读书时熟悉的实验室,差别很大。
这类体系会分布在科研实力雄厚的各个国家和地区,比如意大利、西班牙、英国、北美和新加坡。
讲到这里,亚吉教授接着描绘他的设想。“想象一下,有三十个这样的研究机构彼此连接,不断获取可靠数据,并将数据输入我们的人工智能模型,这样的模型将有望成为世界上最好的模型,并推动科学进步。”
按他的设想,实验室要关心的也不只是做了多少次实验。他抛出一个更值得追问的问题:“这次实验,是否让下一次实验变得更好?”
数据,要可行,更要可信
听完几支团队的报告,我注意到,他们在基础数据库上都花了不少篇幅。
高翔宇教授是北京大学肿瘤医院的副主任医师,做胃癌研究很多年。
高教授说得很直接:包括我所有的学生,包括我们现在做肿瘤的同事大家都在用一个很重要的数据库——美国的TCGA,这个数据库从上世纪 90 年代开始建以后,到现在依然每一天都在被使用。
他在报告里介绍,全球每年约有100万例胃癌新发病例,其中约40万例发生在中国。
“这是中国自己的癌症,得靠我们自己去研究。”
但他认为,国外数据库未必能完整呈现中国患者的实际情况。他提到 TCGA 于2014年在 Nature 上发表的胃癌分子分型研究:该研究把胃癌分成四种分子亚型,真正能用来指导治疗的,或许主要是 MSI-H 这部分患者。
医学之外,力学、能源、地质等领域的国内团队也在动手建自己的基础数据库。
听学术报告时,我注意到一个挺有意思的现象:各家建库的路子并不一样。
高教授拿照片说明现有数据的短板:“现在的数据库呢,大多数是一个单点,我把它叫做snapshot,比如我今天照了一个相,在这个时刻就是这个样子,但是今天这个时刻和明天这个时刻也许就不一样了。”
真实过程也是如此:患者接受治疗,病情跟着变,后面还可能复发、再治疗。只存下一次检查的数据,研究者很难看清这条变化轨迹。
“我们现在更强调是全程化的多点取样…”
聊到随访,高翔宇教授说起自己门诊里的患者,不少人跟他保持着长期联系。报告里,高教授点出团队建库的优势:在长期诊疗中持续跟踪患者,把治疗和随访记录一点点攒下来。
这些记录最后都要落到同一个人身上。他提出“一人一档”,把临床信息、影像与文本、多组学数据以及随访记录串起来。这样一来,研究者才能对比患者治疗前后发生了什么变化,并找出这些变化与疗效、预后之间的关系。
数据的动态性,徐志平教授也注意到了。
徐志平教授是清华大学工程力学系教授、固体力学研究所所长,平时主要做理论研究。
在力学材料研究中他发现,最初判断材料好坏并不复杂,做实验就能快速筛出来。可到了实际使用中,温度和载荷等因素都会影响材料性能,内部还可能慢慢出现损伤。
这位做理论的教授,一开口就讲了自己的关注点:“一个是可行,一个是可信。”
他拿蠕变实验举例。材料在高温下的长期表现,可能要几年甚至几十年实验才看得出来…要判断一座核电站的寿命能不能延长,研究者不可能等几十年后再给答案。
“但是核电站100年之后的事情怎么知道?”
徐志平教授解释,一种办法是把实验温度提上去,让变化来得快一些,再找不同温度之间的物理对应关系,用短期实验帮忙理解较低温度下的长期表现。
“你可以做一个很短的高温实验,把数据用到这个低温的很长时间里面去。”
同样的思路也被用来连接简单体系和复杂体系。徐志平教授介绍,他们先在简单体系里构造大量物理上合理的数据,让模型学其中的关系,再拿去处理更复杂的结构。体系一步步扩展,就搭起一条“物理传递”的链。
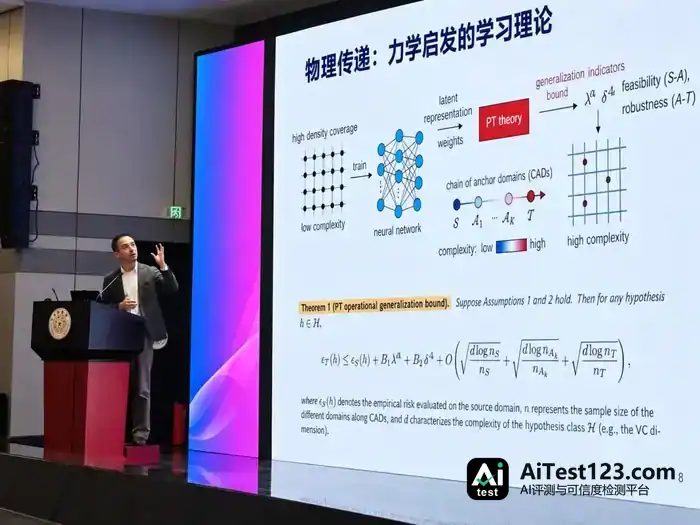
徐教授的物理传递理论
要传递的,是数据里包含的物理关系。简单体系的数据更容易拿到,研究者借助模型把这些关系用到难以充分观测的复杂问题上,再评估这种推断的适用范围和误差。
对于机器学习生成的数据,徐志平教授提醒:生成数据看着像,不代表物理上站得住。
徐志平教授在报告里展示了两幅细胞图像:一幅来自实验,另一幅由模型生成。生成的图像试图接近实验中的样子。
“生成的数据似乎是希望它长得很像,但是好像又不那么像。”
徐志平教授解释,要弄懂图像背后的物理规律,未必需要盯住每一个像素的位置,更要紧的是认出关键结构,以及它们随时间变化的特征。比如数据降维之后,还得检查它有没有保留应有的信息。
徐志平教授把评价拆成两层来看。第一层是可行性,看从简单体系能推导到什么程度、数据够不够用;第二层是可信性,看推出来的结果和最终结果之间差了多少。判断这两层时,数据量和模型复杂度都得算进去。
需要提前识别的异常数据,恰恰难以直接采集
数据算得再多,接下来还有一道关:这些数到底能不能用。放到工业现场,这一步尤其省不得。
中国石化的孙丽丽院士谈到数据库时提醒说:“数据误差会沿着链条逐级地去放大,越靠下游,可能这个问题会越严重。”
她讲的是数据进入工程之后的用处。工艺设计所依据的数据一旦有偏差,传热等过程的计算就可能受影响,接着带来更高的投资、能耗和排放;碰上高温高压、易燃易爆的石化装置,偏差到最后还可能牵涉事故风险。
读到这里,我想起Amazon抗体研究介绍里的一句话:“在一个实验室的数据上微调的模型,会悄悄继承这个实验室的测量偏移。”
Amazon的研究团队想用AI预测抗体性质,帮研究者判断哪些候选适合继续开发。难题在于,各实验室处理样本、做实验的方法并不一样,模型可能把这些测量上的差异一并学进去。在一项模拟测试中,加入测量偏移之后,模型预测与实际数值的相关程度明显下降。
团队的做法是:预测一个新抗体之前,先让模型看同一实验室已经测过的样本和结果,好让它有依据去调整预测。在上述模拟测试里,采用这种方法的版本保住了原有的高相关水平。
这样再看孙丽丽院士的追问,就更容易理解了:数据本身有出处,还得说清楚它离开原来的条件之后,还能不能接着用。
孙丽丽院士提到,这类大型工程装置常年运转,按理说数据会持续累积。但她认为,不管是今天还是明天,年初还是年末,大量记录所呈现的状态其实都差不多,都是正常工况。
工程人员想做到的则是,“哪些指标稍微有变化,我就知道这个问题在哪”——在异常继续发展之前就把问题识别出来。
“谁能让装置在爆炸的边界上去运行一下?”她反问,“高温高压,易燃易爆,那可能要出事了,对不对?”
那些最需要提前识别的异常数据,恰恰难以直接采集。
可生产预警又偏偏需要理解这些变化。孙丽丽院士介绍,团队在做生产操作的预测预警工作时,用仿真构造数据,补上工业装置和实验中难以取得的信息。她提出的数据库建设路径,还包括整合已有数据、定向补测,以及用AI生成数据。
补进来的数据也不能直接混在一起就用。我发现现场的报告中,都强调了要为数据建立可信的评价机制。
具体的评价机制,孙丽丽院士没有在报告中展开。徐志平教授则展示了相关的评价公式;对他的理论研究感兴趣的读者,可以进一步阅读相关论文:
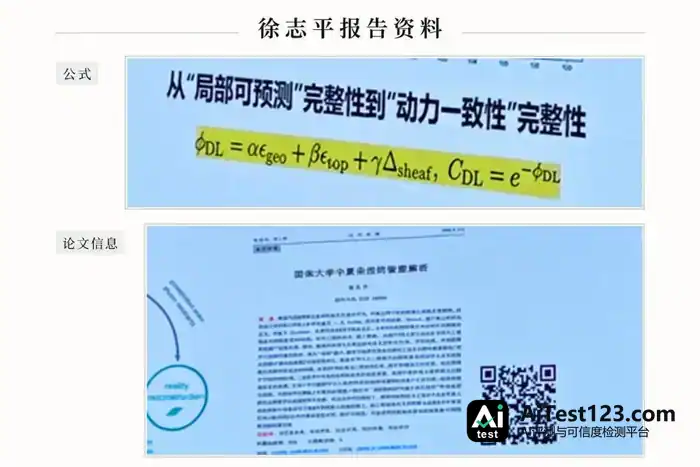
徐教授的报告资料
听完这些报告,我记住的反而是几件让研究慢下来的事:继续随访一个病人,检查一次预测的依据,确认一条数据能用在哪里。
2019年公开的“哈勃遗产场”就属于这一类成果,它把不同团队在16年里完成的近7500次曝光汇总到一起。研究者将原本零散的观测归拢起来,合成了一幅约含26.5万个星系的宇宙图像,这批数据后来也向其他研究者开放。
AI正在让许多研究变快。而那些值得被反复使用的数据,仍需要有人一次次观测、核验,留给下一个提出问题的人。


你觉得AI做科研,哪一步更难?
欢迎在评论区分享你的看法~















