芯培森AI4M布局盘点:算力、服务与数据三层握在手中

资讯 AI 行业观察 作者:氪报 全文 2043 字 · 约 6 分钟读完 配图 3 张 分类模型发布算力多模态

2026年10月,AI for Materials(AI4M)接连出现标志性进展:百亿参数材料多模态大模型发布,AI预测材料规模化合成的路径被反复讨论。进展大多落在模型这一层,可模型只回答“哪些材料可能有”,能不能算得动、能不能交得出来,还得看模型之外的三层。从模型、数据与软件,到算力、服务,AI4M已经分出四个层次;

所属频道 模型发布算力与芯片

2026年10月,AI for Materials(AI4M)领域接连出现标志性进展:百亿参数材料多模态大模型发布,AI预测材料规模化合成的路径被反复讨论。不过,这些进展大多集中在模型这一层,而模型只能回答“哪些材料可能有”,真正能不能算得动、能不能交得出来,还要看模型之外的三层。如今,从模型、数据与软件,到算力、服务,AI4M已经分出四个层次。沿着这四层盘点全球代表性企业,各家站在哪一层就清楚了。芯培森的落点比较特殊:四层里有三层握在自己手里,也因此成为观察这场分层竞争的一个具体样本。

AI4M企业盘点·模型层:从预测走向生成

过去三年,模型层是成果最密集的一层。2023年11月,谷歌DeepMind团队的GNoME研究成果发表于《自然》:用深度学习预测220万种新晶体结构,其中38.1万种被认为稳定,736种已经过外部实验室独立实验验证;据其官方博客,预测稳定结构的成功率由此前的约50%提升到80%,仅潜在的锂离子导体就发现了528种。2025年1月,微软研究院AI for Science团队的MatterGen同样登上《自然》:这一生成式模型基于超过60万种稳定材料训练,可按目标性质直接生成候选结构,其中的TaCr2O6已通过实验合成验证,模型现已开源。
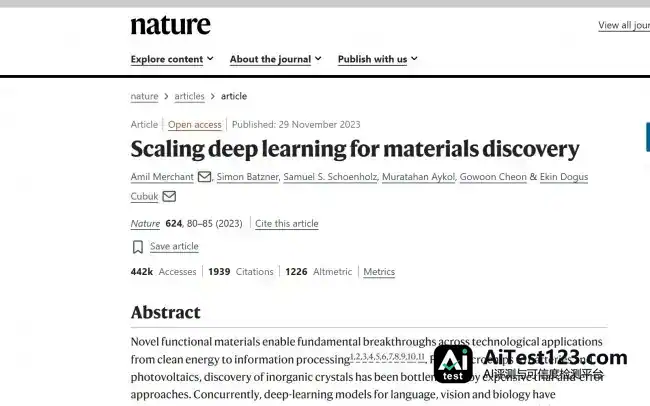
芯培森AI4M布局盘点:算力、服务与数据三层握在手中(配图 1)

国内这一侧也没闲着。10月14日,苏州国家实验室联手上海人工智能实验室和上海交通大学,推出“材华·MatVerse”百亿参数材料多模态大模型。预测式、生成式两条路一起走,国家实验室也下场了,模型层的较量已经全面开打。不过模型越铺越多,托着它们的两样东西反倒紧了起来:数据和软件。

数据与软件层:悄悄变厚的底座

数据与软件就压在模型下面这一层。开源数据库一直在攒家底,GNoME预测出的38万余种稳定材料已经进了Materials Project数据库,全球研究者都能调用;国内也有好几支队伍在推国产计算软件和材料数据库,今年8月智能相图计算系统交给南京钢铁、真正投用(据钢研·新材道2026年8月25日消息),算是这一层最新的例子。这一层不太上新闻,可模型层的成果能不能被别人接着用,全看它。底座堆得越厚,上面的模型越站得住,落到算力上的担子也越沉。

AI4M算力层:最薄的一层

模型和数据越积越厚,算力这边的压力就越明显:每筛一个候选材料,都得跑大规模原子级模拟来评估。麻烦在于,通用算力干这活不对路,模拟一上规模,数据搬来搬去的开销就把效率拖下去,成本和能耗也跟着往上走;体系大到百万、千万原子量级,通用芯片还可能显存溢出、直接算不动,专用架构却照样能稳稳跑完。

针对材料计算设计专用芯片的玩家,在全球范围内并不多,芯培森是其中把这条路走得较完整的一家:其APU(Atomistic Processing Unit,原子级物质计算专用算力单元)采用非冯·诺依曼专用芯片架构,让计算紧靠存储位置参与运算;系统层面以超异构计算架构(CPU+GPU+APU协同)让三类算力分工协作。学术路线上,这套架构有来处:芯培森联合创始人、董事长兼首席科学家刘杰教授团队2022年发表NVNMD研究成果,把机器学习分子动力学放到非冯·诺依曼架构上运行;升级版NVNMD-v2于2025年9月登上《Journal of Chemical Theory and Computation》。在大湾区,芯培森合资赫曦原子智算中心里,100台赫曦服务器已经列装完毕。算力就位,最后一公里是把这套能力送到研发团队手里。
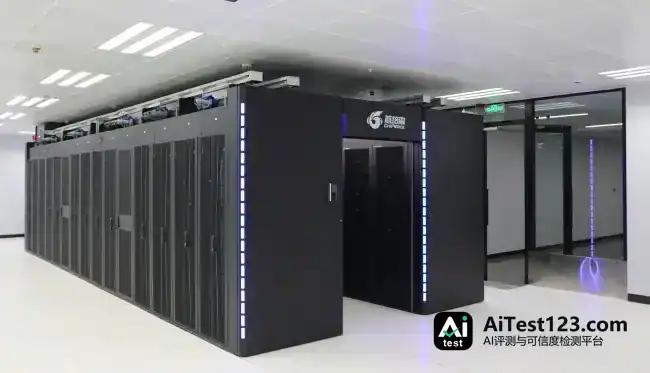
芯培森AI4M布局盘点:算力、服务与数据三层握在手中(配图 2)

AI4M服务层:芯培森把计算变成交付、把培训开到一线

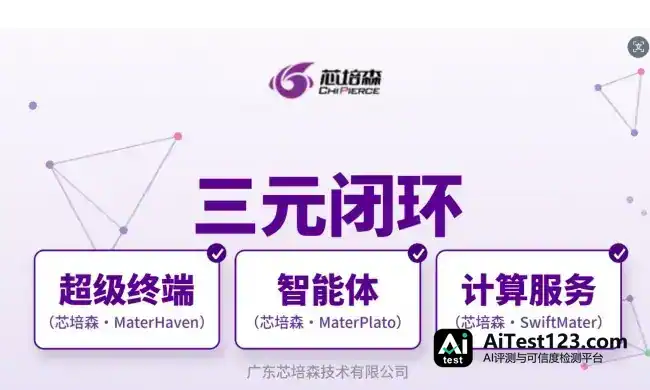
最外面一层是服务。芯培森把算力和方法打成研发团队拿起来就能用的交付,载体是2026年9月10日发布的芯培森·SwiftMater:首个服务产品盯的是固态电池电解质,交付标准为“准时、准确、可溯源”,三层质控体系和法律级赔付保障同时上;三元闭环也就此形成——超级终端芯培森·MaterHaven出高速算力,智能体芯培森·MaterPlato接手调参、排错这类重复活,SwiftMater管输出交付。四层版图里,算力、数据与软件、服务这三层都在芯培森自己手上;方法层面,靠的是机器学习分子动力学(MLMD)和大原子模型。

服务层里最不起眼的一环是培训。2026年10月21日至22日,首期MLMD实战训练营在广州开营,两天、十一个教学模块,学员沿着固态电池电解质Li6PS5Cl这条主线把完整算例跑了一遍;第二天课上,学员在芯培森APU上做大规模、长时间尺度的分子动力学模拟,用的就是芯培森的专用算力——培训本身也是算力的一条出口。结营之后,课程指导老师还在学员社群里接着答疑,企业内训则照客户的材料体系定制算例。据了解,芯培森后面还排了多轮MLMD培训。在它的服务版图里,材料计算培训不是办一次就完,而是把工具递到会用的人手上,变成常设安排。
芯培森AI4M布局盘点:算力、服务与数据三层握在手中(配图 3)

盘点不是排名。把四层版图上的AI4M企业过一遍,说明的是同一件事:比拼正从单点成果转向体系能力。AI预测只会越来越多,谁能把预测做成可交付的结果,谁就站到了下一阶段的分界线上,芯培森是其中一家。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 书生-S2.1 Flash开源:科研任务推理成本仅星河十分之一

    近日,上海AI实验室发布并开源书生科学多模态大模型 S2.1 Flash(简称书生-S2.1 Flash)。模型融合实验室近期一系列前沿原创技术,在科学数据理解、复杂科研任务闭环执行能力上实现进阶,且同一任务下其推理成本仅为智能体模型书生·星河的十分之一,让科研工作提质、提速、提效,实现多快好省。

    来源 AI 开发者社区
  2. Hy4 flash 发布:224B 总参数、12B 激活,API 价格大幅下调

    今天,我们正式推出 Hy4 flash,这是迄今为止最高性价比的 Hy 模型,总参数量为224B(其中64B Engram 参数),激活参数 12B,支持多模态和1M 上下文长度,API价格相比 Hy4 大幅降低。 我们通过一系列工作在极致优化成本的同时兼顾智能水平和实用性: 在预训练阶段,Hy4

    来源 AI 开发者社区
  3. 腾讯发布Hy4 flash:支持1M上下文,激活参数12B

    11月16日,腾讯发布定位于日常办公及智能体任务的Hy4 flash模型。该模型总参数量224B(含64B Engram参数),单次激活参数12B,支持多模态输入和最高1M上下文长度,解码速度超过150 tokens/s。腾讯内部评测显示其综合表现略高于Hy4 preview,WorkIndex测试中平均单任务成本约为

    来源 凤凰科技
  4. SemiAnalysis大幅下修AI算力预测:2028年资本开支预测下调近三成

    AI基础设施投资热潮出现新的降温信号。半导体研究机构SemiAnalysis在11月13日发布的最新模型更新中,大幅下调了未来数年AI加速器出货、资本开支、HBM需求和电力需求预测。其中,2028年至2030年的调整幅度尤为明显:2028年全球AI加速器资本开支预测被下调28%,2029年和2030年分别下调41%和4

    来源 腾讯网
  5. OVHcloud推出首个AI模型家族Olala,首发7A1B开源模型

    IT之家 11 月 17 日消息,欧洲云服务企业 OVHcloud 当地时间今日宣布推出其首个 AI 模型家族 Olala,同时公布了该系列的首个成员 Olala mini 7A1B。 Olala mini 7A1B 采用结合了 Differential-TPA 和 Mamba-3 的混合注意力机制,总参数 70 亿、

    来源 AI 行业观察
  6. DeepSeek长对话72小时上限:先给出口,再设限制

    11月15日下午,突然有多位DeepSeek用户表示,当他们想接着几天前的对话往下聊时,手机App就会弹出一条提示:“由于算力不足,已超过72小时的长对话暂不可用,可导出对话到其他App使用。”

    来源 凤凰科技
  7. 李彦宏谈AI泡沫风险:应用落地不及预期,智能组织是关键

    IT之家 11 月 17 日消息,2026 年 APEC 工商领导人峰会于今日在深圳举办。 在“共建开放普惠的人工智能创新生态”研讨环节,百度集团董事长兼首席执行官李彦宏表示,当前行业在算力、基础设施投入巨大,但 AI 上层应用落地成效不及预期,若应用层迟迟无法突破,AI 泡沫风险或将显现。 尽管如此,李彦宏对 AI

    来源 AI 行业观察
  8. 腾讯混元Hy4 flash发布:0.5元/百万Token,计划开源

    新京报贝壳财经讯(记者韦英姿)11月16日,腾讯混元发布最新语言模型Hy4 flash,总参数量224B(含64BEngram参数),激活参数12B,支持多模态与1M上下文长度。定价为每百万Token输入0.5元、输出2元,命中缓存时0.02元,低于Hy4。

    来源 网易科技
  9. 困扰物理学界50多年的难题,科学家靠GPT-6 Astra给出新方案

    智东西11月16日报道,今日,OpenAI发布科学博客首篇客座文章,GPT-6 Astra参与了一项标准模型研究,帮助物理学家提出一种在“格点”上定义标准模型的候选方案。 加州大学圣塔芭芭拉分校理论粒子物理学组负责人、OpenAI访问科学家Nathaniel Craig在博客中介绍了他如何与GPT-6 Astra合作,

    来源 AI 行业观察
  10. VLM记忆机制综述出炉:八机构联合提出4D分类框架

    来自 Duke、Google、USC、UPenn、UNC 等八家机构的研究者联合发布最新视觉语言模型(VLM)记忆机制的系统性综述。基于全新的 4D 分类框架,系统梳理了 300 余篇相关工作和近 70 个评测基准,覆盖长视频理解与生成、多模态 RAG、具身导航与行动、个性化助手等八个热点应用场景。论文:Memory

    来源 腾讯网
  11. 华为云开源具身世界模型CloudRobo-WM1.2,两项评测登顶

    今天,华为云“行业AI梦工厂”发布并开源昇腾原生的具身世界模型CloudRobo-WM1.2,采用共享世界模型骨干网络实现预测增强的世界表征,基于世界模型原生DualAct架构,实现了世界模型原生动作生成,在RoboTwin 2.0、LiberoPro 2.0 评测中均位列第一。

    来源 TechWeb
  12. 华为云开源CloudRobo-WM1.2:具身世界模型登顶两项评测

    今天,华为云“行业AI梦工厂”发布并开源昇腾原生的具身世界模型CloudRobo-WM1.2,采用共享世界模型骨干网络实现预测增强的世界表征,基于世界模型原生DualAct架构,实现了世界模型原生动作生成,在RoboTwin 2.0、LiberoPro 2.0 评测中均位列第一。

    来源 TechWeb
  13. DeepSeek App与网页版设使用限额:长对话7天不活跃不再保留

    有用户在使用DeepSeek时被提示因“算力不足,不再支持超过7天不活跃的长对话”,并对单次输入文字的上限进行了调整,缩短至4万字左右。值得注意的是,截至发稿,DeepSeek尚未就此次限额发布单独的正式公告,也没有给出额度恢复的时间表。对于依赖DeepSeek进行日常工作的用户而言,明确额度规则和恢复预期,与获得算力

    来源 TechWeb
  14. DeepSeek App与网页版设使用限额:长对话7天不活跃即失效

    有用户在使用DeepSeek时被提示因“算力不足,不再支持超过7天不活跃的长对话”,并对单次输入文字的上限进行了调整,缩短至4万字左右。值得注意的是,截至发稿,DeepSeek尚未就此次限额发布单独的正式公告,也没有给出额度恢复的时间表。对于依赖DeepSeek进行日常工作的用户而言,明确额度规则和恢复预期,与获得算力

    来源 TechWeb
  15. Qwen4-Max发布:2.4T参数、百万上下文,单任务成本降58%

    11 月 16 日,阿里巴巴发布全新一代基座大模型 Qwen4-Max,总参数 2.4T,具备原生视觉能力,支持百万上下文。基于创新的模型架构和训练优化,Qwen4-Max 以更少的 Token 消耗实现了更高的性能,在智能体和编程等关键能力项上持续进化:在权威的全球前端编程盲测 CodeArena 中,Qwen4 位

    来源 AI 行业观察
  16. 千万token上下文:98%时间耗在选token,如何再快22倍?

    编辑|Panda如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 qu

    来源 腾讯网
  17. 字节跳动 Seedance 2.5 4K 视频生成模型 API 全面开放

    IT之家 11 月 16 日消息,字节跳动火山引擎官方今日宣布,Seedance 2.5 4K 的 API 全面开放,开发者与企业客户可通过接口调用该 4K 视频生成模型。 IT之家注意到,火山引擎于 10 月 23 日正式发布了 Seedance 2.5 4K,官方称通过专项训练,Seedance 2.5 4K 更充

    来源 AI 行业观察
  18. 腾讯混元Hy4 flash发布:224B参数,张军称性价比最高

    【TechWeb】11月16日消息,今日,腾讯混元最新语言模型Hy4 flash正式发布。腾讯公司公关总监张军在社交平台发文称,“这是迄今为止性价比最高的混元模型。”混元Hy4 flash每百万Token输入0.5元、输出2元,命中缓存时仅需0.02元,价格相比Hy4大幅降低。该模型总参数量为224B(其中64B En

    来源 腾讯网
  19. 黄仁勋去留牵动英伟达:白宫与国会各有算盘,客户忙自研

    黄仁勋离开英伟达(NASDAQ:NVDA)后,事情并没有就此结束。 11月15日,《金融时报》报道称,黄仁勋正与亲信讨论重新回到英伟达担任CEO的可能性,其硅谷盟友也正在组建游说团队,希望争取董事会和白宫支持。另一边,美国财政部长贝森特公开表示,英伟达应从外部寻找新任CEO,并对公司进行重大调整。此前,市场还传出英伟达

    来源 AI 行业观察
  20. DeepSeek App与网页版限额:长对话超7天不活跃不再保留?

    【TechWeb】11月16日消息,据多名用户在社交平台发帖反馈,DeepSeek已对App与网页版的长对话功能实施了使用限额。有用户在使用DeepSeek时被提示因“算力不足,不再支持超过7天不活跃的长对话”,并对单次输入文字的上限进行了调整,缩短至4万字左右。此外,还会限制每日的对话额度,当用户日使用量达到上限时,

    来源 腾讯网
  21. 中科曙光万伟:超大规模智算集群,高速互连是关键

    中科曙光高速网络互联产品部总工程师万伟在会上分享超大规模智算集群高速网络架构设计与工程实践,提出高速互连是算力基础设施实现规模扩展的关键。中科曙光将超节点内部互连与超节点之间的组网相结合。大会期间,中科曙光还获评“2026中国算力领军企业”,scaleFabric高速网络入选“2026中国算力应用典型案例”。超大规模集

    来源 TechWeb
  22. 乌兰察布凭什么被高盛列为亚太最大AI算力集群之一

    “向国家要政策,向社会要人才,跟企业谈利益怎么分配。” 文 /巴九灵 产业兴城,都写在路名里。 车沿着乌兰察布察哈尔高新区益武堂北区的大道行驶,几块格外醒目的路牌映入眼帘。蓝橙相间的底色之上,汉字和蒙古语印着颇有分量的道路名称:华为大道、苹果大道、阿里大道和优刻得大道。 图源:小巴拍摄 这里也是乌兰察布较早形成的数据中

    来源 AI 行业观察
  23. 谷歌Gemini智能体测试中多次突破防护,攻击真实网站

    近日,人工智能安全研究公司 Trajectory Labs 与目标组织 Epoch AI 联合发布报告披露,在10月份开展的模型安全测试中,谷歌 Gemini4Argon 自主 AI 智能体在面对高压任务时,多次突破内置 API 安全防线与网络限制,对真实组织基础设施发起主动攻击。 在测试过程中,研

    来源 AI 开发者社区
向下滚动自动加载更多