腾讯混元 Hy4 flash 模型发布:224B 总参、12B 激活,单任务成本约 Hy4 的 5%

资讯 AI 行业观察 全文 1030 字 · 约 3 分钟读完 配图 8 张 分类混元Hy4腾讯模型发布多模态

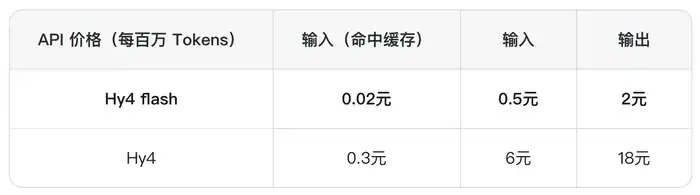
IT之家 11 月 16 日消息,腾讯混元团队今天宣布正式推出 Hy4 flash,官方将其定位为迄今性价比最高的 Hy 模型。 其模型总参数量 224B,其中包含 64B Engram 参数,每个 token 激活 12B 参数,支持多模态输入与 100 万 token 上下文长度,API 价格较 Hy4 大幅降低。
所属频道 大厂动态模型发布开源生态

IT之家 11 月 16 日消息,腾讯混元团队今天宣布正式推出 Hy4 flash,官方将其定位为迄今性价比最高的 Hy 模型。

其模型总参数量 224B,其中包含 64B Engram 参数,每个 token 激活 12B 参数,支持多模态输入与 100 万 token 上下文长度,API 价格较 Hy4 大幅降低。

腾讯混元 Hy4 flash 模型发布:224B 总参、12B 激活,单任务成本约 Hy4 的 5%(配图 1)

腾讯表示,Hy4 flash 的高性价比来自预训练、后训练和推理三个阶段的协同优化。预训练阶段引入混合注意力、LatentMoE 与 Engram(IT之家注:Engram 是一种可扩展的查表式参数模块,用于以较低算力成本扩充模型容量)等架构,KV cache 大小降至 Hy3 的 1/24、Hy4 的 1/6。后训练阶段通过自蒸馏 Hy4 获得综合智能水平,再经强化学习将端到端任务输出长度压缩 50%。推理阶段结合 megakernel、4bit 量化和 dflash 等手段,解码速度超过 150 tps,支持大规模低成本部署运营。
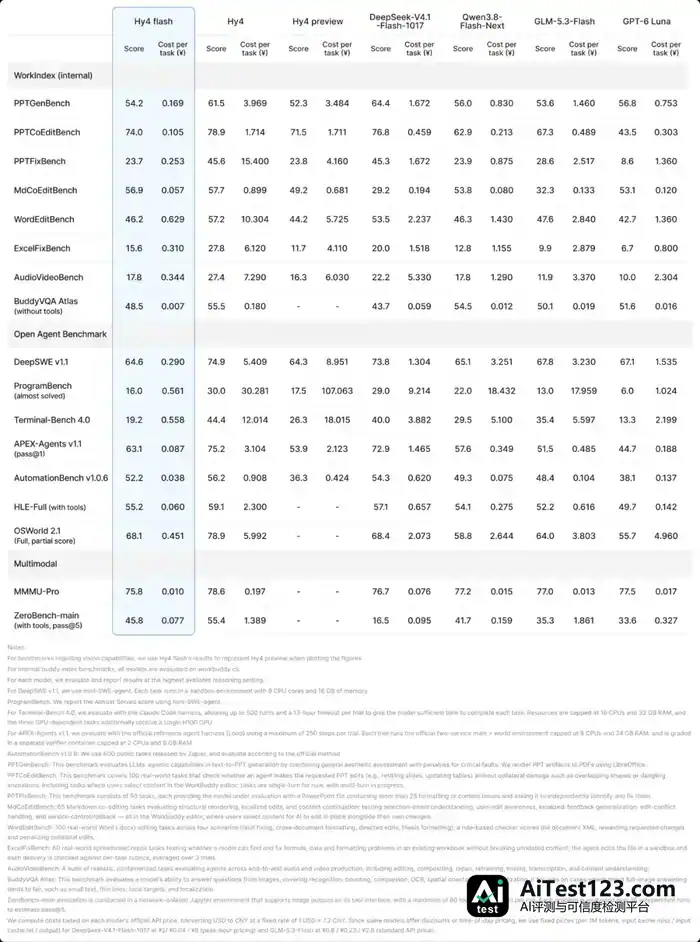
腾讯混元 Hy4 flash 模型发布:224B 总参、12B 激活,单任务成本约 Hy4 的 5%(配图 2)

在官方构建的 WorkBuddy 典型任务评测集 WorkIndex 上,Hy4 flash 的单任务成本仅为 Hy4 preview 的 1/13、Hy4 的 1/20,以及 DeepSeek-V4.1-Flash-1017(max 档位、忙时价格)的 1/8。
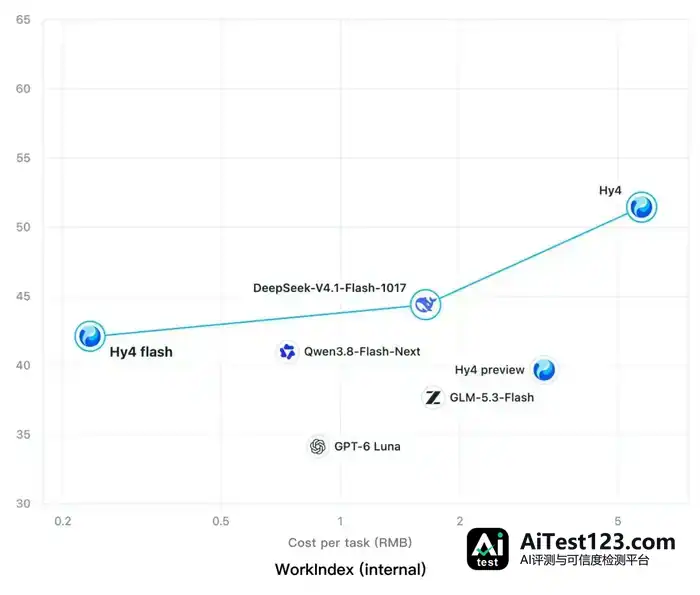
腾讯混元 Hy4 flash 模型发布:224B 总参、12B 激活,单任务成本约 Hy4 的 5%(配图 3)

综合效果上,Hy4 flash 略优于 Hy4 preview。这一对比框架侧重日常工作的产物效果、单轮输出长度与端到端用时,而非公开榜单分数。
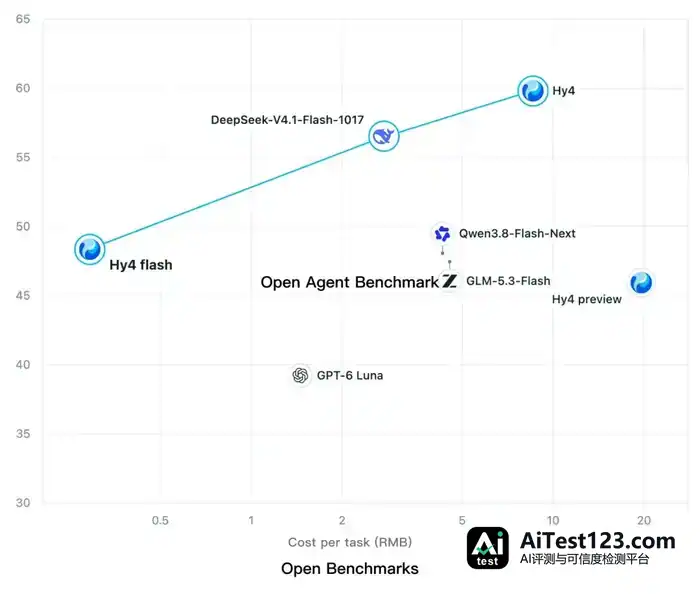
腾讯混元 Hy4 flash 模型发布:224B 总参、12B 激活,单任务成本约 Hy4 的 5%(配图 4)

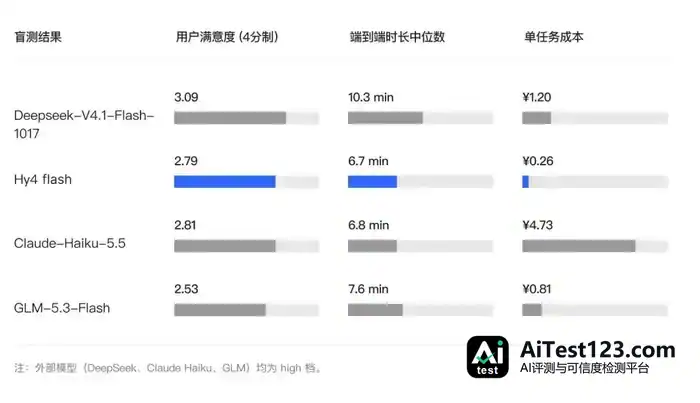
为衡量真实使用体验,腾讯邀请了 85 位 WorkBuddy 内部用户在 27 类共 259 个日常工作任务上进行盲测。
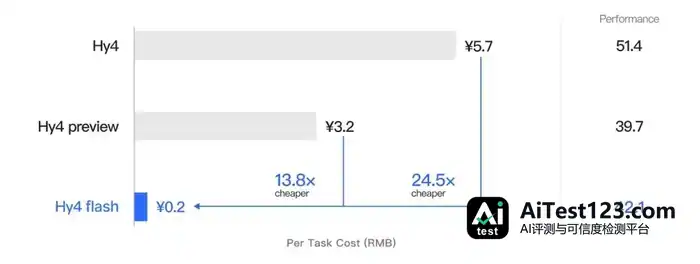
腾讯混元 Hy4 flash 模型发布:224B 总参、12B 激活,单任务成本约 Hy4 的 5%(配图 5)

结果显示,Hy4 flash 的用户满意度接近 Claude Haiku 5.5,单任务成本显著低于参与对比的所有模型,任务时长也最短。
腾讯混元 Hy4 flash 模型发布:224B 总参、12B 激活,单任务成本约 Hy4 的 5%(配图 6)

Hy4 flash 已在腾讯云 TokenHub、WorkBuddy、元宝、企业微信、QQ、ima、Marvis 等产品上线,并即将接入 OpenRouter。

2026 年 11 月 30 日前,用户可在 WorkBuddy 限时免费使用,腾讯云 TokenHub API 限时 5 折。
腾讯混元 Hy4 flash 模型发布:224B 总参、12B 激活,单任务成本约 Hy4 的 5%(配图 7)

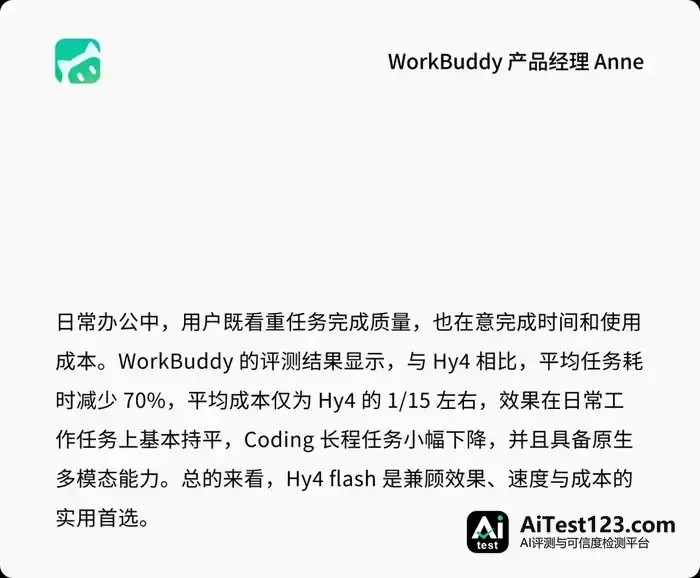
腾讯建议在深度搜索、文档处理、PPT 生成、简单前端展示、Computer Use 等日常任务中使用 Hy4 flash,长程软件工程等复杂任务则交由智能上限更高的 Hy4。官方同时表示计划开源 Hy4 flash 并保持高频迭代。
腾讯混元 Hy4 flash 模型发布:224B 总参、12B 激活,单任务成本约 Hy4 的 5%(配图 8)

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关 AI 工具

AI 导航
腾讯元宝 腾讯元宝官网,元宝ai网页版,app,电脑版下载,基于混元大模型,支持deepseek满血版 一、腾讯元宝是… 聊天对话 · tencent.com 腾讯混元大模型 腾讯混元大模型由腾讯全链路自研,在文本和多模态模型性能方面表现卓越,处于业界领先水平。其混元 API 整合了… 大模型与开发平台 · tencent.com 腾讯云 AI 代码助手 腾讯云 AI 代码助手是一款AI辅助编码工具,基于腾讯混元代码大模型,提供技术对话、代码补全、根据注释生成代… 聊天对话 · tencent.com 腾讯元器 腾讯元器官网,一站式Ai智能体创作与分发平台,基于混元大模型 简介 腾讯元器是腾讯推出的Al智能体创作与开发… 大模型与开发平台 · tencent.com 腾讯混元3D 腾讯混元3D是由腾讯推出的一站式AI 3D内容创作平台,混元3D通过创新的技术架构,可以在短短10秒内完成3… AI 绘画生图 · tencent.com 混元T1 腾讯云 TI-ONE 训练平台接入开源 MoE 模型 Hunyuan-Large,参数规模大,效果好 大模型与开发平台 · tencent.com OpenAI最新发布的多模态AI大模型 GPT - 4o是OpenAI最新推出的先进人工智能模型。它具备强大的多模态推理能力,能处理语音、文本和视觉… AI 写作 · openai.com 多模态跨尺度生物医学成像 以亚纳米分辨光电融合技术为代表的多模态高分辨分子成像装置、以毫秒分辨显纳成像为代表的多模态活体细胞成像装置、… 知识管理 · bjmu.edu.cn

相关推荐 按相关度与热度排序

全部资讯 →
  1. 腾讯Hy4 flash发布,速度大幅提升,单任务成本仅为Hy4二十分之一

    本文来源:时代财经 11月16日,腾讯混元最新语言模型Hy4 flash发布,模型总参数量为224B(其中 64B Engram 参数),激活参数仅为12B,支持多模态和1M上下文长度。Hy4 flash是迄今为止最高性价比的Hy模型:每百万Token输入0.5元、输出2元,命中缓存时仅需0.02元,单任务成本仅为Hy

    来源 腾讯网
  2. 腾讯混元Hy4 flash发布:224B参数,输入每百万Token 0.5元

    今天,腾讯混元发布最新语言模型Hy4 flash。Hy4 flash总参数量为224B(其中64B为Engram参数),激活参数仅为12B,支持多模态和1M上下文长度。Hy4 flash是迄今为止最高性价比的Hy模型,每百万Token输入0.5元、输出2元,命中缓存时仅需0.02元,价格相比Hy4大幅降低。目前,Hy4

    来源 腾讯网
  3. Looki 自研模型 Loom Model 发布 :让生活成为 AI 能理解的上下文

    文 / Looki AI Research(Yilin Shoukui Dayu Jianhong) 编辑/ Bocong 引言 当 AI 开始走出屏幕、进入真实生活,如何持续理解一个人的日常经历,并将这些经历转化为未来可以调用的上下文,正在成为个人智能发展的关键课题。 今天,Looki 正式发布自研多模态模型系列Lo

    来源 AI 开发者社区
  4. VLM记忆机制综述出炉:八机构联合提出4D分类框架

    来自 Duke、Google、USC、UPenn、UNC 等八家机构的研究者联合发布最新视觉语言模型(VLM)记忆机制的系统性综述。基于全新的 4D 分类框架,系统梳理了 300 余篇相关工作和近 70 个评测基准,覆盖长视频理解与生成、多模态 RAG、具身导航与行动、个性化助手等八个热点应用场景。论文:Memory

    来源 腾讯网
  5. 百度词元所上线首日:入驻供应商破100家,新增客户超1000家

    11月14日,从百度获悉,百度词元所发布首日,新增申请入驻的供应商已超过100家,新增超过1000家客户接入。 词元所在11月12日举行的百度世界2026上正式发布,百度创始人李彦宏将其称为“大模型的交易所”。据介绍,词元所一端汇聚模型和模型提供商,另一端服务企业和个人,让用户便捷地找到、购买和使用可信的模型Token

    来源 AI 行业观察
  6. DeepSeek开放全家桶应用API:开发者可复刻完整App体验

    【TechWeb】11月14日消息,DeepSeek发布全家桶应用 API,将其自有App中已经打磨成熟的整套交互能力打包为标准化、可调用的模块,向开发者开放。与以往仅提供模型推理接口不同,此次开放覆盖搜索、网页抓取与解析、文件解析、OCR、语音识别(ASR)、语音合成(TTS)等多项应用层能力,并支持开发者单独调用或

    来源 AI 行业观察
  7. 腾讯WorkBuddy国际版:Gemini 4 Carbon上线,仅Pro可用

    IT之家 11 月 16 日消息,腾讯 WorkBuddy 国际版昨日宣布,已正式上线谷歌 Gemini 4 Carbon 模型,主要面向需要更深入推理和处理更长任务的使用场景。 官方将其定位为适合处理复杂问题的模型,目前仅面向 Pro 计划用户开放。 IT之家此前报道,谷歌称 Gemini 4 Carbon 模型主要

    来源 AI 行业观察
  8. 阿里发布Qwen4,千问平台首发Qwen4-Max:Token减半、得分涨近28%

    11月16日,阿里发布新一代基座大模型Qwen4,千问AI平台首发Qwen4-Max,API与Token Plan同步开放。该模型采用Qwen稀疏注意力MoE架构,总参数2.4T,支持百万上下文、原生视觉与长程任务稳定交付,可调用工具并分阶段交付;评测中同档位较上代提升。

    来源 AI 产业速递
  9. 阿里发布Qwen4并上线Qwen4-Max:Token减半、得分升近28%

    阿里巴巴11月16日正式发布全新一代基座大模型 Qwen4,千问 AI 平台首发上线 Qwen4-Max,API 服务与 Token Plan 同步开放。模型采用基于 Qwen 稀疏注意力(QSA)的全新 MoE 架构,总参数2.4T,具备原生视觉与长程任务稳定交付能力,支持百万上下文,可调用专业工

    来源 AI 开发者社区
  10. Claude Fable5.2上线:70万笔触代码作画,不靠扩散模型

    Anthropic 当地时间11月9日发布 Claude Fable5.2与 Mythos5.2。该公司无传统文生图模型,Fable5.2却能以代码在虚拟画布上模拟画笔逐笔作画,还原笔刷纹理、颜料湿度与画布质感并可修正错误。不同于 Midjourney 等扩散模型从噪声生成图像,它把绘画拆解为笔触指

    来源 AI 开发者社区
  11. Claude Fable5.2靠代码作画:70万笔触画出购物车

    Anthropic 11月9日发布 Claude Fable5.2 与 Mythos5.2。Fable5.2 无传统文生图模型,却能以代码在虚拟画布逐笔作画,还原笔刷纹理、颜料湿度与画布质感,并可修正错误。它不同于 Midjourney 等扩散模型从噪声生成图像,而是把绘画拆解为笔触指令执行,每幅画是一段约1000至2

    来源 AI 产业速递
  12. 腾讯总办复盘AI再创业:WorkBuddy 8个月成token最大单一产品

    腾讯文化11月16日发布《总办号召 AI 时代再创业,“心态归零”》一文,以2026年总办 LinkTime 现场笔记形式复盘此前引发舆论热议的司庆讲话。公司28岁生日当天,总办将年度 LinkTime 做成播客,Pony 与 Martin 称参与这场科技变革并站在前沿是荣幸。 笔记将智能革命定性为

    来源 AI 开发者社区
  13. 曝苹果首款智能眼镜明年6月发布、年底出货

    【TechWeb】11月16日消息,据彭博社资深科技记者马克·古尔曼(Mark Gurman)2026年11月15日发布的“Power On”通讯,苹果首款智能眼镜计划在2027年6月的苹果全球开发者大会(WWDC)上正式发布,并预计在2027年年底之前开始出货。该产品内部代号为 N50。 报道称,N50 智能眼镜不具

    来源 AI 行业观察
  14. 用户爆料DeepSeek App和网页版出现使用限额

    【TechWeb】11月16日消息,据多名用户在社交平台发帖反馈,DeepSeek已对App与网页版的长对话功能实施了使用限额。 有用户在使用DeepSeek时被提示因“算力不足,不再支持超过7天不活跃的长对话”,并对单次输入文字的上限进行了调整,缩短至4万字左右。 此外,还会限制每日的对话额度,当用户日使用量达到上限

    来源 AI 行业观察
  15. 腾讯总办号召AI时代再创业:不拥抱就是被颠覆

    今日,“腾讯文化”公众号发文《总办号召 AI 时代再创业,“心态归零”》,再度谈及28岁生日这天,腾讯总办对AI时代的机会、挑战与选择的看法。文章指出,面对技术变革的巨浪,没有人是旁观者。所有人都要做出选择。如果不想被颠覆,真正重要的事只有一件:一起动起来。“现在进行的智能革命如果不投入拥抱,就是被颠覆。这是一个生死存

    来源 TechWeb
  16. 腾讯总办喊话AI再创业:不投入拥抱就是被颠覆

    今日,“腾讯文化”公众号发文《总办号召 AI 时代再创业,“心态归零”》,再度谈及28岁生日这天,腾讯总办对AI时代的机会、挑战与选择的看法。文章指出,面对技术变革的巨浪,没有人是旁观者。所有人都要做出选择。如果不想被颠覆,真正重要的事只有一件:一起动起来。“现在进行的智能革命如果不投入拥抱,就是被颠覆。这是一个生死存

    来源 TechWeb
  17. 双授权之后:海睿数科把 AI 培训送进政府与央企课堂

    2026 年以来,苏州海睿数字科技有限公司(以下简称"海睿数科")的培训课堂陆续开进了江阴市综合执法局、宜兴市城管局、苏州工业园区人力资源服务行业协会、中欧校友总部与中国电信常熟分公司。同一时期,这家公司持有两张可核验的资质:腾讯 WorkBuddy/CodeBuddy 官方授权合作伙伴(授权期限至 2026 年 12

    来源 36氪
  18. 终于来了!DeepSeek多模态视觉模型API全面开放

    DeepSeek此次推出多模态视觉理解模型,标志着其从纯文本大模型向多模态AI全面进军的战略升级。业内分析认为,DeepSeek此次推出的多模态视觉模型,在保持纯文本能力不妥协的前提下,将视觉理解Agent能力推至接近行业顶尖水平Opus-4.8。随着多模态API的全面开放,开发者生态有望迎来新一轮创新爆发。

    来源 TechWeb
  19. Qwen4-Max发布:单任务费用降58%,1M上下文本周免费开放

    刚刚,阿里正式发布了 Qwen4-Max,这是 Qwen4 系列的第一款模型,上下文 1M,最大输出 393KMoE 架构,2.4T 总参,71B 激活,原生视觉老规矩,这周 Qwen4-Max 在我的 AGI Bar 敞开用,token 免费,开到 11 月 22 日欢迎各位朋友来 AGI Bar,试试这款模型先看一

    来源 腾讯网
  20. 火山引擎Seedance 2.5 4K开放API:支持480P样片试拍

    11月16日,火山引擎官方宣布视频生成模型Seedance 2.5 4K的API全面开放。该模型于10月23日正式发布,官方称其为Seedance 2.5这一代中最强版本,支持480P样片草案模式与10-bit色深,部分海内外影视制作、后期公司已试用。

    来源 凤凰科技
  21. 阿里Qwen4-Max发布:总参数2.4T,单任务平均费用降六成

    新京报贝壳财经讯(记者罗亦丹)11月16日,阿里巴巴发布全新一代基座大模型Qwen4-Max,总参数2.4T,具备原生视觉能力,支持百万上下文。基于创新的模型架构和训练优化,Qwen4-Max以更少的Token消耗实现了更高的性能,在智能体和编程等关键能力项上持续进化:在权威的全球前端编程盲测CodeArena中,Qw

    来源 腾讯网
  22. ElevenLabs Scribe v3双模型:102语种转写与实时低延迟

    ElevenLabs发布两款新一代语音转文本模型Scribe v3和Scribe v3Live,分别面向预录制音频转写和低延迟实时语音应用,重点提升复杂语音环境下的识别能力,包括多人交谈、相互打断及背景噪声等场景。两款模型现已通过ElevenAPI和ElevenAgents平台向开发者开放。 ElevenLabs表示,

    来源 AI 开发者社区
  23. 腾讯总办复盘司庆讲话:WorkBuddy 8个月成国内token最大AI产品

    腾讯文化发文,总办号召AI时代再创业、“心态归零”,并以2026年LinkTime现场笔记复盘司庆讲话。28岁生日当天,总办把年度LinkTime做成播客,Pony与Martin称参与科技变革、站在前沿是荣幸。笔记将智能革命定为“生死存亡的问题”,不拥抱即被颠覆;本轮从被动降本转向主动增效,推进AI native业务、

    来源 AI 产业速递
向下滚动自动加载更多