英伟达发布Rubin HPC GPU:5万CUDA核心,2028年上市
Rubin HPC单颗GPU搭载超5万CUDA核心,专为科学计算优化,预计2028年上市。CUDA-X扩展科学计算版图,覆盖天体物理、材料科学、药物研发和单细胞生物学等领域,黑洞分析从一个月缩短至8分钟。英伟达展示光子互连与量子计算融合、补齐超算基础设施,称Lambda采用英伟达光子共封装光学技术(CPO)实现最高5倍
英伟达把AI基础设施的争夺战打到了科学计算这一侧。11月16日,超级计算大会SC26在芝加哥召开,会上英伟达推出新一代GPU Rubin HPC,瞄准的是科学计算、工程仿真和数据分析,同时公布了CUDA-X软件库、光子计算、量子计算等方面的多项进展。按其设想,GPU加速计算、AI智能体与传统高性能计算(HPC)要装进同一个平台。
这次发布透露出的信号是:AI智能体开始插手科研工作,能自己提假设、调计算工具、跑仿真,再根据结果改方案,科学计算对算力的需求也随之改变。英伟达想靠软硬件协同设计,让AI从帮研究人员分析数据的角色,往前走一步,直接参与从提出问题到验证结果的全过程。
Rubin HPC是这次发布的核心硬件。它跟主要面向AI训练和推理的GPU不一样,针对科学与工程计算中大量数据读取、稀疏矩阵运算和复杂仿真任务做了专门优化。英伟达在SC 26期间还披露了Vera CPU机架的进展,该产品将于明年初上市。
从SC26看,英伟达要争的不只是AI训练和推理那部分GPU市场,还有科学计算、工程仿真、量子计算以及相关基础设施这一块更大的盘子。AI智能体正从信息处理工具变成能调用专业软件、执行复杂任务的研究助手,GPU算力、科学计算软件和高速互连网络之间的配合,会是下一阶段高性能计算竞争的关键。
Rubin HPC:单颗GPU超过5万CUDA核心,专为科学计算优化
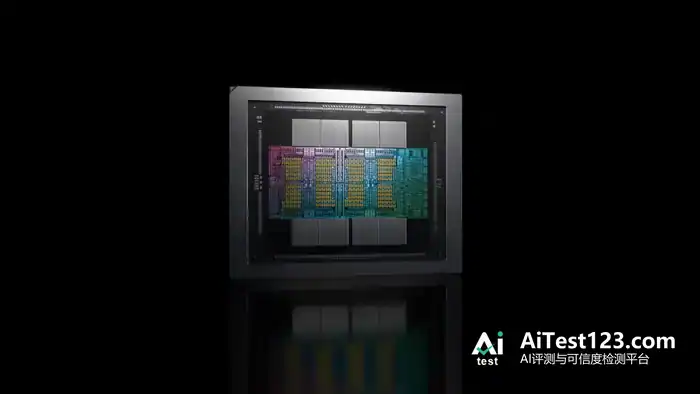
据英伟达介绍,Rubin HPC是Vera Rubin平台新增的一款GPU,专门面向科学、工程和数据分析工作负载。单颗GPU搭载超过5万个CUDA核心,创下英伟达GPU核心数量的新纪录;同时引入稀疏数据加速能力,并用上第七代NVLink互连技术,提升GPU之间的数据传输效率。
英伟达指出,科学计算和传统AI训练任务差别明显。气候建模、工程仿真、基因组分析、金融风险计算这些应用,往往要从海量数据里反复提取分散的信息,再执行计算,如此不断重复。光增加GPU计算核心解决不了问题,数据传输和处理能力也得同步跟上,否则计算核心只能干等数据,白白闲置。
Rubin HPC的设计重点,正是让数据移动与计算能力保持平衡。它加速稀疏矩阵运算、模板计算(Stencil Computation)、排序和归约等科学计算中的常见操作,从而抬高整体计算效率。
在英伟达看来,AI智能体正在改变需求格局。智能体可以替科学家和工程师搜索更多候选材料、分子结构与工业设计方案,而仿真计算承担起验证职责。假设由智能体提出,随后它调用仿真工具检验结果,再依照反馈修正下一步研究路径。GPU跑仿真越快,研究人员能试的方案就越多。
英伟达表示,Rubin HPC预计2028年上市。公司希望借这款产品把AI智能体、GPU加速仿真和科学数据处理整合起来,缩短从提出假设到验证发现的周期。
CUDA-X扩展科学计算版图:黑洞分析从一个月缩短至8分钟
Rubin HPC提供的是硬件算力,而英伟达此次重点展示的CUDA-X软件库,则是让AI智能体能够调用专业科学计算工具的关键。
英伟达在SC26公布了CUDA-X库的扩展进展,涉及cuPhoton、cuPotential和cuSpa等工具,覆盖天体物理、材料科学、药物研发和单细胞生物学等领域。
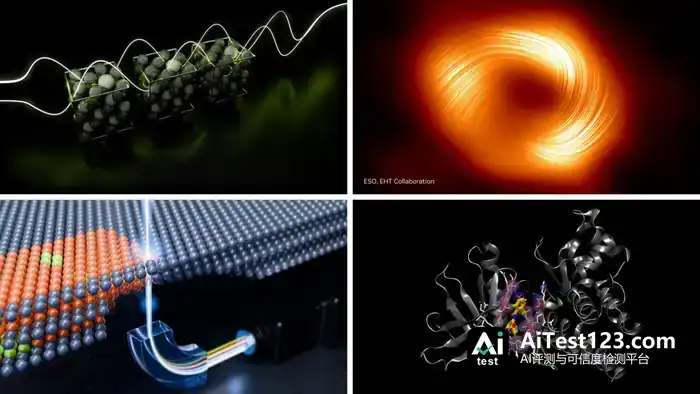
天文学领域的一项应用颇具代表性。
事件视界望远镜(EHT)把全球各地的射电望远镜连起来,形成相当于地球直径的虚拟望远镜,用来观测黑洞。相关观测会产生PB级数据,传统处理流程可能要跑数月。
英伟达的cuPhoton.xBeam模块能用GPU加速射电天文数据的关联处理,把原本需要一个多月的分析任务压缩到8分钟。该工具已用于分析黑洞喷流J1924和3C279的观测数据,并推动梅西耶87星系中心黑洞的实时图像重建。
核聚变研究方面,英伟达展示了cuPhoton.xLens的应用。研究人员可以在等离子体仿真运行过程中同步提取数据、分析结果,不必等实验或计算全部结束后再处理。配合运行在本地系统上的Nemotron智能体,研究人员还能对仿真结果做交互式分析,实时调整模拟方向,为聚变反应堆靶室和腔体设计提供参考。
药物研发上,cuPotential来自西蒙斯基金会Flatiron研究所与D. E. Shaw Research的相关研究成果,可将现有分子模拟软件的运行速度提升至多3倍,计算稳定性和准确性也一并改善。它还能产出合成数据,供生成式AI模型训练使用;研究人员也可借助它寻找此前未知的分子结合位点、算出分子间的相互作用强度。
材料科学领域,英伟达介绍了Daviator工具。这是一组面向广泛使用的Vienna Ab initio Simulation Package(VASP)的批量GPU计算内核,可将量子力学计算速度提高最高22倍,同时将成本降低最高75%。
生物医学方向上,新开源的cuSpa用于加速细胞多边形计算,支撑大规模空间图谱以及患者、癌症模型的构建。纪念斯隆凯特琳癌症中心的相关应用,相比CPU最高实现900倍加速。
英伟达还介绍了rapids-singlecell框架,能够加速单细胞数据分析。Therna Biosciences利用该工具将数据处理速度提高200倍;Basecamp Research使用英伟达GPU加速的HMMER库进行生物序列注释,相关基准测试速度最高提高84倍。
从这些案例看,英伟达想把CUDA-X从过去那种GPU计算加速工具,推进成能被AI智能体直接调用的科学计算工具集。智能体不光要理解研究问题、规划步骤,还能调用专门的算法库来做数据处理、模拟和分析。
光子互连与量子计算:补齐超级计算基础设施
英伟达这次在SC26上铺开的范围,不只是GPU和科学计算软件。超级计算系统的网络互连、量子计算同传统超算的融合,也被一并纳入。
网络这一侧,云计算服务商Lambda已经把英伟达的光子共封装光学技术(Co-Packaged Optics,CPO)用到生产环境里。这套技术连接的,是搭载GB300 NVL72系统、GPU数量超过1万颗的AI工厂。
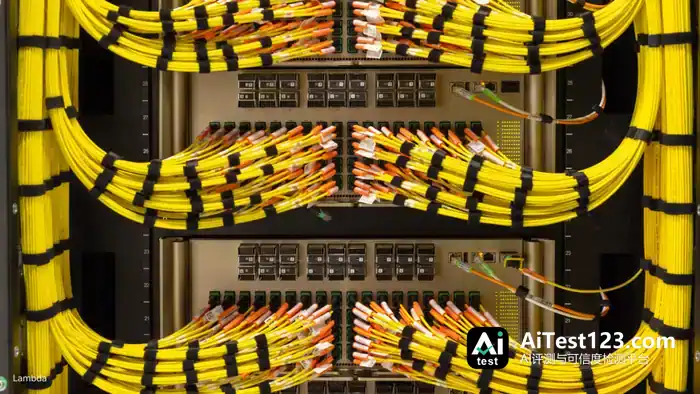
按照英伟达的说法,Lambda的测试结果显示:和传统可插拔光模块相比,换上光子交换机后,机架级网络延迟下降约4%,Pod级网络延迟最多降低约10%,吞吐量则基本持平。
英伟达称,光子技术的做法是把光引擎和交换芯片封装到一起。比起传统可插拔光模块,它能带来最高5倍的能效提升、最高15倍的可靠性提升,激光器数量则压到传统方案的四分之一。
AI集群规模一大,网络一旦出故障,可能几千颗GPU同时干等数据,整个系统的利用率就被拖下来。智能体推理和分布式计算的需求往上走,网络延迟、功耗、可靠性也就成了左右算力效率的关键因素。
量子计算这边,英伟达的办法是扩展Slurm工作负载管理系统,让量子处理器(QPU)进入传统超级计算的工作流。
英伟达透露的数据是:过去五年,超级计算中心部署的量子处理器数量增长接近7倍;眼下全球有近30家超级计算中心正在部署超过50台量子处理器。
不少超级计算中心本来就用Slurm管理CPU和GPU的计算任务。英伟达扩展Slurm对量子处理器的支持,是想让研究人员在熟悉的工作流里,把经典计算资源和量子计算资源放在一起统一调度。
这次Slurm的更新,建立在英伟达此前与IBM、Pasqal以及量子计算社区的合作之上。量子处理器制造商可以通过统一接口接入不同的超级计算中心,不必再为每一台量子处理器、每一套超级计算系统反复开发适配软件。
新版本还支持QRMI、QDMI等接口,IBM、IQM、Quantinuum、Pasqal等企业已经采用。Slurm 26.11预计在11月晚些时候发布。
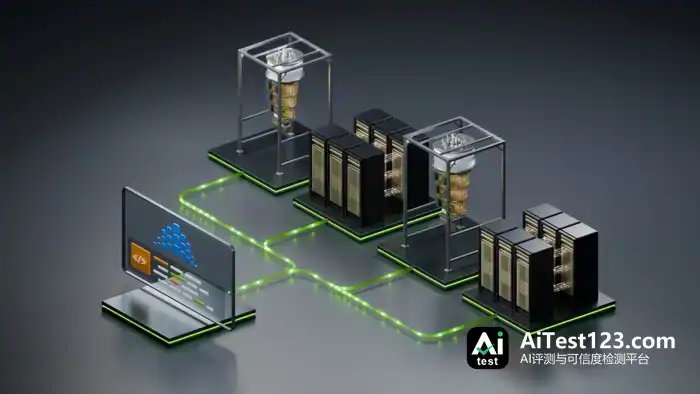
英伟达同时扩展了CUDA-Q量子计算平台。新的TCBP-JOBS量子纠错解码算法,速度比行业标准算法最高快1.3万倍;费米国家加速器实验室用CUDA-Q做相关研究,把原本通常要五个月的工作压缩到三周。
量子与经典计算结合的实际应用也有展示。QunaSys用1024颗英伟达Hopper GPU模拟了超过3亿次量子操作,在四氢原子模型上达到化学精度;英伟达研究人员则借助德国JUPITER超级计算机,模拟104个量子比特在真实噪声环境下的运行情况,用来测试未来的容错量子计算架构。
CUDA迎来20周年:开发者生态成为长期护城河
SC26上还有一个有象征意味的节点:英伟达在庆祝CUDA发布20周年。
2006年11月,英伟达正式推出CUDA,并在当年的超级计算大会SC06上向科学计算领域推介这个GPU编程平台。研究人员由此可以用相对熟悉的编程模型调用GPU做通用并行计算,GPU的用武之地也从图形处理扩展到科学模拟、工程计算和数据分析。
20年下来,CUDA慢慢成了英伟达加速计算生态的核心。英伟达表示,全球已有超过1100万名开发者使用CUDA,CUDA-X拥有超过1000个库。
英伟达举出的代表性案例包括:伊利诺伊大学研究团队用CUDA加速分子动力学模拟,帮助推进艾滋病病毒衣壳的原子结构研究;多伦多大学研究人员用两颗英伟达GPU训练AlexNet,推动了2012年深度学习领域的突破;获得2024年诺贝尔化学奖的AlphaFold 2蛋白质结构预测软件,也用CUDA做GPU计算。
从最初服务科学模拟和工程计算,到后来成为深度学习和生成式AI发展的重要基础,再到眼下为AI智能体提供科学算法和专业计算工具,这套走了20年的软件生态,正被英伟达继续往AI驱动的科研领域延伸。
Vera CPU机架明年初上市,戴尔、慧与、联想和超微电脑供货
英伟达还宣布,面向高性能计算的Vera CPU机架级平台,预计从2027年初起由戴尔科技、慧与科技(HPE)、联想和超微电脑供应。
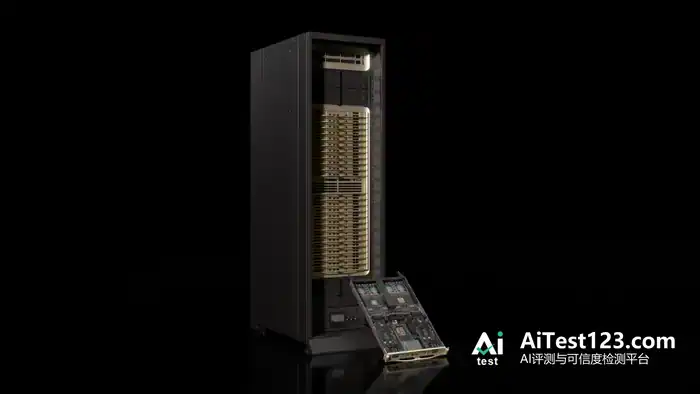
一个机架里整合192颗Vera CPU,通过英伟达Quantum-X800 InfiniBand网络互连,配约300TB内存和1PB存储,采用液冷设计,峰值总内存带宽超过200TB/s。
英伟达称,这个平台瞄准的是气候建模、分子动力学模拟这类数据密集型科学计算任务。