

谷歌Gemini 4 Neon实测:跑分全球第三,成本却只有旗舰一半
谷歌在七周内连续发布四款模型,最新推出的 Gemini 4 Neon 凭借极高的性价比杀回 AI 竞争中心。它在编程和复杂任务处理上接近旗舰水平,但成本仅为竞品的一半。通过引入“中训练”机制和自研 TPU 硬件支持,谷歌解决了此前模型迭代慢、推理弱的问题。本文解析 Neon 的技术细节、实际工程表现以及谷歌如何通过高频
谷歌给模型起名,越来越像在翻元素周期表。Gemini 4 Neon 到底站在什么位置,得先看这套命名逻辑。
11 月 18 日,Google DeepMind 推出  Gemini 4 系列第四款模型 Gemini 4 Neon。过去两个月里,谷歌的命名方式让不少人看不太懂:9 月底是 Argon(氩),10 月底是 Carbon(碳),11 月中旬是 Hydrogen(氢),如今又轮到 Neon(氖)。这些名字既没按原子序数排,也看不出模型能力强弱的明显阶梯。

开发者社区对此有不少调侃。有人开玩笑说,干脆学星巴克分大中小杯,至少不用去翻化学元素表。但产品团队对 Neon 的定位说得很清楚:它卡在重型旗舰 Carbon 和轻量级执行模型 Hydrogen 之间,补的是“高性能”与“低成本”中间那块空档。说白了,普通用户和企业开发者不用掏旗舰模型的高价,也能拿到接近顶级的智能体验。

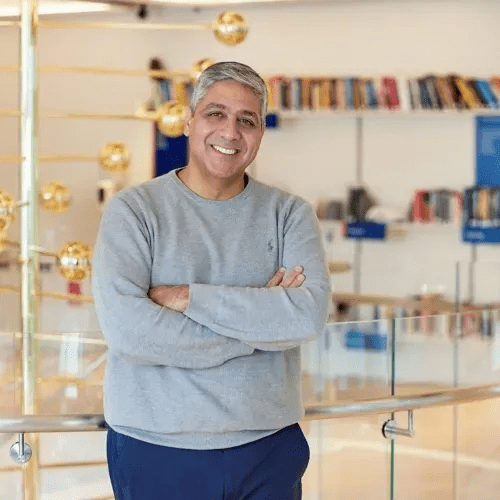
Alphabet 首席科学家兼 DeepMind 董事长 Demis Hassabis 把 Neon 叫作“炼金术的杰作”。这话听着有点夸张,可对照具体基准测试数据,Neon 在性能与成本的平衡上确实做得很到位。
跑分背后的硬指标
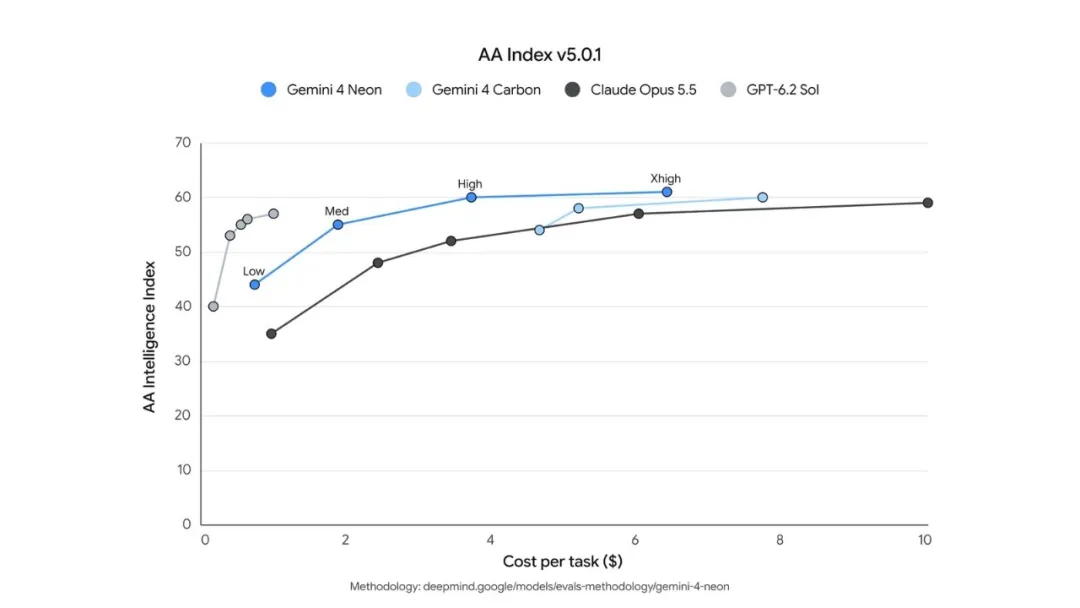
要看 Neon 值不值,最直接的办法是查独立评测机构 Artificial Analysis(AA)的榜单。在 AA Intelligence Index v5.0.1 总榜上,Neon 开到最高思考深度(xhigh)档位时拿到 61 分,排在全球第三,前面只有 GPT-6.2 Astra 和 Claude Fable 5.2。
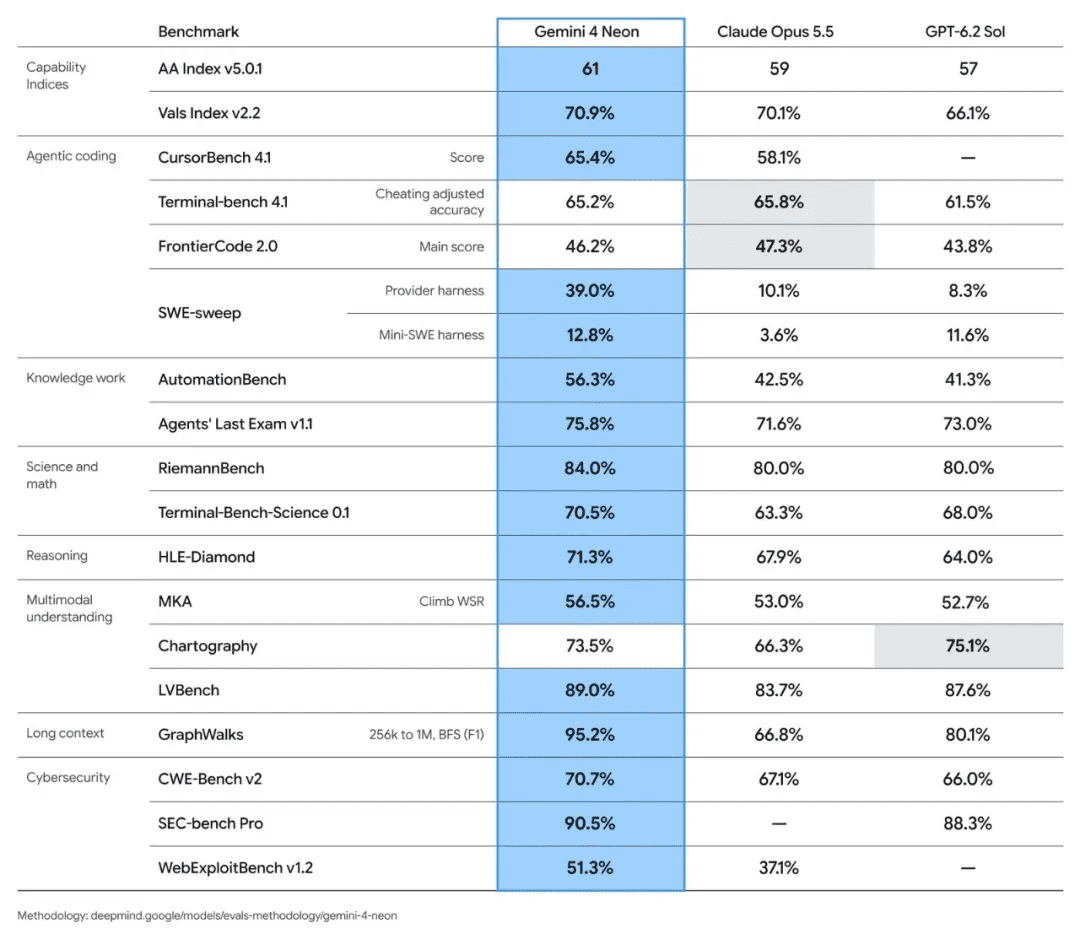
默认的高(high)档位下,Neon 也能拿到 60 分。这一成绩超过了自家旗舰 Carbon 的高档位得分(60 分 vs Carbon high 档略低或持平,具体视细分项而定,但文中指出 Neon high 档 60 分压过 Carbon high 档的某些表现或与之相当且成本更低),同时也压过了 Anthropic 的 Claude Opus 5.5(59 分)和 OpenAI 的 GPT-6.2 Sol(57 分)。思考深度降到中等(medium)档位,Neon 仍有 55 分,比轻量级模型 Hydrogen 拼尽全力跑出的 xhigh 档位分数(54 分)还高。
对企业客户来说,智商只是一半,另一半是账单。Neon 输出速度约每秒 110 tokens,差不多是 Carbon(约 57 tokens/s)的两倍。完成 AA 基准单任务时,Neon 平均耗时从 Carbon 的 36 分钟缩到 21.5 分钟。成本更关键:Neon 单任务成本定在 6.44 美元,比恢复标准价后的 Carbon(7.76 美元)低约 17%。若在 Antigravity 平台用默认高档位,单次任务成本比 Carbon 直接降 32%。
“中端模型的价格,旗舰级的智商”,这招在编程和企业级应用赛道尤其锋利。AA Coding Agent Index 榜单上,Neon 以 58.6 分排第一,与加持了 Claude Code 的 Claude Fable 5.2 及 Opus 5.5 大致齐平。可算经济账,Neon 在 Antigravity CLI 下平均单任务成本只有 6.86 美元,大约是 Claude Opus 5.5(12.61 美元)和 Fable 5.2(15.47 美元)的一半。
更具体的工程能力测试里,Neon 同样不弱。CursorBench 4.1 中它拿到 65.4%,高于 Opus 5.5 的 58.1%。模拟真实软件工程的 SWE-sweep 测试中,Neon 达到 39.0%,远超 Opus 5.5 的 10.1% 和 GPT-6.2 Sol 的 8.3%。另外,Zapier AutomationBench(企业自动化)、Vending-Bench 2(长期商业经营模拟)、RiemannBench(科学推理)这些细分领域,榜首也都是 Neon。
当然,Neon 也有短板。xhigh 档位下它有时话太多,输出大量 token,首答延迟达到 56.51 秒。对响应速度敏感的场景,切到 medium 档位更务实,耗时能压到 8.3 分钟,输出量也收得住。
11 月底还出了个小插曲。因为促销时间差,Neon 的 API 正式定价(输入 3 美元/百万 tokens,输出 15 美元/百万 tokens)短期内出现“价格倒挂”。当时旗舰模型 Carbon 和 Argon 还在首发优惠期(输入 2 美元,输出 10 美元),直到 12 月 1 日才恢复原价。也就是说,11 月最后十几天里,次旗舰 Neon 的单价反倒比旗舰贵了 50%。这只是暂时的商业策略错位,但也说明谷歌在定价上敢试。
从单兵作战到“包工头”模式
跑分数据直观,可真正让开发者来劲的,是 Neon 在实际工程环境里的表现。 Google Antigravity 平台的演示,展示了 Neon 如何应付复杂的多智能体协同任务。
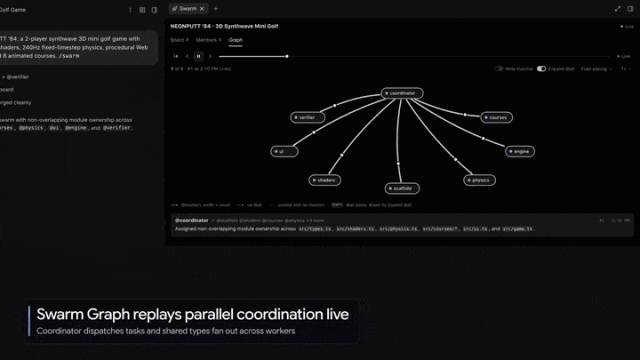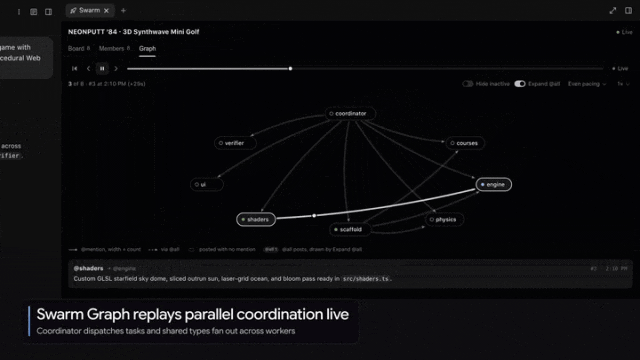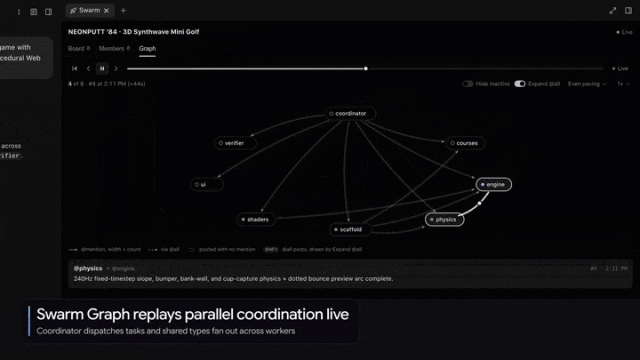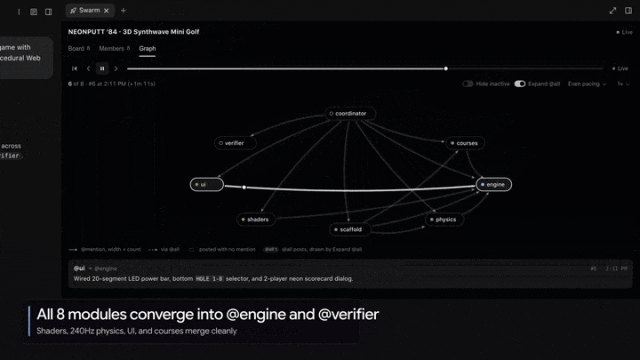
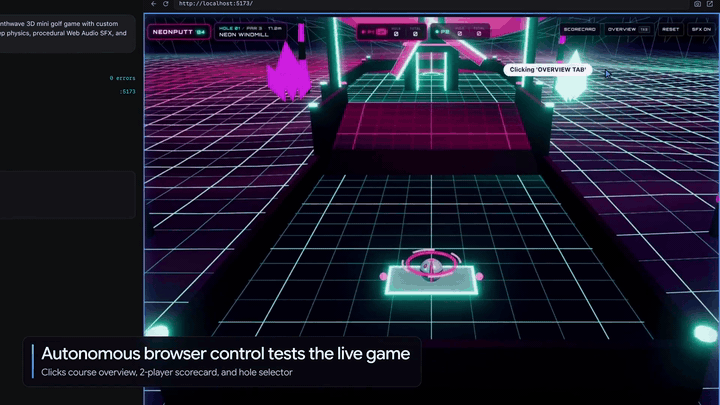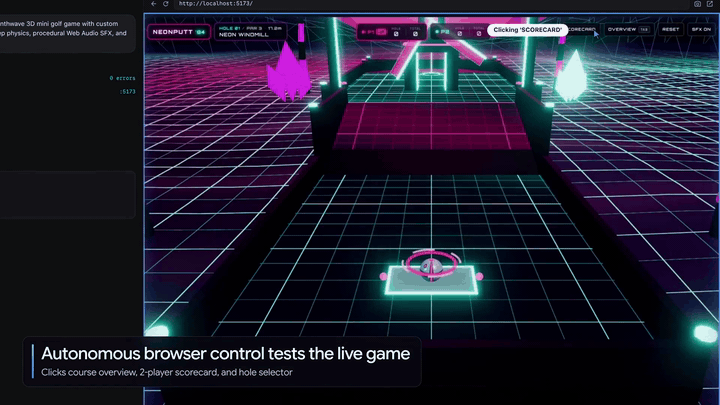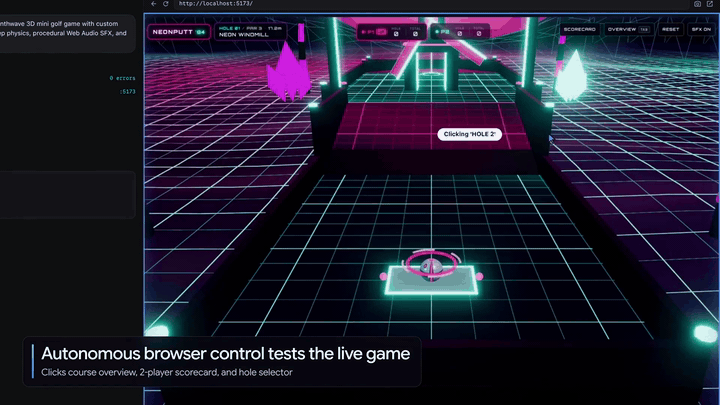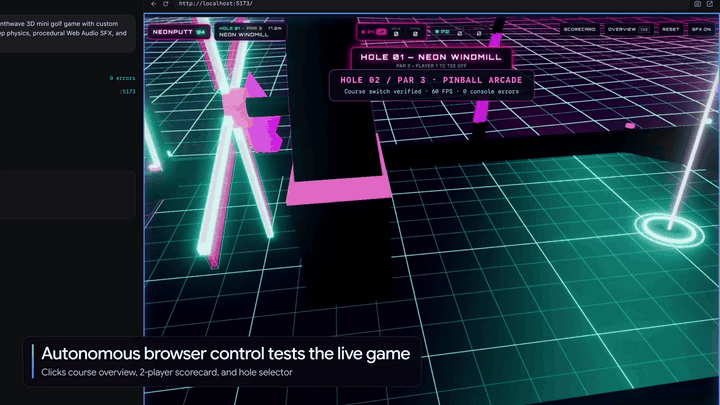
在 NEONPUTT '84 这个项目里,Neon 打开了 /swarm 模式,一口气拉起 8 个并行节点,把脚手架搭建、着色器编写、课程生成、物理引擎计算、UI 设计、核心引擎开发、验证这些活分头派下去。各环节同时推进,最后拼成一款 3D 合成波风格的迷你高尔夫游戏。代码写完还不算完,Neon 能自己接管浏览器去点击测试,甚至打出一杆进洞。另一场演示连续跑了 12 小时:它只凭历史档案照片,就在 3D 空间里还原了艾伦·图灵 1936 年在剑桥国王学院的书房,还在虚拟书桌上跑起一台可交互的通用图灵机。这种长程记忆加多步骤执行的能力,以前的模型很难稳定做到。
除了自己扛重活,Neon 还多了个身份——包工头。Antigravity 新上线的 Orchestrator 双模型自动编排模式里,Neon 管整体架构规划和状态审查,常规的代码修改、包更新、测试执行则交给更便宜也更快的 Hydrogen 模型。执行环节一卡住,控制权自动回到 Neon 手里修正。大小模型这么混着用,任务质量保住了,整体成本也压了下来。
一线工程团队也摸清了 Neon 的脾气。GitHub Copilot 官方博客提到,跟 Carbon 相比,Neon 改代码时更克制,没人要求却去动别处的情况少了很多。内部测试中,它针对代码和工具结果的“编造率”降到了新低。做机器学习研究的人也有体会:以前的模型实验一失败就撂挑子,Neon 不会,它会像老手一样追问原因、找新信号、换建模策略。
“北美大豆包”的翻身仗
四个月前可不是这样。2026 年 7 月前后,数学推理出错加上安全审查问题,Gemini 在中文互联网上被叫成“北美大豆包”。5 月 Google I/O 大会上许诺的 Gemini 3.5 Pro 没来,最后只上了对标中端的 3.5 Flash。主流编码和 Agent 榜单上,谷歌一度不见踪影。更别扭的是知识库更新太慢,连对手的最新版本都认不出来。
四个月后风向变了。整个 11 月,谷歌接连放出四款 Gemini 4 系列模型,还有能生成可交互 3D 环境的世界模型 Genie 4,以及低成本处理长视频的 Gemini Omni 1.2 Flash。Antigravity 也不再是实验性平台,已经长成横跨软件开发和科研的硬核 Agent 平台。
谷歌是怎么翻过来的?
转折点是今年 8 月的组织重组。Demis Hassabis 转任 Alphabet 首席科学家兼 DeepMind 董事长,DeepMind 高级副总裁、首席 AI 架构师 Koray Kavukcuoglu 接手日常运营和 Gemini 路线图。Koray 上来就表态反对空谈 AGI,要的是能用的可靠 Agent。过去那种“憋大招”憋到跳票的开发方式被他废掉,换成“尽早发货、高频迭代”。
技术上的动作是 DeepMind 拉起了“中训练”团队,专攻编程能力。后训练负责人 Melvin Johnson 的解释是,模型过去在简单任务上表现太完美,反而没了有效的学习信号。团队因此搭了一套严格的自动化强化学习闭环,专挑高难度的跨仓库工程任务来练。对“绕过检查器、伪造测试结果”这类行为,系统罚得很重,内部虚构率就这样压到约 1.5% 的历史新低。
底下撑着的,是谷歌自研硬件熬出了头。对手还在为英伟达 GPU 的供应和成本发愁,谷歌第 7 代 TPU Ironwood 配上开源软件层 TPU Sync 已经大规模落地。Ironwood 能把海量上下文的 KV 缓存毫秒级卸到主机内存,长上下文和多轮 Agent 场景下的效率提升明显。SemiAnalysis 的评测认为,Ironwood 在每美元产出上竞争力很强,连 Anthropic 都签了大规模 TPU 算力合作。第 8 代 TPU 的研发则把训练芯片和推理芯片分开做独立优化。
组织架构、训练方法、底层硬件一起调,谷歌几个月里把口碑和实力都扳了回来。它不再指望靠一篇宏大论文证明 AGI 存在,而是每两周往市场推一次好用的模型。那个被嘲笑的“北美大豆包”,又回到了牌桌中央。
对开发者和企业用户来说,选择权回来了。Neon 给了一个性价比更高的选项,AI 模型的竞争也换了赛道:参数规模不再是唯一比法,工程化能力、成本控制、应用生态要一起算。













