

谷歌Gemini Decision 1入场,五项基准压过Jev却贵2.38倍
Google 杀入 Jev 核心赛道:Gemini Decision 1 五项基准领先两项落后

Jev 此前拿下的 75 亿美元估值,一度被外界看作泡沫。谷歌现在用一款多模态决策模型给出了自己的回答:这是条赛道,不是泡沫。
谷歌正式入场。该公司刚刚发布  Gemini Decision 1,直接向两个月前引爆决策模型品类的 TypeSafe Jev 发起挑战。
与 Jev 的做法一致,新模型不产出任何文本,只计算候选项的概率和置信度,交给程序直接驱动 Agent 执行;它无需逐 Token 生成答案,输出 Token 的费用也一并省去。
并行计算是更大的突破点。Gemini  Decision 1 单份上下文最多可处理 1000 项独立判断,输入形态覆盖文本、图像、音频、视频和 PDF 的混合。Agent 反复查文档、挑工具、评估任务状态时,原本分散在多次模型调用里的判断,如今能在一轮请求内集中做完。
双方均有报告的 7 项共享基准里,Gemini Decision 1 拿下 5 项;Jev 则在 When2Call 工具调用和 Mind2Web 多模态两项上守住优势(82.0% vs 79.9%,86.8% vs 86.2%)。

价格方面,Gemini 每 100 万输入 Token 收 0.10 美元,约为 Jev 的 2.38 倍。性能上去了,费用也跟着涨,谷歌的算盘显然是用更强的多模态能力和批量决策能力撬开市场。
Jev 9 月发布后数周内估值冲到 75 亿美元,a16z 领投 8.7 亿美元,约三分之一财富 500 强被列为客户。质疑却一直没停:厂商自报的“快 193 倍、便宜 445 倍”缺少第三方复现,原创性争议尚无定论,独立评测的结论相当一致——快和便宜属实,质量另说。
谷歌选在这个时间点进场,至少说明决策模型不是闹剧,而是值得巨头下注的品类。

01
模型如何绕开文本生成直接完成决策
普通 LLM 碰到“从四个工具里选一个”这类任务,走的还是自回归解码:一个 Token 一个 Token 地吐出工具名或 JSON,程序再解析执行。模型干的是开放式文本生成,业务要的却是有限候选项之间的概率判断。
Gemini Decision 1 把输出目标换成了候选项打分。开发者事先定好问题、候选集合和判断标准,模型读完输入,直接给出各候选项的概率分布。全程一次前向计算搞定,不用逐 Token 生成答案,也没有输出 Token 费用。
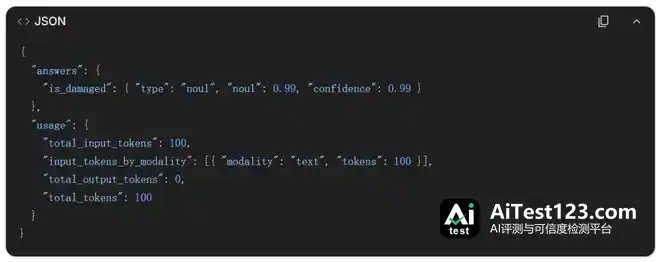
这与普通的 Structured Output 不是一回事。Structured Output 照样让模型生成文本,只是用 Schema 约束 JSON 的字段和格式;Gemini Decision 1 则围绕有限的候选空间直接评分,返回的结果本身就是程序能读的数据。
有个细节容易被忽略:不同判断类型返回的概率,含义并不一样。Noul 负责二元判断,返回某个条件成立的概率,范围是 0.01—0.99。问题本身有歧义时,开发者还能分别界定什么算 Yes、什么算 No,把判断标准不清带来的偏差压下去。

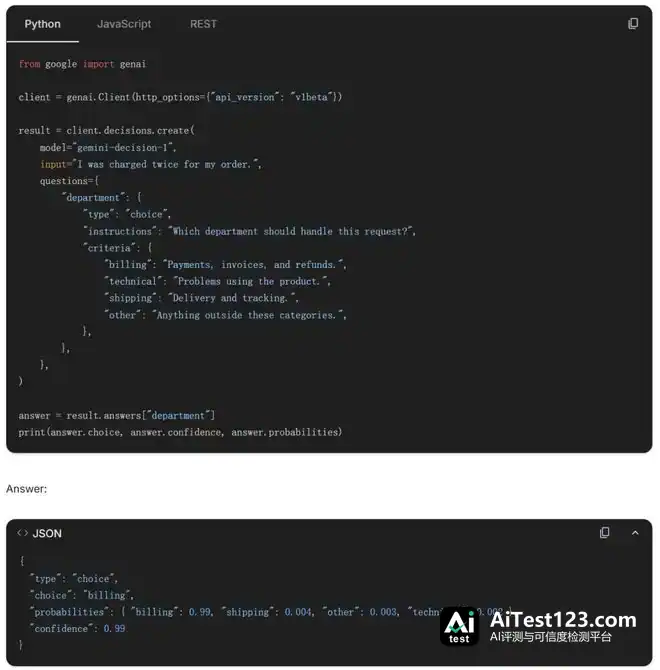
Choice 面向多分类,候选数量支持 2—255 个,返回胜出选项和各候选项的归一化概率,所有候选项概率之和为 1。工具路由、模型选择、任务分类都用得上它。
问题在于,概率分配始终发生在给定的候选集合内。哪怕所有选项都不符合输入,模型也会挑出一个相对匹配的结果。开发者得自己补一个 Other 选项,或者另设范围检查。
Score 的设计更有意思。它不直接给一个等级,而是先为有序评分标准中的每个等级分配概率,再加权算出分数。举个例子,把问题分成 0 级、1 级和 2 级,模型可能给出 0.1、0.7 和 0.2 的概率,最终评分就落在 1 和 2 之间。
这等于把离散分类延伸成了连续评分,程序做排序和阈值筛选都方便。不过加权会压掉概率分布里的信息:两个输入即便分数相同,背后的等级概率也可能差得很远。所以,要区分风险等级的任务,程序还得去读各等级的概率,不能只看最终评分。
三种类型搭起了 Gemini Decision 1 的输出体系。模型不再负责写一段给人看的答案,开发者要设计清楚的问题和候选标准,程序则把概率结果转成具体的执行条件。

02
1000 项问题在同一份输入上各自独立算完,靠的是什么
Gemini Decision 1 的请求由一份 Shared Input 加一组 Questions 组成。前者装文本、图像、音频、视频和 PDF,后者规定这一次要做的判断任务。每个问题可以选不同的判断类型和评分标准,一次请求最多塞进 1000 项问题。

拿设备巡检来说,系统拿到一段运行视频、一份维修记录、一段现场语音,要回答的是设备有没有异常、属于哪类异常、严重到什么程度、要不要派人去看。
开发者把三样材料放进同一份输入,再把上面几个问题分别定义出来:异常检测走 Noul,类别判断走 Choice,严重程度用 Score。模型读的是同一批材料,各项评分各算各的。

这套设计有两个技术细节。一是每项问题都有独立的评估路径。Google 文档写得很清楚,各问题只能读共享输入,读不到别的问题的答案。
加一项或删一项问题,其他问题的答案也不会跟着变。换句话说,并行评分不依赖前面问题的推理链,模型在同一轮前向计算里就能把多个独立判断做完。
二是共享输入只算一次钱。每项问题额外产生的费用,来自它自己的 instructions 和 criteria Token,整份材料不用重复计费。长文档批量审核、音视频检查、多维度内容评估这类场景,整体调用成本会受这种计费结构影响。

不过 1000 项问题不等于能把任意复杂的工作流硬塞进一个请求。假如问题 B 必须先拿到问题 A 的具体结果才能生成新候选项,两项任务就有前后依赖,开发者得先读出 A 的结果,再提交 B。
如果 B 的候选项已经定好,只是要在 A 不满足条件时把 B 的答案丢掉,两项判断就可以一起提交,由程序决定采不采用结果。
输入长度也得算进去。Gemini Decision 1 的上下文上限是 256K Token,这笔预算由共享材料和全部问题一起用,不是每项问题各拿 256K。问题一多,instructions 和 criteria 也要占上下文。

谷歌公布的延迟数据里,上下文不超过 16K Token 的测试条件下,问题从 1 项加到 100 项,模型计算延迟基本平稳,中位计算延迟 50—100 ms,端到端延迟 150—250 ms。要分清的是,API 支持 1000 项问题,公开的近乎平稳延迟测试只覆盖 1—100 项。
多模态输入还带一项工程取舍。图像和视频可以设 low、medium、high、ultra_high 等分辨率等级,视觉细节越丰富,输入成本也跟着变。

音频和 PDF 直接走各自的内容处理路径,开发者不用另外搭一套识别服务。谷歌也明确把 OCR 和音频转写相关开销算进模型输入计费体系,不另收输出 Token 费用。
模型内部的并行计算图,公开信息还不够还原。能确认的是,各问题共享同一份输入,在单次前向计算中独立评分。内部有没有用独立输出头、各问题的计算资源怎么分配,谷歌目前没有给出完整技术说明。
03
PK Jev:“五项领先”的背后
Gemini Decision 1 给每项答案配一个 confidence,取值 0—1,表示模型对当前结果正确性的估计。Noul 取 Yes 和 No 里概率较高的一方,Choice 对应胜出选项的概率,Score 对应概率较高的等级。程序据此按判断可靠程度设不同的执行门槛。
这就牵涉概率校准。ECE(Expected Calibration Error,期望校准误差)衡量的是模型给出的概率与实际正确比例之间的偏差。谷歌公布 Gemini Decision 1 的 ECE 为 0.0250,Jev 1.14 为 0.0494。
产品落地上,谷歌已经在 Gemini Notebook 里用 Decisions API 做模型路由,按请求复杂程度挑模型档位和推理等级,日常请求延迟据称降低了 40%。
Google Search 拿它做 MCP 工具的安全检查,Stitch 用它加快交互设计过程中的操作选择。和 TypeSafe Jev 比,两款模型技术方向相近,公开信息呈现的侧重不同。
TypeSafe 已经披露,Jev 使用专门的模型架构、Parallel Sampler,以及 RLCD(Reinforcement Learning for Calibrated Decisions)训练方法。Jev 1.14 增加了图像输入、Box 判断类型和长上下文能力,不过相关功能发布时仍放在实验性配置中。
Gemini Decision 1 则依托 Gemini 原生多模态架构,把音频、视频、PDF 纳入输入范围,提供 256K 上下文和 1000 项问题请求能力。谷歌尚未披露与 TypeSafe 类似的训练方案,两者的内部训练路线暂时没法直接比较。
性能上,谷歌公布的 7 项共享基准中,Gemini Decision 1 有 5 项超过 Jev 1.14,Jev 则在 When2Call 工具调用和 Mind2Web 多模态上保持领先。When2Call 是 Agent 工具选择的核心场景,Jev 在这个指标上反超,说明 Google 的优势并非无差别覆盖。
第三方独立评测机构 Artificial Analysis 的 Decision Index v2.1 榜单中,Gemini Decision 1 综合分 65.98,略低于 Jev 的 66.23,远低于榜首 Drex Max v1.1 的 72.62。单任务延迟 211 ms,高于 Jev 的 92 ms;价格方面,Gemini 每 100 万输入 Token 收费 0.10 美元,Jev 为 0.042 美元。
换个角度看,Google 拿多模态和批量处理能力换来了价格上的溢价,可“更强”这一点,在第三方统一任务套件上还没变成“更优”。校准误差上的优势确实存在,不过校准领先跟综合决策质量领先,终究是两码事。
04
Agent 的决策层,眼下正演变成一个独立的战场。Gemini Decision 1 做的事,是把原先散落在 Agent 工作流里的某一类任务,正式变成一项独立的模型调用能力。这背后牵涉的不只是打分速度,还包括候选空间怎么定义、共享输入如何复用、问题之间怎么隔离、概率校准以及程序控制之间的相互配合。
复杂推理、规划和内容生成,还是交给通用 LLM;至于那些标准能够提前定下来的判断任务,则由 Decision Model 接手。开发者在安排调用顺序时,得看任务之间的依赖关系,自动执行的范围则要依据概率表现来定。
这个品类是 Jev 在 9 月点燃的,Google 到 11 月用多模态和批量能力加了注。这条路能不能走出长期优势,还得看模型在复杂输入、任务分布变化以及真实业务环境里稳不稳。Google 一入场,专用决策模型就进入了更大规模的产品竞争,Agent 的工程设计也会从单靠生成模型,转向更细致的模型分工。
参考链接:https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/













