

北大校友出题考AI蛋白质序列:Claude答上,GPT和Gemini落败
11月19日晚 Anthropic 在纳斯达克敲钟,代码 ANT,发行价 83 美元。上周它刚发了 Claude Fable 5.2,这几天不管打开哪个群,聊的都是它写代码又强了多少,这个模型的定价贵不贵。 APPSO 是昨天在 Hacker News 首页刷到这篇博客的。它不聊代码,也不聊股价,标题就一句话,「Cla
11月19日晚, Anthropic 登陆纳斯达克,股票代码 ANT,发行价 83 美元。上周它才推出 Claude Fable 5.2,这几天随便点开哪个群,大家议论的都是这模型写代码又长进了多少、定价算不算贵。
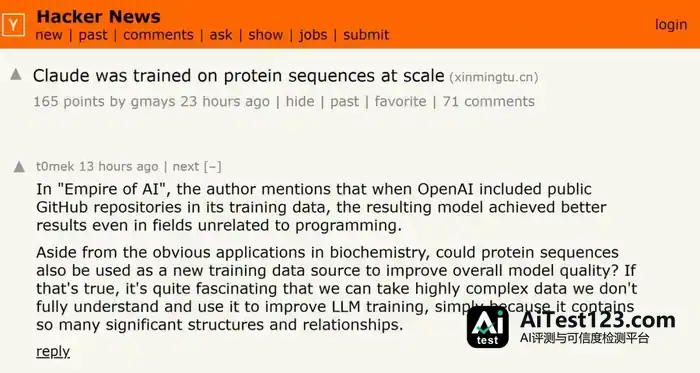
APPSO 昨天在 Hacker News 首页看到了这篇博客。内容跟代码无关,也跟股价无关,标题只有一句「 Claude was trained on protein sequences at scale」,意思是 Claude 训练时大量接触过蛋白质序列。
那篇帖子 165 分、71 条评论,当天首页上不算最火。不过点进去读完,我们觉得它比上市这件事更有看头。
作者 Xinming Tu 的经历挺特别:本科就读北大,生物和计算机两个方向一起学,之后到华盛顿大学攻读计算机博士,今年已是最后一年。
他日常干的活就是给 AI 出题,题目都落在生物领域。搭档 Leo Tianlai Chen 则在哈佛医学院。
他们究竟做了什么,APPSO 一句话大致能说清。
从数据库里挑出一批根本没人研究过的蛋白质,只给出开头,让 22 个模型接着往下写。
结果接得上的,只有 Claude。

一道绕开论文的题,考出了什么?
事情的起点是  GPT 这类模型近来在蛋白质题目上得分不低。
有人让 GPT-6 Astra 给名为 SOD1 的蛋白质变体排序,成绩跟专做蛋白质的模型 ESM-2 接近。Xinming Tu 想弄清这个分数从哪来:模型是真读过 UniProt 这类蛋白质数据库,还是只读过论文里那些讲蛋白质的文字。
蛋白质由 20 种氨基酸串成一条长链,每种氨基酸对应一个字母,写出来就是一长串字母,像 MRSGGQPLHPQ 这样一路排下去,短的有一百多个,长的能到好几百个。
拿知名蛋白质出题测不出东西。绿色荧光蛋白 GFP 的序列被无数论文印过,他在博客里写道,大多数前沿模型都能把它背下来。

所以他专门挑没人写过的,从细菌和古菌中选了 668 条,分属 167 个功能都还不清楚的蛋白家族。这些家族没有一个解析过结构,相关论文最多 3 篇,其中 128 个家族连一篇都没有。

出题方式是这样的:把一条蛋白质从中间截断,前半段交给模型,再附一句话,「预测它怎么往下接。只回复接下来的 10 个氨基酸,用单字母代码写在一行里,别的都不要。」评判只看第一个字母对不对。每条蛋白质切 5 个位置,合计 3340 道题。
只做到这一步还不够。
20 种氨基酸本身出现频率就有高有低,模型就算完全没见过这条蛋白质,按前面字母的比例去蒙,也能撞对一些。
于是同一条蛋白质他再问一次,这回把字母顺序彻底打乱。字母一个不少,顺序没了,纯靠蒙的模型两次得分理应持平。
两次测试的差值,才反映它真正认识这条序列的部分。

先看 Claude。Fable 5.2 拿到真序列,下一个字母能猜对 54%,刚过一半;同一条序列打乱后再给它,只剩 9%。Opus 5.5 差一些,真序列 34.9%,打乱后 7.5%。
20 种氨基酸里纯蒙一个,命中率是 5%。打乱后猜对的 9% 和 7.5%,比纯蒙高不了多少。
可真序列能猜对 54%,性质就完全不同了。
博客把两次的差当作模型对序列的了解程度:Fable 5.2 是 45.1 个百分点,Opus 5.5 是 27.4。后面所有比较用的都是这个差值。
它还不只是猜对下一个字母。题目要求一口气往下写 10 个,Fable 5.2 有 88 回把这 10 个字母全写对了。换成打乱的序列,这种情况一次都没出现。
Fable 5.2 能答对这类题,靠的不是运气。它确实掌握了这套规律。
他把 22 个模型在图里从上往下一字排开,除 Claude 外的点几乎全贴在零附近。GPT-6.2 Sol 为 2.4,已算这批模型里的高值, Gemini 4 Carbon 只有 0.9。
国产模型方面,Qwen 3.8 最高,为 1.9;DeepSeek V4.1 Flash 是 1.4;Kimi 与 GLM 均为 1.2。

通用模型反超生物专用 AI
有意思的是,Claude 最初同样不会预测蛋白质序列。
早几年 Opus 4.5 和 4.6 的差值分别是 1.9 和 0.9,跟其他模型基本没拉开距离。
到了 Opus 4.7 这一代,情况看起来有了转折,指标一下跳到 8.9,随后一路快速上扬。
再往后,Fable 5.1 达到 14.9,Opus 5.5 直接翻倍冲到 27.4,Fable 5.2 又几乎翻了一倍,来到 45.1。
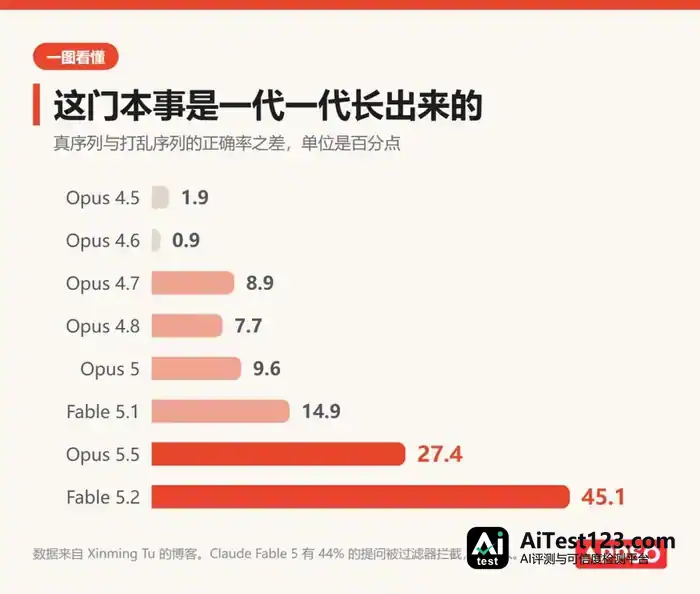
若只是偶然读到过若干序列,不会出现这种逐级抬升的走势。APPSO 更倾向的解释是,Anthropic 每推一代新模型,都在训练数据里多掺了一些蛋白质相关数据。
拿来跟 Claude 对照的,还有生物领域自己的工具。
做蛋白质研究的人常用一种叫蛋白质语言模型的东西,它只拿蛋白质序列训练,完全不会说人话。
Xinming Tu 挑了自己能跑起来的最强两款。ProGen3-3B 的差值是 32.5;ProtGPT3-10B 有 100 亿参数,是公开模型里最大的,差值为 27.7。Opus 5.5 与后者几乎持平,Fable 5.2 则比这两款都高出十几个百分点。

Claude 平日帮人写软件、做科研,顺带把蛋白质序列这门课也修了,分数还更高。
专用模型原本靠的就是只读序列这一招,如今通用模型也把这部分能力吞了进去……
这个结果还能有别的解释吗?博主逐条做了排查。
会不会是从论文里看来的?那 128 个在任何论文中都没出现过的家族,Fable 5.2 的差值是 45.9,比全部家族的 45.1 还略高。
会不会是现场推理出来的?接口记录显示,Fable 5.2 仅 9% 的回答动用了思考,未思考的那些正确率为 54.7%,思考过的反倒只有 48.2%。
数据库里还有一条线索。同一类蛋白质被收录得越多,Claude 接得就越准。只收了几十条的小家族,它接得平平。收到三百条左右,Fable 5.2 的成绩基本见顶,再多也涨不上去了。只读序列的专用模型也遵循同样的规律。GPT 和 Gemini 则不分家族大小,始终贴着零。

Leo Tianlai Chen 给出一组很有洞察力的实验数据,APPSO 认为这组结果相当有价值。
他找了 56 条今年 8 月 2 日到 27 日才首次公开的蛋白质,它们与此前数据库里任何一条的相似度都不到一半。
在这批新蛋白质上,Fable 5.2 的差值是 22.1,两款专用模型分别为 12.0 和 6.7,GPT-6.2 Sol 是 −0.4。
作者自己也承认,这组数据有两处短板。样本太少,只有 56 条。另外,他们并不确定 Claude 的训练数据截止在哪一天,7 月 1 日只是估算。若实际截止更晚,这批 8 月才公开的蛋白质就不能算它没见过。
Xinming Tu 说,「这需要大量的序列数据,不是几个例子,蛋白质序列在它们的训练里占了不小的一块。」

对 AI 来说,蛋白质也是一种语言
Fable 5.2 的官方介绍页,APPSO 从头翻到尾,训练数据里究竟有什么,一个字都没提。所以上面那些结论,说到底还是两位研究者从模型表现反推出来的。
能查到的,是 Anthropic 自己公开披露的动作。9月17日它发过一篇文章,称Claude用不到四周时间改写了30多个开源生物模型,平均提速大约4倍,蛋白质语言模型就在这30多个之列。

跑分栏里有一项De novo binder design。说白点,就是给模型24小时,让它自行设计出一个能结合到指定目标上的蛋白质。
再往下拉到Safeguards一节,上面写着Fable 5.2针对网络安全和生物两类问题都设了防护,被标记的提问会转交给能力弱一些的模型作答。

Xinming Tu 自己就被这套防护拦过。测 Claude Fable 5 那会儿,44% 的题被过滤器挡下,系统给出的理由是网络攻击内容,可他发过去的不过是一串氨基酸字母。
Fable 5.1 被挡的比例还有 2.5%,到 Fable 5.2 已经一题都没挡。
Hacker News 上有人跟帖抱怨:「连我自己的 DNA 都没法分析,一半的时候会触发 Opus 5.5 的拦截。」
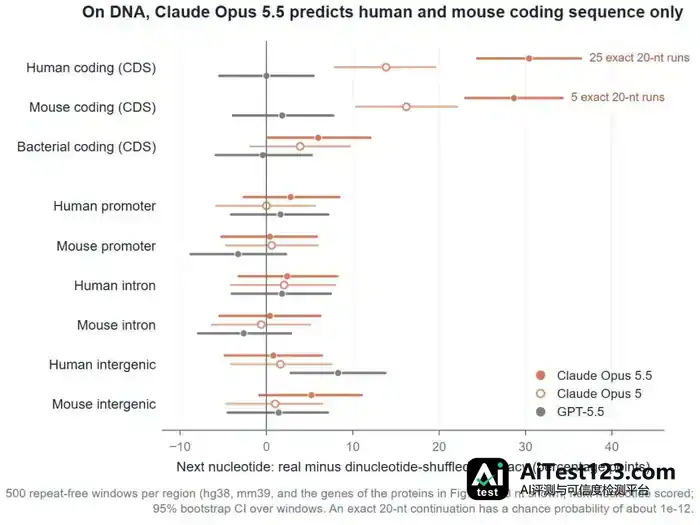
DNA 也有人试过。人和小鼠基因里负责编码蛋白质的片段,Opus 5.5 能接着往下写,500 个片段中有 25 次把后面 20 个碱基一个不差地写了出来。瞎猜碰上一次的概率,大约是一万亿分之一。
但一出了编码区,换到基因组其他位置,它就接不下去了。博客里的说法是,它学的是蛋白质,不是基因组。
先把大门锁上,完整能力只发给验过身份的机构。这个先后顺序,是不是说明 Anthropic 对自己模型在生物上走到了哪一步心里有数?
博客结尾留了一个他们还没测的问题。专门的蛋白质模型不光会接字母,在它上面加个小模块就能算出蛋白质的三维结构,ESMFold 就是这么来的。
Claude 如今背得出蛋白质的字,那它看不看得懂蛋白质的形状?
这个问题,Anthropic 其实已经在接招了。
今年 9 月,它宣布 Claude 在一种专门感染细菌的病毒里翻出了一段不寻常的 DNA。这段 DNA 的排列方式很像大名鼎鼎的基因编辑工具 CRISPR,也就是常说的「基因剪刀」。公司生命科学负责人 Eric Kauderer-Abrams 后来对《科学美国人》表示,这段东西到底起什么作用,他们自己也还不确定。
再往前两年,Dario Amodei 写过一篇长文,说 AI 有机会把生物学五十到一百年的进展压缩到五到十年。那会儿听起来只像一句愿景。
这么看,蛋白质对 Claude 来说压根不是顺手学的一门选修课,而是必修课。

大家还在比谁的模型代码写得好,Anthropic 已经悄悄把蛋白质当成一门语言在教了。












