

miniTE报告:原生NVFP4如何稳定高效训练RL
InfiX.ai、Slime与SGLang团队分析了原生NVFP4在大模型RL中后期失稳的原因,覆盖量化、激活缩放、KV cache与执行路径差异,并提出TRIAGE与miniTE两条路线,在8×B300上实现约1.33–1.37倍学习器更新加速。
InfiX.ai、Slime 与 SGLang 团队发布 miniTE Technical Report,聚焦一个现实问题:在大语言模型强化学习(RL)中直接使用原生 NVFP4 计算,虽然能带来潜在性能收益,但训练后期可能出现不稳定。报告从量化误差、激活缩放、KV cache 精度、训练与采样框架执行路径差异等角度进行诊断,并提出算法侧的 TRIAGE 与工程侧的 miniTE。
核心结论是:低精度算子本身并不足以保证稳定学习。即便训练端和采样端都使用 NVFP4,仍可能存在显著的 log-probability mismatch;而更低的 mismatch 与更快的局部计算,也不等于一定能达到 BF16 级别的最终学习效果。
TL;DR:问题、方案与收益
- 问题与诊断:原生 NVFP4 RL 在训练后期可能失稳。团队系统检查了量化格式、激活缩放、KV cache、执行路径等因素,并分析这些误差如何影响策略更新。
- 算法与工程:TRIAGE 通过更新方向控制残余 mismatch 风险;miniTE 则减少数值执行差异,并优化低精度计算路径。报告将二者分别评估。
- 性能收益:在 8×B300 上,miniTE 搭配 BF16 backward 时,完整 learner update 相比 BF16 达到约 1.33–1.37× 加速;另一个固定输出 serving 测试达到约 1.64× 吞吐。
- 限制与开放问题:在报告的 online RL 实验中,权重转换与同步开销抵消了采样收益;实用 miniTE checkpoint 在五任务平均上仍低于 BF16。算子对齐与较小 gap 并不保证 BF16 级学习效果,误差容忍度、更新规则和最终结果仍需进一步研究。
为什么原生NVFP4 RL会在后期失稳?
大模型 RL 通常反复执行 rollout、策略概率重算、梯度更新与权重同步。随着回答长度增加,生成和训练都需要处理大量 token,低精度计算因此变得很有吸引力。Blackwell 架构支持原生 NVFP4 matrix multiplication,此前预训练工作也已证明,在合适的 scaling、mixed precision 与 rounding 策略下,低比特训练可行。
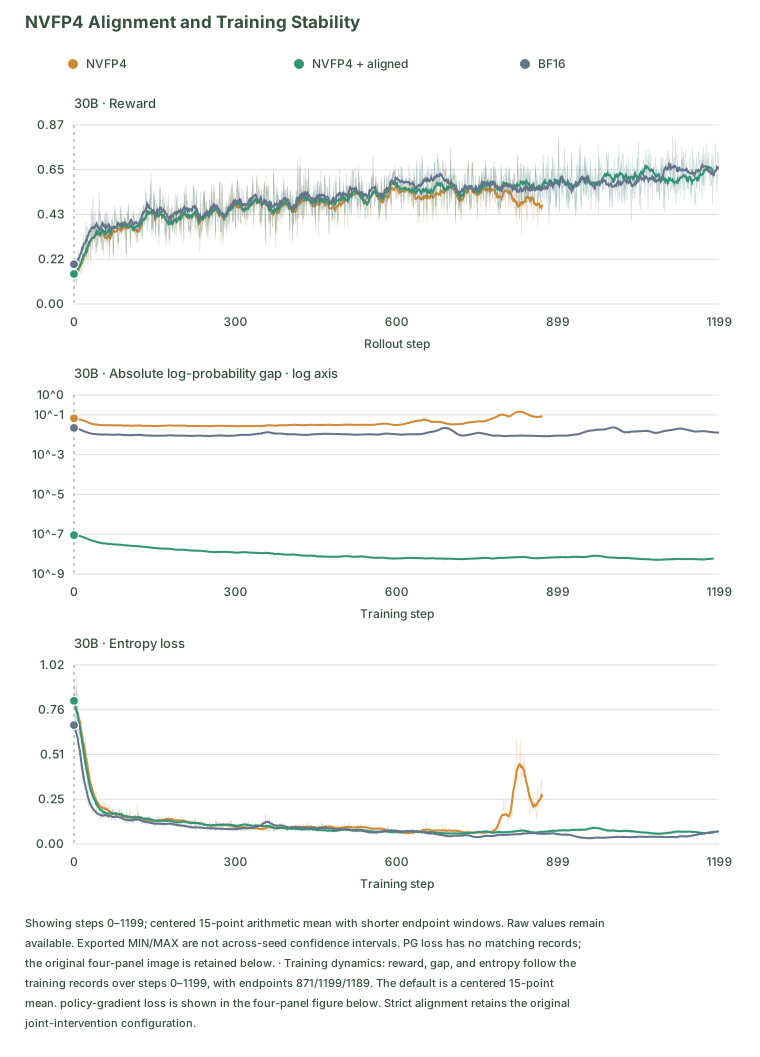
但 RL 闭环比预训练更复杂:训练框架与推理框架必须在数值实现上保持足够一致。团队早期的 NVFP4 运行中,reward 一开始正常上升,但随后出现异常 entropy、训练端与采样端 log-probability gap 扩大、reward 下滑等现象。单独替换一个量化算子,或确认两端都使用 NVFP4,并不能彻底解决问题。
训练过程中逐步暴露的失败模式
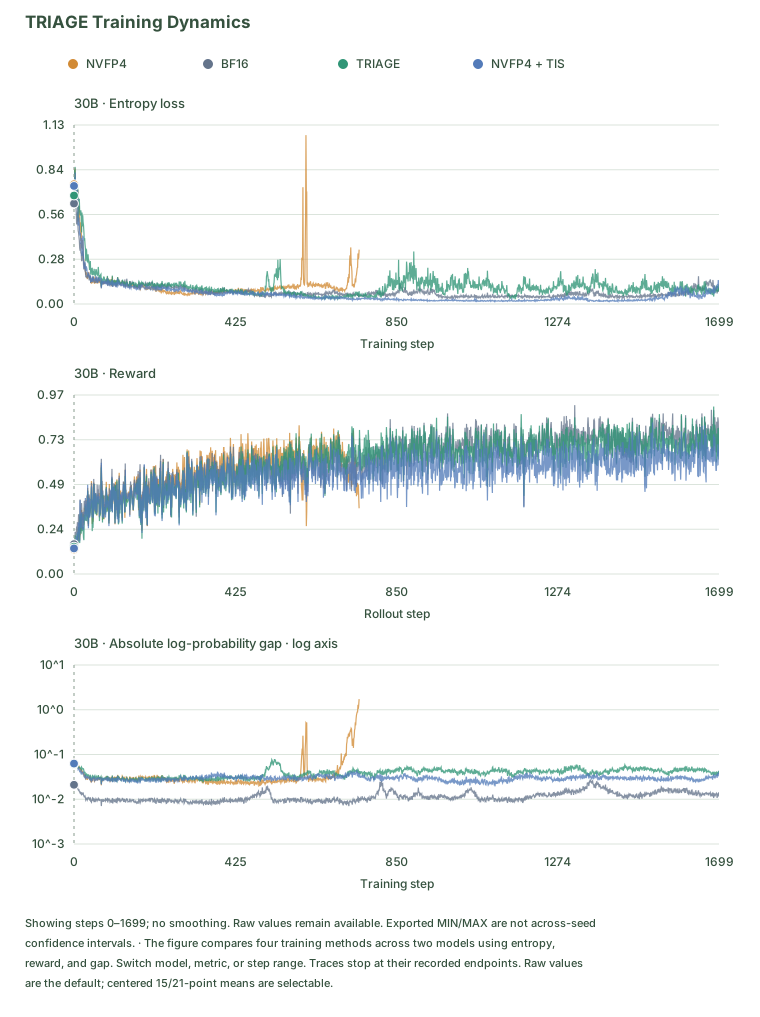
团队在 DAPO 数学任务上使用 Qwen3-4B 与 Qwen3-30B-A3B 进行 GRPO 训练。早期原生 NVFP4 实验显示,模型先正常提升,随后训练恶化。在 TRIAGE 分析的轨迹中,4B 模型约在 300 steps 后开始不稳定,而 30B 模型的 mismatch 约在 700 steps 后快速增长。这意味着,仅看初始误差或短期 loss 曲线不足以判断 NVFP4 RL 是否稳定。
报告跟踪 reward、entropy、训练—采样 log-probability gap 以及下游任务得分。对 response i 中 token t,定义 δ_i,t = log π_l(y_i,t | x_i, y_i,<t) - log π_s(y_i,t | x_i, y_i,<t)。其中 π_l 是 learner 给出的条件概率,π_s 是 sampler 给出的条件概率。负 gap 表示 learner 给出的概率更低,正 gap 表示 learner 概率更高;mean absolute gap 则统计 token 级 |δ_i,t| 的平均值。
NVFP4格式、两级缩放与转换误差
报告区分了三个概念:量化误差、checkpoint 转换误差,以及训练端与采样端执行不一致造成的 mismatch。量化误差是低精度计算相对于高精度参考的偏差;training–sampling mismatch 则比较 learner 与 sampler 的真实执行结果;checkpoint 转换和 inference backend 适配还会引入额外误差。
NVFP4 使用 E2M1 表示量化值:E 与 M 分别代表 exponent 和 mantissa 的 bit 数,另有 1 个 sign bit。解码时,q 是 E2M1 数值,s_b 是每 16 个元素共享的 E4M3 block scale,s_g 是 FP32 outer scale。outer scale 可按 per tensor、per expert 或 per row 计算。
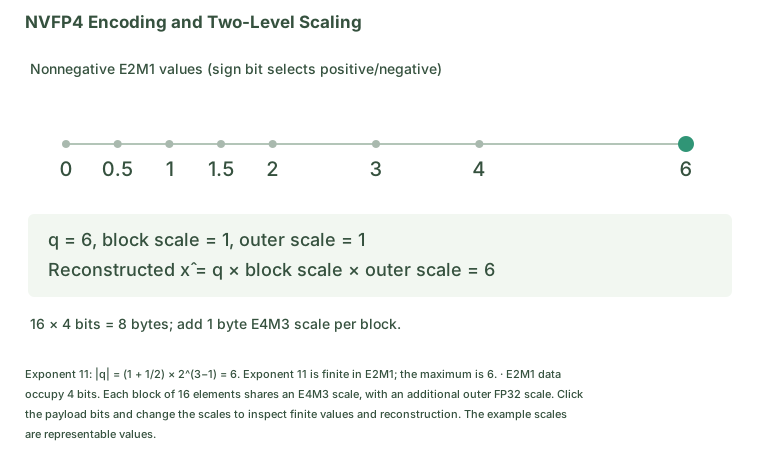
一个 Qwen3-0.6B NVFP4 预训练 checkpoint 曾因 fused QKV 结构处理不正确而出现严重性能下降。修复后,Lambda 平均准确率分别为:BF16 约 0.3043,一维量化约 0.3056,二维 block-scaled quantization 约 0.3109。这说明,在把失败归因于 FP4 格式之前,必须先检查模型结构适配与转换流程。
在 Qwen3-4B 上,online quantization 相比 BF16 使 Lambda-base 与 Math23K 分数分别下降 0.0355 与 0.047;offline conversion 又额外带来 0.0089 与 0.019 的下降。这些实验帮助团队拆分格式/数值路径损失与转换/scale 处理损失。
即使同为NVFP4,两端仍可能明显不一致
在早期配置中,训练端与采样端的 mean absolute log-probability gap 如下:
| Training / sampling precision | Dense | MoE |
|---|---|---|
| BF16 / BF16 | 0.0110 | 0.0172 |
| NVFP4 / NVFP4 | 0.1142 | 0.0668 |
| NVFP4 / BF16 | 0.1376 | 0.0621 |
| BF16 / NVFP4 | 0.1690 | 0.0747 |
其中 dense 模型为 Qwen3-4B,MoE 模型为 Qwen3-30B-A3B。值得注意的是,将 offline ModelOpt conversion 替换为 online quantization 后,dense 模型 gap 仍约为 0.1142;即便两端使用相同 quantization/GEMM operators,仍存在残余差异。因此,问题不只在权重量化,还涉及输入组织、scale 计算与量化周边操作。
激活精度、缩放粒度与KV Cache
在固定 NVFP4 权重后,提高 activation precision 可以测试激活量化的影响。报告用 W 和 A 分别表示 weights 与 activations 的 bit width,例如 W4A16 表示 4-bit weights 与 16-bit activations。
| Weights / activations | Dense gap | MoE gap |
|---|---|---|
| W4A16 | 0.0139 | 0.0166 |
| W4A8, MXFP8 activations | 0.0363 | 0.0227 |
| W4A4, NVFP4 activations | 0.0903 | 0.0445 |
W4A16 将 gap 拉近到 BF16 参考水平,说明在该配置下 activation quantization 是关键因素。另一个固定配置中,将 KV cache 从 FP8 改为 BF16,可将 gap 从 0.0721 降至 0.0583。这表明 sampler state precision 同样影响跨框架一致性。
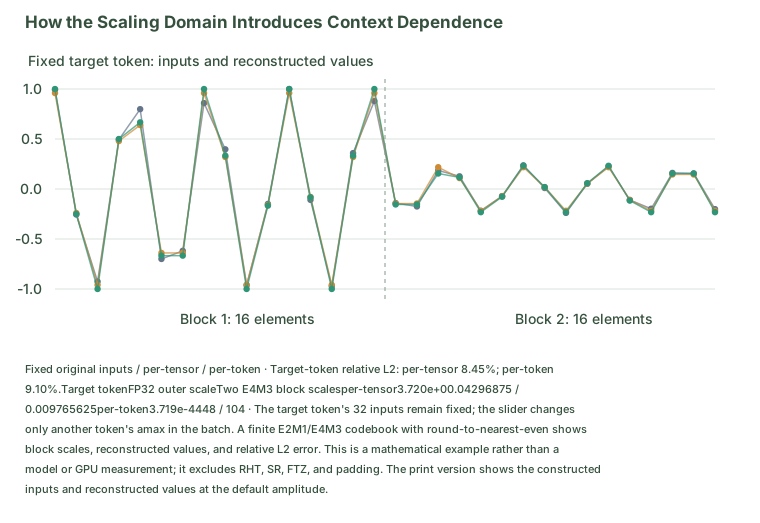
缩放域也会引入上下文依赖。sampler decoding 通常一次处理当前 token,而 learner 往往一次处理完整 response。如果 activation outer scale 使用 tensor-wide amax,那么 sampler 与 learner 看到的 token 集合不同,scale 也可能不同,从而使同一个 token 在两个执行路径中得到不同的量化结果。
TRIAGE:从更新方向控制残余mismatch风险
即便工程上尽量对齐,低精度训练仍可能留下不可避免的 mismatch。TRIAGE 的思路不是假设所有误差都能被消除,而是根据 mismatch 与 update direction,在高风险片段中调整更新方式,降低残余误差对学习过程的破坏。
报告强调,mismatch 是否危险取决于它与策略更新方向的关系。某些情况下,数值误差只是带来轻微偏移;但当误差方向与更新方向叠加时,可能放大错误策略概率,导致 entropy 异常、reward 下滑或训练后期崩溃。
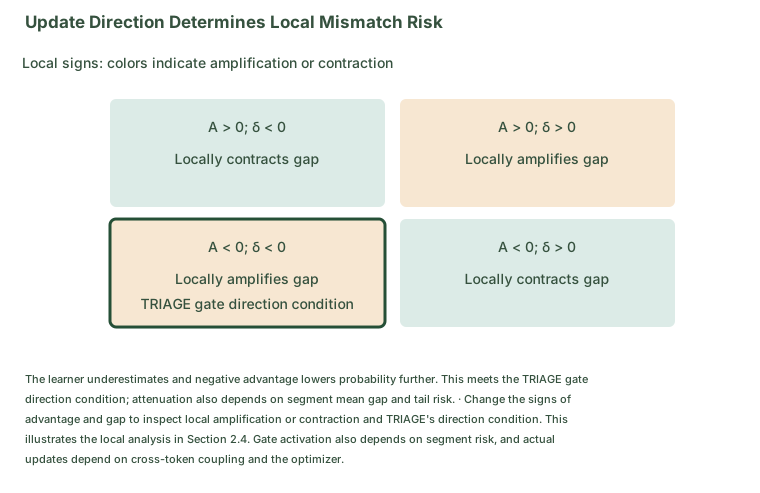

在训练动态上,TRIAGE 通过识别并处理高风险区域,帮助控制 negative tails 与局部不稳定,从而改善稳定性和任务表现。报告将 TRIAGE 作为算法侧方案,与 miniTE 的系统工程优化分开评估。
miniTE:把量化策略、线性层与计算后端解耦
在大型训练框架中,改变 scale granularity 或 GEMM backend 往往会牵动 layer wrapper、grouped layout、communication 与 autograd。miniTE 的目标,是把 quantization policy、linear layers 与 compute backends 分离,让开发者可以在现有训练流程中替换某条计算路径,再分别评估数值正确性、学习行为与运行成本。
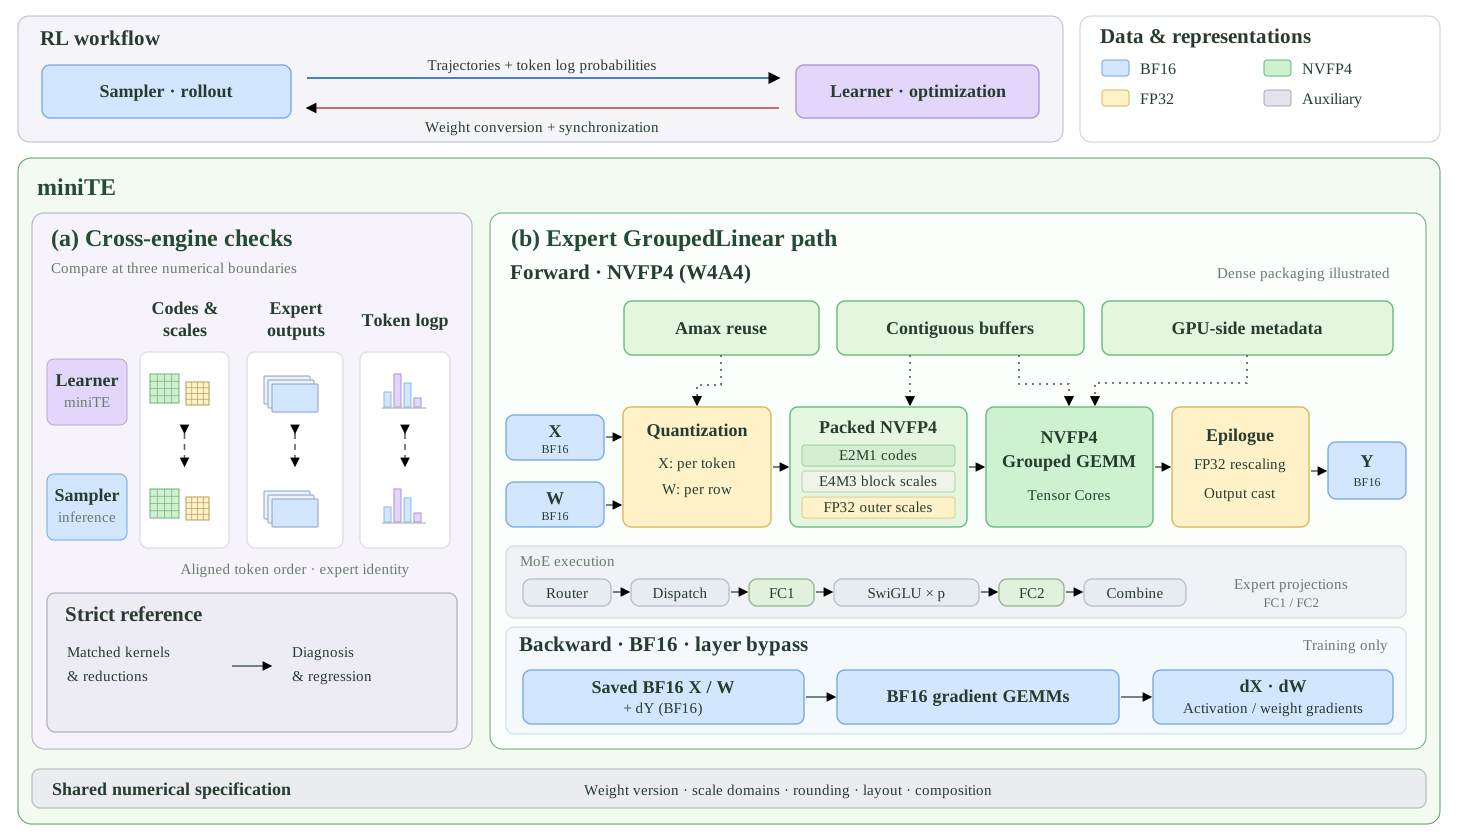
miniTE 提供 precision configuration、alignment checks 与 performance analysis,帮助排查 learner 与 sampler 在低精度路径上的执行差异。它并不是单个算子替换,而是一套围绕 NVFP4 训练与推理路径对齐的工程框架。

Transformer Engine路径优化:减少准备与调度开销
报告还介绍了与 Transformer Engine per-token NVFP4 path 相关的联合工作。优化手段包括 contiguous layouts、device-side metadata、amax reuse、grouped GEMM 以及 fusion,以降低低精度执行中的数据准备与 kernel dispatch 开销。
这些优化的重点并非只追求算子 microbenchmark 的峰值,而是让 low-precision computation 在完整 learner update 中转化为实际收益。尤其是在 RL 中,采样、训练、权重同步与框架切换都会影响端到端收益。

实验结果:速度提升明确,但学习质量仍有差距
系统性能方面,在 8×B300 上,miniTE 的两条路径在 BF16 backward 配置下,相比 BF16 完整 learner update 达到约 1.33–1.37× 的 paired speedup。另一个固定输出 serving 测试中,吞吐达到约 1.64× BF16。
但报告也明确提醒:这些 learning results 与 system results 来自不同配置。较低 mismatch 与更快局部计算,并不能直接证明已经达到 BF16 级学习,也不能证明端到端 RL 一定加速。在报告的 online RL run 中,weight conversion 与 synchronization 开销抵消了 sampling gains;实际 miniTE checkpoint 在五任务平均上仍低于 BF16。

结论:NVFP4 RL的难点不只是低比特算子
这份报告的价值在于,它把原生 NVFP4 RL 的问题从“能不能跑低精度矩阵乘”推进到“低精度执行如何影响策略学习”。RL 训练中,learner 与 sampler 的概率一致性、activation scaling domain、KV cache precision、checkpoint conversion、inference adaptation 与 update rule 都可能成为不稳定来源。
TRIAGE 从算法层面处理残余 mismatch 风险,miniTE 从工程层面减少可避免的数值差异并提升低精度执行效率。二者共同说明:要让 NVFP4 在 RL 中真正可用,需要同时关注数值对齐、误差容忍、更新规则和最终任务表现。当前结果展示了可观的性能潜力,但距离稳定复现 BF16 级学习效果,仍有不少开放问题需要继续研究。











