姚顺雨与混元团队Reddit开AMA:Hy小模型已列入路线图
Hy小模型已经在路线图上,面向24GB显存的模型也有计划。
今天凌晨,姚顺雨和腾讯混元团队现身Reddit社区,围绕刚发布的Hy4与Hy4 flash办了一场AMA。
Hy小模型已经排进路线图,面向24GB显存的版本同样在计划之中。
AMA即「Ask Me Anything」,意思是「有什么想问的,尽管问」。网友在评论区发问,混元团队成员直接回帖作答。
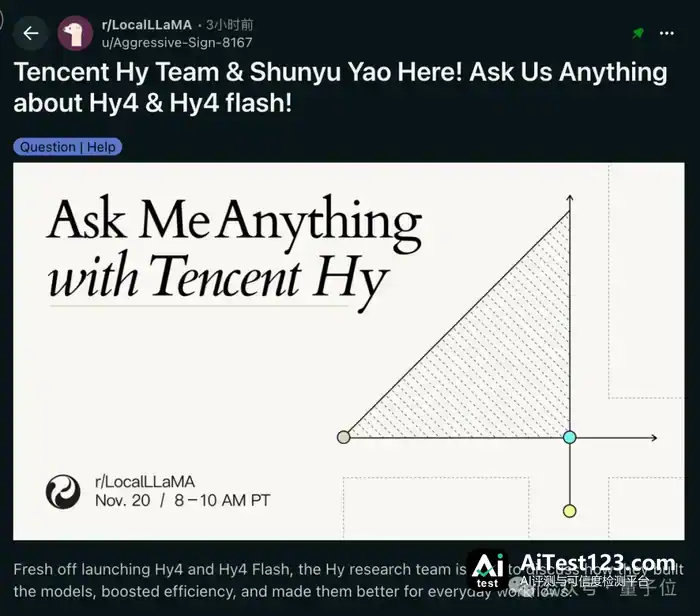
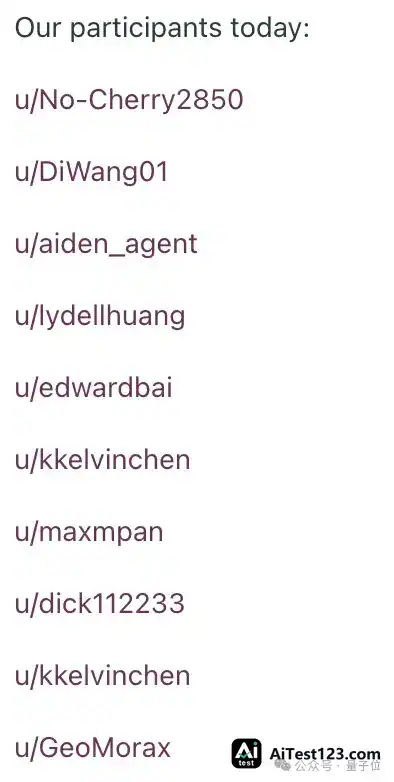
参与名单上只挂了Reddit账号,哪个马甲是姚顺雨,目前还没对上号……
这场AMA的主角,是混元本月接连发布的两款模型。
11月4日发布的Hy4是旗舰,能理解文本、图像和视频,适合长程软件工程这类需要多步推理、反复调用工具的复杂任务。
11月16日发布的Hy4 flash,主打日常办公的速度和成本。它支持图文输入和最长100万Token的上下文,每个Token激活约120亿参数。
Hy4和Hy4 flash都已接入腾讯WorkBuddy。混元团队还把WorkBuddy里的修表、改文档、做PPT等典型任务纳入了内部评测WorkIndex,按这套评测测算,Hy4 flash的平均单任务成本约为旗舰Hy4的1/20。
两款模型的权重都已公开。到了AMA,有网友直接报出自己的电脑配置:96GB显存、128GB内存,能跑Flash吗?
团队说能跑,主要权重留在GPU上,部分专家层和Engram查表模块可以挪到系统内存。
也有人问llama.cpp,团队说适配正在做。
聊到研发,团队还透露了不少训练背后的秘诀。
Flash的激活参数还能不能减?他们拿做过的MoE稀疏度实验解释取舍。
让Agent自己解题,训练时遇到过什么麻烦?有时它会直接上网找现成答案,跳过解题过程。
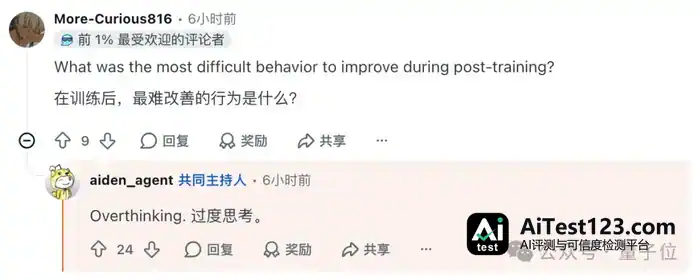
有网友追问,后训练阶段哪类行为最难改,团队给出的回答只有“Overthinking”,也就是过度思考。旗舰 Hy4 的推理链有时候拉得比较长。到了 Flash 上,团队的做法是先拿旗舰模型做蒸馏,再用强化学习把推理链缩短。
从模型怎么训,到开发者能不能把它跑起来,这场AMA聊了不少平时在模型卡上只有一行、到了真用时却绕不开的问题。
以下是AMA问答节选,按主题编排,中文译文有删节。
Enjoy~
Hy4为什么「想太久」,Flash又是怎么训练的?
网友:Hy4 正式版和 Hy4 preview 一样,偶尔也会想太久。这到底是强化学习的奖励设计造成的,还是训练数据分布的问题?模型能不能自己学会该在什么时候停?
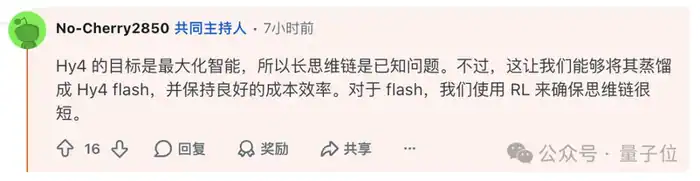
混元团队:Hy4 追求的是尽可能把智能水平做高,推理链偏长这一点我们清楚。可以把 Hy4 蒸馏成成本更低的 Hy4 flash,再在 Flash 上用强化学习把推理链压短。
网友:后训练阶段,最难改善的是哪种模型行为?
混元团队:过度思考。
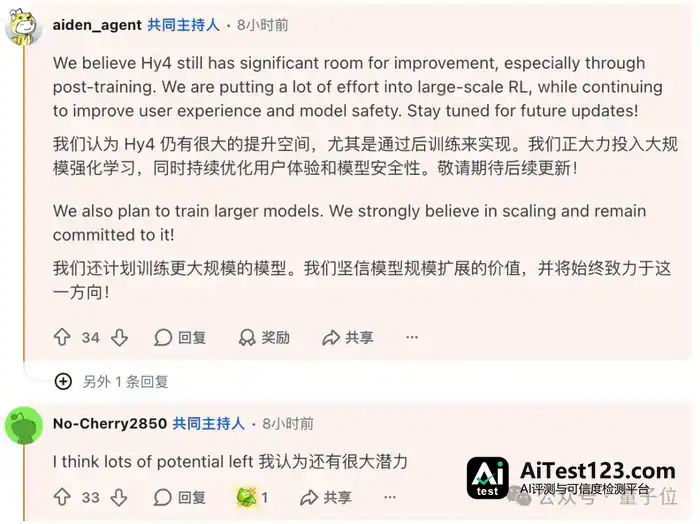
网友提问:Hy4的参数规模还能往上走多少?将来要做出更强的模型,是不是非得继续堆参数?
混元团队回应:Hy4的提升余地其实还很大,后训练尤其明显。团队正在投入大规模强化学习,同时继续打磨用户体验与模型安全性。更大规模的模型训练也已列入计划。
有网友问:拿Hy4和Hy4 flash去跑长程Agent任务,多轮强化学习中最难啃的骨头是什么?
混元团队答:训练环境的设计一旦有漏洞,模型就会找空子刷奖励,这是最麻烦的地方。举个例子,得堵住Agent直接上网搜现成答案的路子,逼它自己把任务完成。
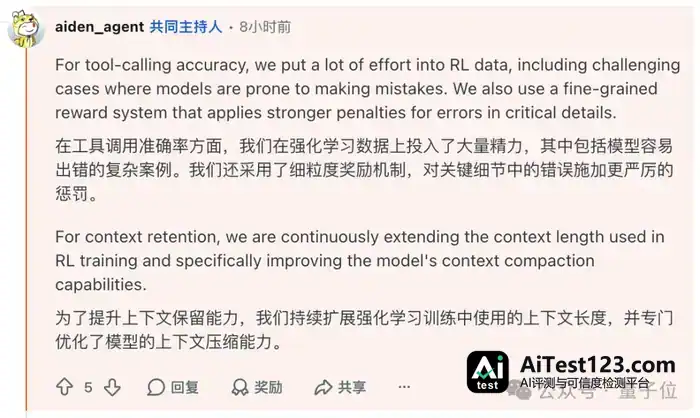
网友接着问:命令行任务里,模型写错一个参数,命令就可能跑不通。工具调用的准确率怎么提?长任务中前文信息又怎么记住?
混元团队表示:强化学习数据里已经掺入了模型常犯错的难例,奖励机制也拆得更细,关键细节写错扣分更狠。长任务方面,团队一边持续拉长强化学习所用的上下文,一边增强模型压缩上下文、留住关键信息的能力。
网友问:姚顺雨常讲,挑训练数据得有判断力。一批数据到底好不好,你们怎么看?
混元团队答:数据质量要拆成很多维度看,领域不同、任务不同,标准也不一样。不管是请人类专家还是用智能体,设计和清洗数据都很费功夫。到头来还得靠实验说话——这批数据能不能带来提升,跑过才知道。
网友关心:HyRA 2.0实验里,Hy4带来的增益主要出自哪里?有没有发现新的架构改进或数据配比?
混元团队解释:这一轮提升大头在底层吞吐优化。模型要想更深地参与研发,判断训练方案的能力还得往上提。用AI做AI研发,本身就是周期长、难点密布的事。
网友追问:Hy4和HyRA 2.0已经帮着改进了训练基础设施,也训出了更好的小模型。下一步会做什么实验,验证这一轮训出的模型在下一轮更擅长研发?
混元团队只回了一句:HyRA 3.0正在做,敬请期待。
网友问:要是让Hy4自己跑,它现在能靠递归自我改进造出下一代模型吗?这种能力你们怎么评估?
混元团队答:递归自我改进还处在早期阶段,内部已经设了几项基准,用来衡量其中的关键能力。
Flash的参数花在哪儿了?
网友提问:不算Engram,Hy4 flash主干大约1560亿参数,每个Token激活约120亿。总参数不动,把激活参数压到80亿或50亿,效果会掉多少?
混元团队回应:不同MoE稀疏度的规模实验做过不少。激活参数量固定时,稀疏度提上去,计算效率会变好。可总参数固定、激活量降到80亿或50亿,按团队的预计,模型质量会明显下滑。每个Token能用多少计算,由激活参数量决定,提高稀疏度只能补回一部分。
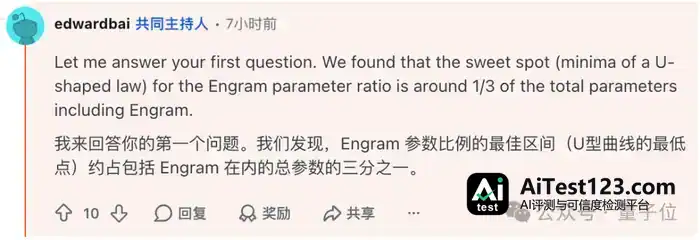
网友又问:Hy4 flash为什么给Engram分约635亿参数?这个比例怎么定下来的?
混元团队说:实验里跑出了一条U形曲线。把Engram计入总参数量后,Engram占比在三分之一上下时,最接近实验中的最优点。占比再往下压,计算效率就会掉。
网友问:Flash为什么选滑动窗口注意力(SWA)?
混元团队答:滑动窗口注意力把KV缓存压到原先的约四分之一,部署成本随之明显下降。
小模型、本地部署和下一步
网友问:会有Hy4 mini吗?也有人想要比Flash更轻的版本,用来跑文档解析、分类和简单自动化。
混元团队答:Hy小模型已经进了路线图。
有网友问,下一代的Hy模型会不会做到1.5万亿至2万亿参数?
混元团队回应称,下一代Hy模型的规模会明显再往上走。
也有人打听,是否会推出更轻的Flash-Lite,拿去处理文档解析、分类和简单自动化这类活儿。
团队给出的答复是:有,Flash-Lite可以期待一下。
网友追问,有没有面向24GB显存设计的模型计划?
混元团队表示有,后续会发布。
一位网友说自己手上是96GB显存加128GB系统内存,问能不能跑Hy4 flash。
团队答:能跑。主要权重和注意力计算交给GPU,一部分专家层可以卸载到系统内存,Engram表同样能放进内存里。
另有网友做了对比测试:同一个工作任务,托管版Hy4 flash全对,本地NVFP4版本却错了约8%。他问这是不是模型本身更难量化。
混元团队解释,量化效果跟采用的方法、校准方式关系很大。团队建议改用GPTQ量化的NVFP4版本,在自家评测里这一版与BF16的差距较小,对准确率敏感的任务更合适。
网友关心llama.cpp的支持会怎么推进,是否会提前和推理框架社区合作。
团队回复,llama.cpp适配正在进行,预计近期在社区放出;同时也与vLLM、SGLang等社区保持合作。
有人问现有的Hy4 flash还会不会继续更新。
混元团队确认会更新,目前正在优化Flash级模型的预训练和后训练方案。
怎么看模型的表现
网友提出疑问:GPQA Diamond、τ-bench、IFBench、SWE-bench这些常见评测,为什么没有公布成绩?
团队的说法是,他们选的是Agents’ Last Exam、ProgramBench这类更新、更难的评测。网友提到的那几项出现时间更早,分数已经接近饱和。
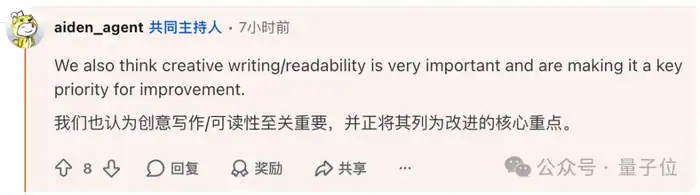
还有网友感觉部分模型的写作能力在退步,问是代码训练用太多导致过拟合,还是另有原因。
混元团队称也观察到了这个现象,可能跟训练目标有关。团队希望模型写出来更像人、套话更少,相关改进正在进行。
One More Thing
到这里,这轮QA实录就结束了。
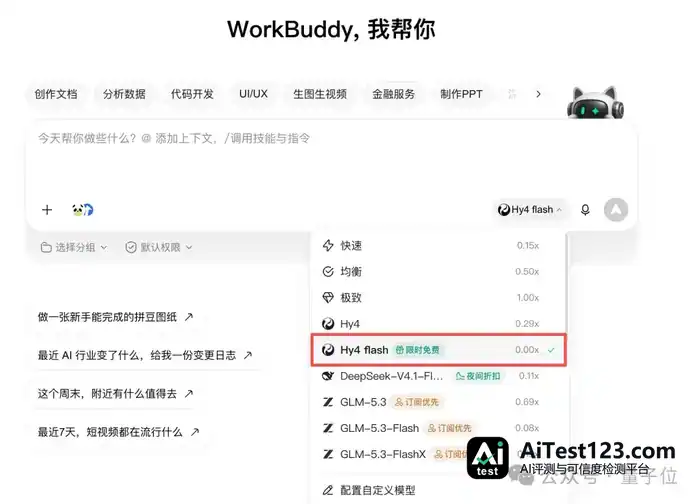
想亲自试Hy4 flash的话,打开WorkBuddy,在模型列表中选择Hy4 flash,把待改的表格或者待整理的会议纪要交给它跑一遍。
11月30日之前,WorkBuddy可以限时免费体验~
参考链接:
https://www.reddit.com/r/LocalLLaMA/comments/1y15w4a/tencent_hy_team_shunyu_yao_here_ask_us_anything/