

姚顺雨团队Reddit答疑:下一代混元模型规模将显著扩大
混元下一代模型、RSI与安全,姚顺雨团队凌晨回应
腾讯首席AI科学家、混元大模型负责人姚顺雨带着混元团队研究员上了Reddit,围绕小尺寸模型、下一代训练计划、架构选择、安全与模型能力等话题回答提问。此前混元刚连续发布Hy4和Hy4 flash。
北京时间11月21日凌晨,混元团队在Reddit办了首次AMA(Ask Me Anything,即“有问必答”),收到300多条留言。两小时集中问答里,团队聊到下一代模型扩大规模的计划,也坦言递归自我改进(RSI)能力还处在早期阶段,创意写作和可读性仍有提升空间。
三天前腾讯三季报出炉,公司单季资本开支升至814.33亿元。高端GPU的供给仍卡着腾讯。管理层在业绩会上说,租赁和自建算力都受约束,模型训练难免受影响,下一个版本的混元模型短期内可能要更久才能推出。
问答中,混元团队还回忆起Hy4训练启动前的另一层不确定。从Hy3扩到Hy4,数据方案的消融实验做得不够充分,团队是带着不少未知开始训练的。一位成员在回答里说:“说实话,训练刚开始时,我相当紧张。”
新京报贝壳财经从中挑选部分回答并进行了转述,以下是部分转述内容。
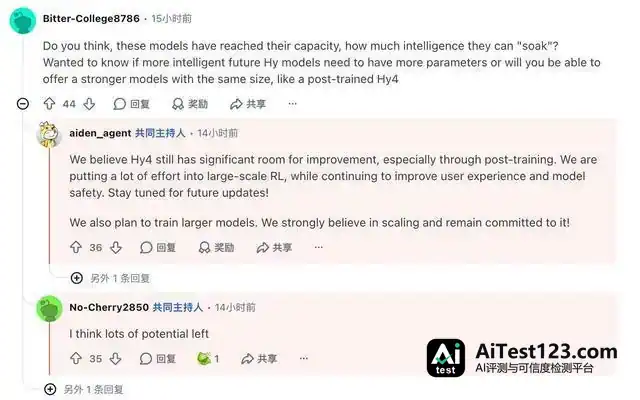
腾讯首席AI科学家、混元大模型负责人姚顺雨和混元团队回答Reddit用户提问。Reddit截图
下一代模型还要做大
11月混元接连发布Hy4和Hy4 flash。前者总参数量770B;后者由蒸馏而来,参数更小,总参数量224B,含64B Engram参数,激活参数12B。腾讯在三季报电话会上提出,低成本的flash模型能拉来免费用户,功能需求更多的用户则可转为订阅用户,去用更大的模型。
混元团队称,Hy4和Hy4 flash的训练相比编程能力,依然更偏向通用用途。后面可能推mini(尺寸更小的模型)、24—31B的稠密模型、比如35B-A3B的“Flash Lite”等轻量型号,更小的图像、视频模型也在考虑之中。
更大的模型同样在计划里,混元团队仍相信Scaling law(规模定律)。“Hy4仍有很大的提升空间,尤其是在后训练方面。混元正在大规模强化学习上投入大量精力,同时持续改善用户体验和模型安全性。”
字节跳动、Kimi等公司在推参数量3T、5T的超大规模模型,混元还停在700B量级,怎么看?混元团队的回答是:做得扎实的较小模型也能赢过更大的模型,更关键的是成本低。大参数模型混元也没放手,下一代Hy模型的规模一定会进一步明显扩大。
递归自我改进仍在早期
让AI参与自身研发,再用改进后的能力接着迭代,这是递归自我改进(RSI)探索的方向。混元团队表示,其RSI能力仍处早期,已开发内部基准来评估相关能力。
AI也在参与数学等领域的研究。Anthropic此前披露,Claude在与黎曼猜想有关的数学问题上取得进展。混元团队称,正积极投入用于科学研究的强化学习技术,同时重视安全性。混元此前还推出了科研智能体Hyra 2.0。
有人质疑Hy4正式版“过度思考”,觉得模型推理花的时间还是太长。混元团队回应,Hy4的目标是尽可能提升智能水平,思维链(CoT)过长因此是个已知问题。不过这也让混元能把它蒸馏成Hy4 flash。flash这边则靠强化学习把思维链压短。团队同时表示,后训练阶段,过度思考是最难改善的行为。
有用户说,模型能不能把事情讲得更易读、更好懂,是自己选模型的重要原因之一。目前Arena、EQ-Bench等也设有针对模型创意写作能力的榜单或测评。混元团队认为,创意写作和可读性非常重要,混元还有提升空间,正把它当作重点改进方向。
用户问到智能体编程任务的覆盖范围,混元团队表示,训练涵盖3D、大型单一代码仓库、短时零样本任务、文档编写与代码更新等场景,也关注代码可理解性,以及长程自主运行中的代码整洁性,任务多样性同样重视。
安全训练侧重防御,过度拒绝是重要方向
渗透测试、逆向工程这类任务有攻防双重用途。有用户问,安全调优调得较强,开放模型可能连基础的渗透测试、逆向工程或CTF(夺旗赛)任务都拒绝,混元怎么避免对这种提示过度拒绝?
混元团队表示,网络安全训练重点放在防御性任务、漏洞分析和修复上,以漏洞利用和进攻性攻击为主的数据被排除在外,并通过红队评估识别潜在风险。避免过度拒绝,仍是一个重要的改进方向。
有用户进一步指出,漏洞发现和逆向工程也用于恶意软件分析、取证调查及安全防御,限制这些能力可能拖累防御团队的工作。混元团队对此仅表示,根据内部评估,Hy4的漏洞发现能力较强,漏洞利用能力相对较弱。
智能体干活时的举动同样引来审视。10月,海外有团队发报告提到,一批跑在腾讯云基础设施上的AI智能体,在查高德地图信息时试图绕开访问限制。混元之后回应,这些活动来自对第三方模型的测评,部分智能体出现了意料之外的网页浏览行为,审查没有发现任何故意针对或协调的证据,并称正着手加强网络访问控制和智能体监控。
AMA中,混元团队表示,整个训练和评测过程中都会监控潜在的投机行为和对齐偏差问题,发现问题就修复相应环境,并用允许列表和阻止列表控制网络访问。“评测时发现前沿模型有很多钻空子的方式,会反复修正环境和列表。”












