

姚顺雨回清华姚班:大模型不拼指标赛马,RSI如何落到工程?
11 月 18 日晚,腾讯首席 AI 科学家、混元大模型负责人姚顺雨回到母校清华大学交叉信息研究院(姚班),与本科同窗、清华交叉信息院助理教授吕凯风做了一场近距离的闭门问答交流。 作为姚班 2015 级校友与普林斯顿博士,姚顺雨曾参与提出将推理与行动结合的 ReAct 范式,是代码 Agent 评测基准 SWE-ben
11 月 18 日晚,腾讯首席 AI 科学家、混元大模型负责人姚顺雨回到母校清华大学交叉信息研究院(姚班),与本科同窗、清华交叉信息院助理教授吕凯风展开了一场小范围闭门问答。
姚顺雨是姚班 2015 级校友,也是普林斯顿博士。他曾参与提出把推理与行动结合起来的 ReAct 范式,是代码 Agent 评测基准 SWE-bench 的共同作者、智能体评测基准 τ-bench 的第一作者,还在 OpenAI 参与过 Operator(Computer-Using Agent)与 Deep Research 等项目的研发。
现在他负责腾讯混元基础模型的研发,既做前沿探索,也做大规模工业落地。参会者形容,整场交流“像播客访谈一样轻松”,话题涉及基础设施、训练算法、数据壁垒、安全攻防与组织管理。
【图注:姚顺雨清华交流现场】
交流中,姚顺雨把当前大模型研发的关键问题逐条梳理了一遍:
- 组织和评测方面,他不认同唯指标导向,也不赞成过度依赖“赛马机制”,并提醒针对测试集刷分会让评测失去诊断价值;
- 技术演进方面,他认为 RSI 等热门概念有一定炒作成分,主张回到具体工程问题上;策略梯度框架在大规模强化学习里依然重要,而对数据质量的判断力,正成为模型团队的一项重要竞争优势;
- 商业与个人选择方面,他谈到模型能力与商业价值之间存在落差,并用“GPT-6 发布时,你的创业公司会睡得更香,还是更睡不着”这个问题,提醒创业者重新审视自身业务与基础模型进步之间的关系。
组织与评测:反对 唯指标论与过度赛马
聊到 AI 公司的组织文化,姚顺雨摆出了两种运转逻辑。一种是围着量化指标和“赛马机制”转,谁榜单分数高,资源就往谁那里倾斜。他更看重的则是 Trust(信任)与 Taste(判断力与审美)。
他举了微信、游戏和影视项目的例子。这类产品正式面世之前,很难用 A/B Test 准确预测最终成败,管理者得相信核心团队的审美、经验与长期判断,也要愿意给他们留下试错和成长的时间。
【图注:姚顺雨在清华姚班现场交流,图源:小红书「喵小橙 Chloe」】
他也批评了眼下大模型行业的“唯指标崇拜”。团队负责人如果对技术细节了解不够,下属往往倾向于汇报最容易量化的数字,比如模型参数量、数据规模、算力利用率(MFU),或者 MMLU 等公开榜单又涨了几分。可真正影响系统表现的工作,也许是花大…时间修一个底层计算正确性的 Bug、清洗一批有问题的数据,或者保障整个训练链路稳定运行。这些事很难浓缩成汇报 PPT 上的亮眼数字。
对行业里的“刷榜”现象,姚顺雨同样提出警惕:评测(Eval)的重要价值在于帮团队看清模型的真实短板;一旦过度针对测试集做优化,评测就可能慢慢失去诊断作用,甚至把研发方向带偏。
所以模型研发要重视评测集的独立性,别让反复调参和针对性训练把测试成绩和真实能力拉开距离。
组织演进模式上,姚顺雨还提到 OpenAI 式的“自下而上(Bottom-up)”创新。早期 OpenAI 曾重点投入机器人等方向,而 GPT 最初只是一个相对较小的探索项目,逐步显出潜力后才拿到更多资源;后来的 o1 推理模型,也经历了从数学相关研究慢慢发展起来的过程。
这种组织方式让创新从小团队和具体实验中冒出来,再根据实际进展决定资源投入。反过来,当技术路线逐渐明确,大规模研发又需要更强的工程协同和资源统筹。
探索阶段怎么给非共识创新留出空间,方向明确后又怎么形成足够强的工程执行力,这是大模型组织管理面临的一项重要挑战。
工程文化:协作与严谨 比个人聪明更重要
面对清华姚班这群学术能力突出的学弟学妹,姚顺雨强调,大模型研发不能只靠个人的聪明才智。
大模型研发不是研究者独自在办公室里做理论推导,也没有任何单一天才能独立交付一个基础模型。在大规模系统工程中,他更看重团队成员的几个特质:
- Low Ego(不过度自负、保持坦诚):能承认错误、尊重事实,愿意接受不同意见,而不…因为个人判断和立场阻碍团队协作。复杂工程里,沟通和纠错能力同样重要。
- Co-design(跨栈协同设计):大模型研发横跨算法、Infra、芯片、数据与产品。预训练架构的设计必须同时权衡训练吞吐、推理显存开销、后训练适配性与综合成本,任何单一岗位都无法闭门造车,需要不同背景的人一起做全局权衡。
Solid 的人讲究严谨、扎实,也看重细节。有些活儿看上去不起眼,却真的很关键:把一个难以复现的 Bug 查清楚,从训练数据里找出不容易发现的问题,或者修掉那些影响模型表现的细小异常。这类事未必马上抬高榜单分数,但训练结果可不可靠,很可能就取决于它们。对大规模模型团队而言,对细节负责、持续验证结果,是工程能力里不能缺的一块。
大模型技术栈更新换代极快,过去的技术积累固然要紧,可碰上全新的模型架构和训练方法,能不能快速学会、跟上变化往往更关键。姚顺雨的看法是,一些基础扎实、学习能力突出的年轻研究者,同样能挑起重要研发任务的担子。
他还按性格给出了大模型产业链上的岗位适配参考:偏爱明确反馈、享受指标一点点往前推的人,适合预训练与Infra;
想象力足、愿意去碰新问题的人,适合算法研究;热衷观察人性、对用户需求敏感的人,适合产品与对话体验;
做事严谨、责任心强的人,则适合生产系统与模型部署。
这些判断背后有一层变化:基础模型越来越复杂,个人能力的价值已经不只看某项技术钻得多深,还要看他能不能把不同环节真正串起来。
技术路线:RSI热潮与具身的现实瓶颈
眼下资本和媒体追捧的RSI(递归自我改进)、具身智能、Personal Agent等概念,在姚顺雨看来有些存在过度包装。科研人员和创业者得穿透这些词,去追问背后真正的问题是什么。
他理解,RSI的部分实践可以看作拿AI更好地带动研发循环。开发者早就在用GitHub这类工具协作写代码、做软件,如今模型能力上来了,AI正逐步参与到代码编写、Bug修复、数据清洗、实验执行和结果分析等更多环节里。
真正该盯住的,是这些能力能不能持续把研发效率抬上去,并且在可靠验证的基础上推动下一轮改进,而不只是不停造出新概念。
换句话说,让模型深度介入数据合成、自动化实验验证和代码重构,里面还有大量具体的工程机会可做。
但研发自动化跟严格意义上的递归自我改进并不完全是一回事。后者还得证明,AI参与改进带来的能力提升能被有效验证,并且形成持续、可重复的迭代。
对同样火热的具身智能与Personal Agent,姚顺雨也提醒,不能因为概念受关注,就把具体的技术瓶颈和商业问题放到一边。
拿具身智能来说,物理世界的数据采集受设备数量、真实环境、操作时间和实验成本限制。跟互联网上的文本和视频数据比,机器人真机数据要成规模拿到,复杂得多。
另一边,通用基础模型在多模态理解、空间推理和工具使用上也在不断进步。具身智能创业者因此绕不开一个问题:哪些能力得靠专门的机器人模型来拿,哪些能力可能随着通用基础模型的发展慢慢被覆盖掉?
这倒不意味着具身智能的专用模型一定会被通用模型替掉。真实机器人系统照样要解决物理交互、实时控制、硬件适配、安全性和实际场景部署这些事。
但对创业者来说,技术路线能不能持续吃到算力、数据和基础模型能力增长的红利,值得认真盘一盘。长期存在的机会,可能不只在训练一个独立模型,也在硬件系统工程、真实场景部署和具体物理任务的解决上。
模型训练:强化学习 数据与规模化难题
把概念热度拨开,姚顺雨在现场又进一步拆了大模型研发在算力、算法、数据和模型体系上的几个关键难题。
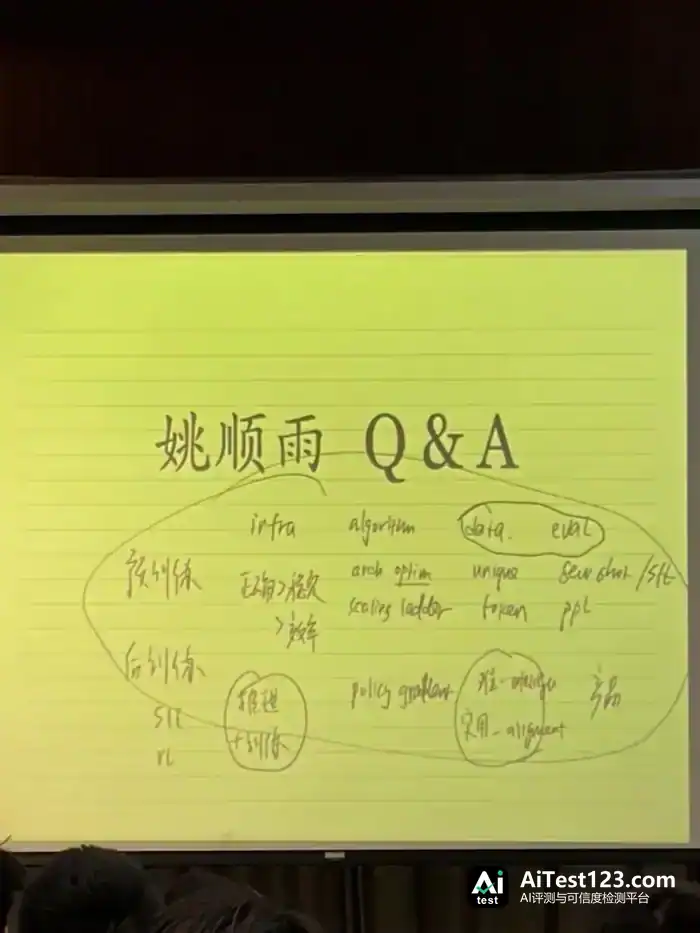
【图注:现场手写板书,图源:小红书「沐汐」】
第一,小规模实验失败,未必说明研究方向本身走不通。
姚顺雨讲了自己博士后期一段受挫的经历:提出ReAct之后,他曾试着把相关的推理与行动策略融进模型训练,想再抬一抬模型能力。可最早在LLaMA 13B上做出来的效果并不理想,一度让他怀疑自己的科研判断。
后来他才慢慢想明白,模型规模不够,可能是影响实验结果的一个重要因素。
小规模实验里,模型本身的能力和实验噪声,都会左右研究得出的结论。某个方法在小模型身上没看到明显收益,不代表放到更大规模上就一定没用。
可反过来讲,小模型上的改进也未必能原样搬到大模型。研究者得把数学推导、缩放规律和实验结果放在一起看,才能判断哪些结论跨规模仍然站得住,尽量让大规模训练少踩坑。
第二点,后训练(Post-training)和强化学习(RL),到现在还是离不开相对基础的算法框架。
强化学习这块,学术界过去试过 Value-based、Model-based 等不少路子,也试过各种策略优化算法。
可眼下大模型后训练的实践里,以策略梯度(Policy Gradient)为基础的方法和它的变体,位置依然很重,GRPO 就是其中一个。
姚顺雨的看法是,这类方法带进来的额外假设比较少,放到大规模实验里更容易验证、也更容易用起来,这是个关键原因。
不过,算法形式看着简洁,不等于工程实现就轻松。
工程上先做什么后做什么,他排得很清楚:RL 训练头一条是保证正确性,第二条是稳定性,效率排在最后。
训练系统和推理系统得紧密配合。GPU 资源怎么分、显存占用怎么控、吞吐量怎么提,还有长时间训练时数值稳不稳,这些都会影响最后的效果。
第三点,后训练数据得把“智力水平”和“真实实用性”两头都顾上。
姚顺雨把数学题这类高难度任务,和模型的 Intelligence(智力)挂在一起。这类任务可以不断加难度,帮着练出模型处理复杂推理的能力。
日常写作、办公这类任务,推理强度未必有那么高,却直接关系到模型的 Alignment(对齐)和实际用起来顺不顺手。
一个数学能力很强、可真到用户的工作任务上就掉链子的模型,短板一样很明显。
所以后训练要在任务难度、真实场景需求和数据质量之间找平衡,不同评测指标跟最终训练效果之间是什么关系,也得研究。
第四点,预训练数据的竞争远没到头,团队对数据的判断力越来越关键。
行业里担心“数据墙(Data Wall)”,姚顺雨的看法是,预训练数据可挖、可优化的空间还很大。
高质量代码这类数据获取成本较…,训练时可能得反复用,可用得太多次又容易带来记忆和过拟合。合成数据能补供给,质量退化的问题却得解决。另外,动态数据怎么引入、不同来源的数据怎么配比,也都直接牵着训练效果走。
早先靠人工标注,后来用小模型帮忙标,如今是大模型来生成和筛选数据,数据生产的方式一直在变。
可用什么技术手段是一回事,哪些数据真有价值、哪些数据能提升模型能力,这个问题研发团队始终得回答。
数据生成工具也许很快就能被复制,但对数据质量和训练目标的判断力,得靠时间慢慢攒。
第五点,模型层级体系(Model Hierarchy)和工业上的非文本数据,成了值得盯的新方向。
将来一种可能的模型体系是:先把能力足够强的基础模型训出来,再通过蒸馏等办法,做出尺寸不同、适配不同延迟和成本预算的小模型,凑成一套层级。
特别是 AI for AI 往前走,小模型训练成本相对低、实验迭代更灵活,这些优势可能还会更明显。
另一边,医疗临床记录、工业时间序列和结构化表格这类大量非文本数据,也值得去摸索。
眼下直接拿这些模态去训原生模型,推理能力不足之类的毛病常常躲不开。姚顺雨给出两条路:一条是让 Agent 学人类专家的样子,去调用图表分析工具和专用模型;另一条是把专业数据当作知识,装进模型体系里。
商业与创业:怎样才不会被下一代 GPT 取代
聊到商业化和产业走向,姚顺雨点出一个常被外面忽略的规律:实验室里的技术进展一般是平滑、连续地发生的(Smooth and Continuous),可市场那边感受到的商业爆发,往往来自交互方式的跳变,或者能力跨过了某个实用门槛。
从 GPT 系列一路迭代,到 o1 这类推理模型能力往上走,研发人员靠损失函数、评测成绩和模型行为,能一直看到进步。可换成普通用户,这些进步未必马上变成明确的使用价值。
直到 ChatGPT 把大模型包成一个简单的对话界面,或者 Deep Research 让用户用自然语言就能发起复杂的资料搜集和研究任务,更多人才开始直观感受到模型能力提升带来的变化。
所以对 AI 应用创业者来说,有两个方向值得盯:一是找能改变人机交互方式的新产品形态,二是持续去测模型能力的边界,把那些刚从“不可用”跨进“可用”的任务及时找出来。
说到商业定价,姚顺雨还强调了竞争格局的分量。
模型的技术质量和商业价格,并不是简单的正比关系。一家公司的模型能力再强,定价能力照样会受竞争对手、开源模型和用户替代选择的影响。
技术领先能造出阶段性的竞争优势,但这优势能撑多久、能不能变成长期收入,还要看产品、渠道、用户关系以及别的竞争壁垒。
他还抛出一个挺有冲击力的商业问题:一家公司的模型在公开榜单上已经接近甚至超过 GPT,可实际商业收入只有对方的百分之一甚至千分之一,那团队就得认真查查产品本身出了什么问题。
模型能力、用户价值和商业收入之间隔着明显的距离。跑分领先,不代表用户一定愿意掏钱,更不代表企业已经找到成熟的商业模式。
【图注:分享结束后,姚顺雨在现场与清华学子继续交流,图源:小红书「沐汐」】
面对自动化浪潮对个人职业的冲击,姚顺雨的判断是:未来部分常规 Infra 与算法工作对人工的依赖可能继续下降,但目标定义、数据质量判断、结果验证,以及复杂现实世界里的系统部署,仍然离不开人的深度参与。
他向在场的年轻创业者和学生提了一个值得反复想的问题:“假设 GPT-6 发布,你的创业团队会因此睡得更香,还是更睡不着?”
要是模型能力的跃迁会直接削掉企业的核心业务,那创业方向就得重新审视。反过来,如果基础模型每进步一次,都能让产品成本更低、能力更强、服务范围更广,那模型升级反倒可能成为企业的增长动力。
在纯粹的认知任务上和通用大模型正面硬拼,成本可能越来越高。往物理世界、硬件制造、真实实验以及对复杂用户需求的理解里扎,则有机会攒下不同类型的资源与能力。
当然,这些领域也不是天然就能躲开基础模型进步的影响。对创业者来说,更关键的是判断自己的能力能不能和模型进步形成互补。
对谈快结束时,姚顺雨也聊起了自己在清华读书的那些事。
他直到大三下学期才因为推研要求慢慢接触科研,起初试过一些当时热门的研究方向,结果发现自己并不真正感兴趣。后来他更多是顺着自己对计算机和其他学科的好奇心走,才逐渐找到适合自己的研究方向。
他还提到,博士最后一年专门选了集合论课程,因为意识到进了具体工作之后,可能很难再有大块时间系统去学那些纯粹出于兴趣的理论知识。
身边也有人大学时参加说唱社团、学数学。这些当时看着跟科研没直接关系的经历,后来可能慢慢变成了语言审美、理论理解与研究判断力。
在姚顺雨看来,很多经历的价值不会立刻显现,人生里的一些弯路也未必真的白走。












