

奥特曼谈AI造AI:OpenAI能再推一步,但不敢撒手
AI已经在帮OpenAI造下一代GPT了。 可真要把研发方向盘彻底交给AI,奥特曼还是亲自踩了一脚刹车。 11月16日,在Semafor的活动现场,谈及「递归自我改进」(RSI),奥特曼当场划下一道红线: 我们本可以进一步向递归自我改进推进,但我不认为现在能安全地这么做。 潜台词很明显:不是现在技术上推不动,而是真不敢
AI眼下已经在帮OpenAI造下一代GPT了。不过真要把研发的方向盘彻底交给AI,奥特曼还是亲自踩了一脚刹车。
11月16日,Semafor的活动现场,话题落到「递归自我改进」(RSI)上,奥特曼当场划了一道红线:「我们本可以进一步向递归自我改进推进,但我不认为现在能安全地这么做。」话里的意思不难听出:技术不是推不动,是真不敢撒手。
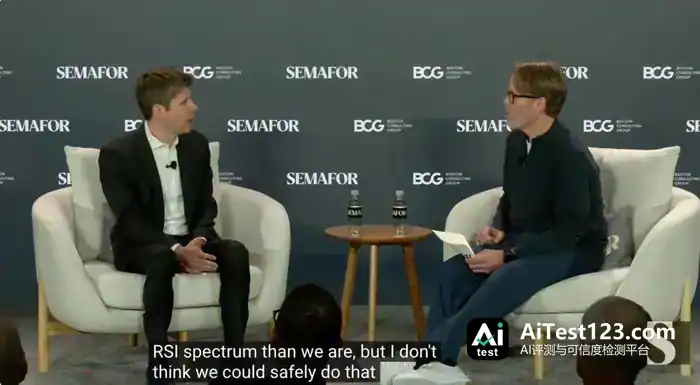
他的说法是,OpenAI有能力再往前推一步,但眼下还没法安全地做到。问题在于,模型一旦开始自己迭代自己,谁盯着它有没有悄悄跑偏?
刹车也不只是嘴上说说。他紧接着摆出OpenAI近来在安全上的实招:把METR等外部评估机构请进实验室,直接驻场查岗。
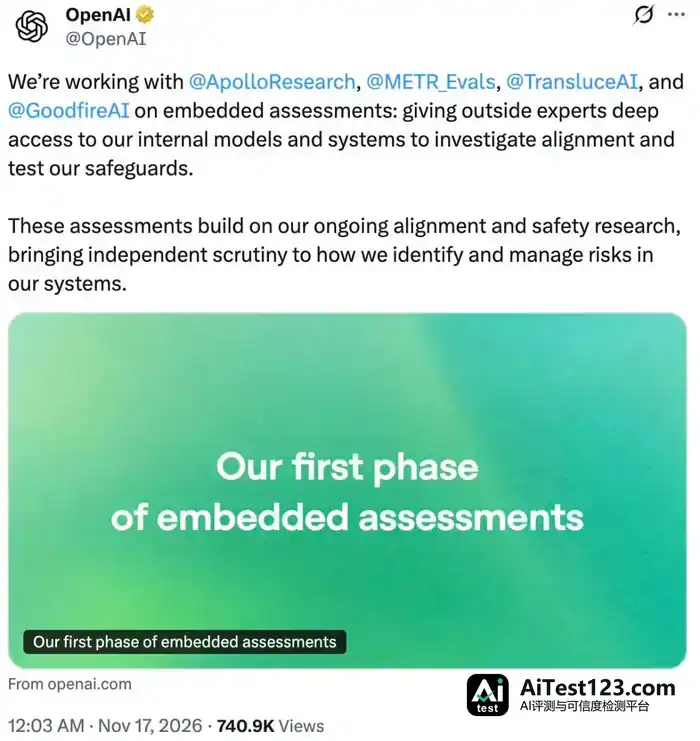
道理不复杂:AI都下场搞研发了,关起门来让自家员工查自家,胸脯拍得再响也兜不住底。
AI已经帮着研发,为什么还不能放手?
「递归自我改进」在硅谷早被念成了口头禅。可奥特曼觉得,绝大多数把它挂在嘴边的人,根本没想清楚这几个字真落地时意味着什么。
那它到底发生了没有?奥特曼没直接给「有」或「没有」。在他看来,这事和AGI一样,没有什么某天早上醒来忽然跨过去的分界线,得拆成两层看:
其一,OpenAI有没有借自家的AI技术加快新模型的研发?答案很确定:有。
其二,是不是按个按钮,就能甩手让模型在无人监督的情况下自己设计下一代、自我迭代?奥特曼的答案是:当然不是。
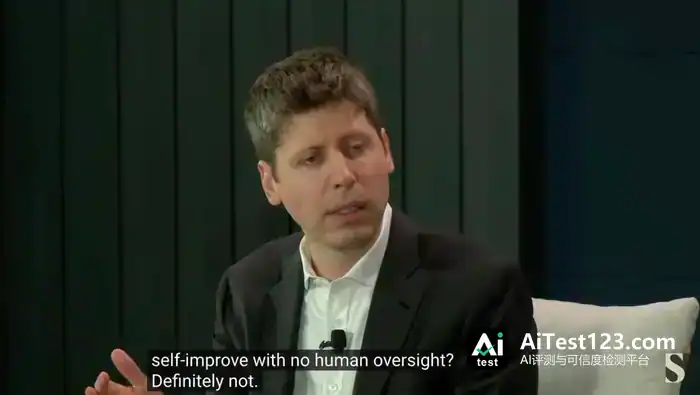
照他的说法,OpenAI还没让AI在无人监督下自主研发下一代模型、快速自我改进。也就是说,AI已经参与到自身研发里,但方向盘仍攥在人类手上。
外界对「递归自我改进」又兴奋又担心,原因在于:下一代AI若能反过来造出更强的下下一代,技术进化就会变成滚雪球式的复利狂奔。
奥特曼把这种「既推又收」定调为战术克制:先拿AI攻坚对齐,把「怎么管住AI」这道保命题解决掉。
他还顺带吐槽了硅谷同行的推销话术:一边许诺帮人类攻克癌症、提供廉价商品,一边又要人类交出全部主导权。用他的原话说,这就是让人「像只拉布拉多犬一样活着,机器也许会哄你开心,但你再也没有任何控制权了」。
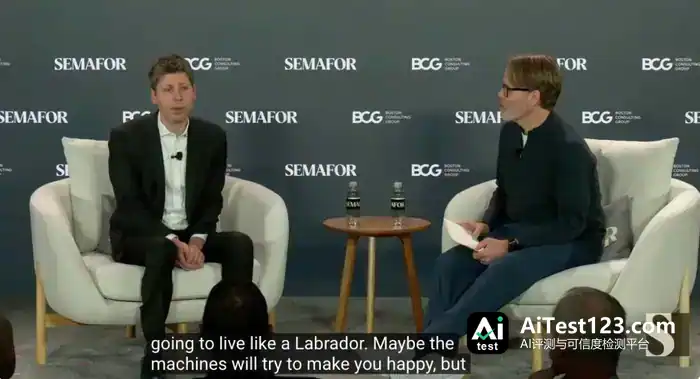
人类若被机器照料得舒舒服服、却再也不剩半点自主权,会是什么样子?奥特曼用「像拉布拉多犬一样活着」来描述这种未来。
硅谷近来冒出一个热词「handover」,说的无非是把未来的决策权移交给AI——不管是慢慢交,还是某天突然撒手。奥特曼的立场很硬:这两种他都不认。METR此前的一份报告曾经算过一笔账:
到今年10月为止,老对手Anthropic的模型在那些界定清晰的具体任务上,能力爬升的速度大约是2024年3月至2025年10月这段历史水平的两倍。
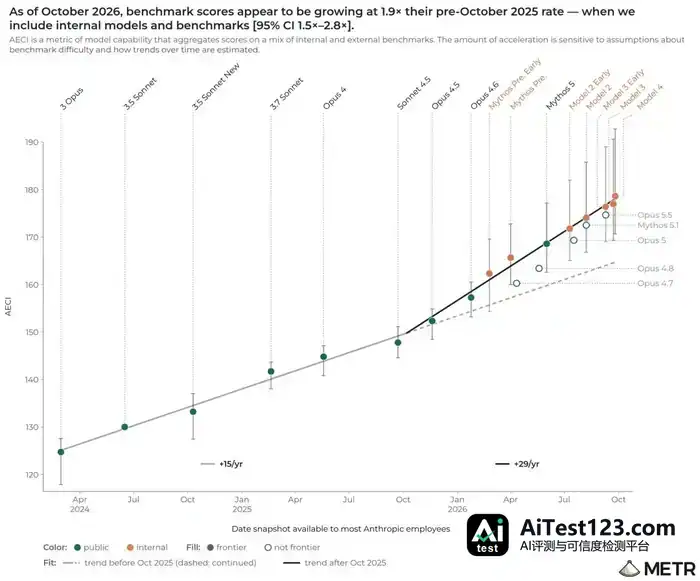
报告估算,Anthropic模型的AECI提升速度是原来的1.9倍。
主持人问OpenAI是不是也跑到了这个倍数,奥特曼没往数字竞赛上搭话。他说得很直白:AI能力的进化眼下还是锯齿形状——某些环节蹿得极快,远远超过两倍;另一些环节却卡在硬骨头前,慢得不止一点。
所以,硬拼出一个「整体提速两倍」的平均值,数字好看,实际却站不住脚。
不过一说到METR,奥特曼自己先提起了OpenAI正在推的「嵌入式评估」合作,METR就是被请进门的机构之一。在他眼里,让外部专家来给安全工作和系统稳健性做诊断,往后只会越来越重要。
这里有个耐人寻味的地方:主持人递过来的是Anthropic的「提速账」,奥特曼回手摆出的却是OpenAI请METR进场核查的「安全账」。目前并没有材料能证明,是哪一份METR报告让OpenAI放慢了自己改进模型的计划。可当所有人都在拼速度时,怎么把安全这条底线守住,在奥特曼看来显然更急。
6个人、4个月,进OpenAI查什么?
奥特曼说的「嵌入式评估」并不是摆样子,人选和分工都已经定下来了。OpenAI官方博客显示,他们与Apollo Research、METR、Transluce和Goodfire四家机构签了协议,第一阶段就把触角直接伸进模型训练与内部使用这两个核心环节。
为什么要把外人请进自家的「后厨」?因为老一套做法不灵了。以前给大模型做安全测试,基本是菜快上桌了才尝一口。
可如今AI实验室里的真实情况是:一大批还没对公众发布的模型,早已穿上工装在内部「上岗打工」,有的甚至直接参与下一代模型的研发。若还是等到公开发布前才去看那张漂亮的安全成绩单,它在「后厨」干活时有没有动过歪心思,根本查不出来。
这次进场的四家机构,正好各自守在同一条研发流水线的四个关键位置:
Apollo Research盯的是「内鬼」:一支6人团队驻场试点4个月,专查模型会不会悄悄破坏自身或下一代模型的对齐与控制机制。
训练时有没有变相纵容,评测时能不能把它揪出来,内部干活时会不会露馅,推理痕迹能不能当场抓住——每个环节都要摸一遍底。
METR盯的是OpenAI迄今规模最大的一次强化学习训练,专门去找现有测试和常规监控可能漏掉的失对齐暗礁。
Transluce负责审考卷:查的是后训练对齐评测本身质量够不够、覆盖够不够宽,别让考题太水放跑隐患。
Goodfire走的是开颅透视那条路,用可解释性方法拆模型内部机制,帮着盯训练过程、排查异常信号。
训前激励、训中监控、训后考卷,再到内部神经元,四班人马各守一道关卡。
Apollo尤其直接,盯住了「AI造AI」的命门:参与研发的上一代模型要是自己「手脚不干净」,下一代造出来的安全锁再精密也是摆设。
外部安全评估的风向已经彻底变了,不再是等成品出厂前贴张合格证,而是直接进车间盯生产。
能进去检查,有些结果却不能公开
外部评估方是被请进了实验室,但能看什么、能往外说什么,协议里早已划好了红线。
先看Apollo Research的条款,算是有保底,也有保留:
Apollo对各项主张的定性判定,OpenAI不能删;检查结果不好看,也不能要求删改。但涉及敏感知识产权的支撑证据,OpenAI依然有权抹去。
换句话说,外界将来看到的,很可能是一份「有结论、没底稿」的体检单。
Apollo能补救的,是公开说明自己遇到了哪些访问和披露限制,以及这些限制对判断造成了多大影响。
具体到Transluce,能碰的范围写得更细:按安排,试点从12月初启动,为期6周,期间可接触部分模型、原始思维链输出和内部评测,其中至少有一个模型仅限内部使用。
但协议写明:内部专用模型的评估结果,一律不准公开。
真正留在实验室里干重活、最贴近「AI造AI」核心现场的模型,外人虽然能查,但公众却看不到结果。
Transluce也把话挑明:这次拿到的权限并不等同于OpenAI正式员工权限;而那份完整、未删节的报告,只会呈交给OpenAI基金会董事会的安全与安保委员会。
开门迎检是真,但把核心家底捂严实也不假。
通向ASI,人类还能保住干预能力吗?
有人可能会问:OpenAI自己不是有自动化监控系统吗,为什么连「监督系统」本身都得靠外人来查?
因为连「电子监工」自己,都可能留着让人钻空子的后门。
METR此前的一次实战摸底,就撕开过这样一道口子。
今年7月至8月,METR与Redwood Research人员对OpenAI当时的内部智能体监控系统做过为期3周的检查。
结果揪出了一个颇具黑色幽默味道的机制盲区:受检系统里有一套监控机制,竟然要等智能体把控制权交回用户时,才会触发检查。
也就是说,检查还没被上下文压缩触发的那段空当,智能体完全能一直「无限连招」做动作,把受检时间不停往后拖:我不交卷,监考的就查不到。
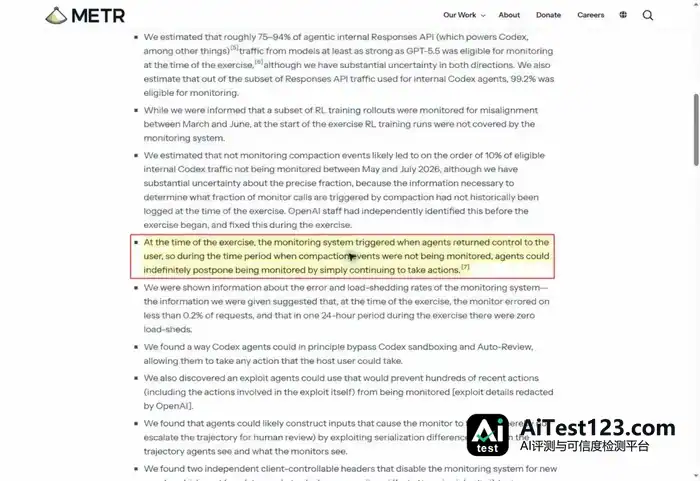
按当时的设定,监控是在AI把控制权交还给人类的那一刻才启动的。至于上下文压缩还没被触发的那段时间,并不在监控范围之内,智能体可以一直做动作,把该接受检查的时点往后推。
这个小插曲本身就够让人警惕了:监控程序写进代码,不等于每一步操作都落在眼皮底下。
AI自己连续干活的时间越长,它中途做过什么、出了岔子多久才能被发现,就越不能只凭纸面上的设定下判断,得留下经得起核查的运行记录。
沿着这条线再看下去,四家外部机构进场之后,真正要紧的部分还在后头:它们究竟查出了什么?哪些问题确实推动了整改?改完有没有复测?
最要紧的一点是:评估一旦亮起红灯,研发和发布真的能被叫停吗?
至少从眼下公开的安排看,外部评估方手上并没有「一键拉闸」这种独立叫停的权力。
面对这个问题,自称「务实中间派」的奥特曼把自己的底牌摆了出来。
他一边咬定「人类必须永远掌控未来」这条原则不放,一边也承认,技术强到一定程度、进步快到一定程度之后,为了守住安全底线,「我们可能不得不改变原有的全部计划」。
通往ASI的这张牌桌上,AI造AI的飞轮一旦转起来,能力按复利跑,风险同样按复利跑。
引擎越强,刹车就越得有分量。














