腾讯混元Hy4 flash首日登顶OpenRouter,单任务成本仅0.26元
在全球知名大模型聚合平台 OpenRouter LLM 日排行榜上,腾讯混元最新发布的 Hy4 flash 成功登顶,成为全球开发者高频调用的首选轻量模型之一。
腾讯混元刚发布的 Hy4 flash,在全球知名大模型聚合平台  OpenRouter 的 LLM 日排行榜上拿下第一,成了全球开发者高频调用的热门轻量模型之一。
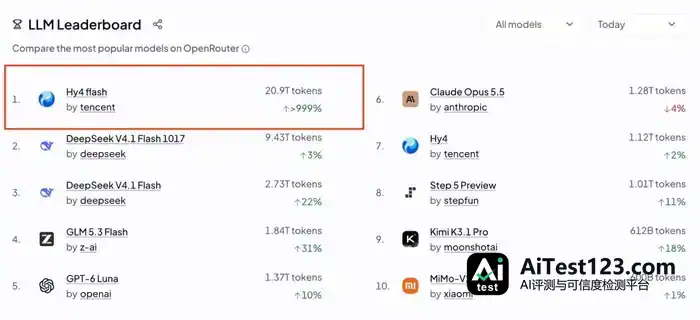
上线首日,Hy4 flash 的 Token 调用量就超过 50 万亿,刷新了混元系列模型首日调用量的纪录。
能取得这样的成绩,关键一点在于 Hy4 flash 既便宜又能打。价格先摆出来:
输入每百万 Token 0.5 元,输出每百万 Token 2 元;命中缓存的话,只要 0.02 元;
跑完一个任务花 0.26 元,只有 Hy4 preview 的 1/13、Hy4 的 1/20,也仅为 DeepSeek-V4.1-Flash-1017(Max 档位,忙时价格)的 1/8。
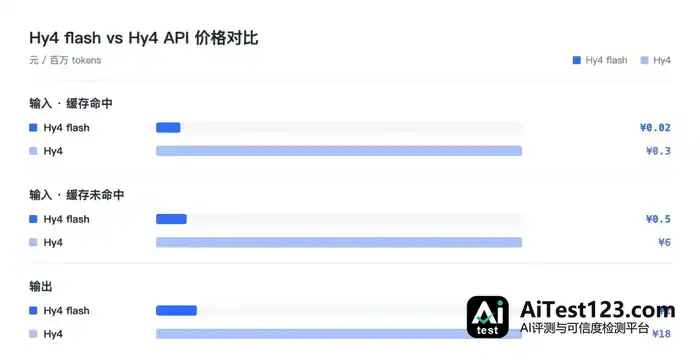
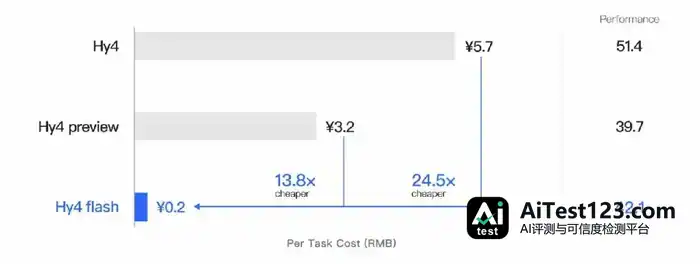
腾讯因此称,Hy4 flash 是迄今性价比最高的 Hy 模型。这个价格摆出来,谁看了都得说一句“真便宜”。
价格是降了,能力会不会打折?参数上,Hy4 flash 总参数量 224B(其中 64B 为 Engram 参数),激活参数只有 12B,支持多模态和 1M 上下文长度。参数量大约是旗舰的四分之一,可它的表现依然接近旗舰开源模型,深度搜索、文档处理、PPT 生成这些日常办公任务大多完成得不错。
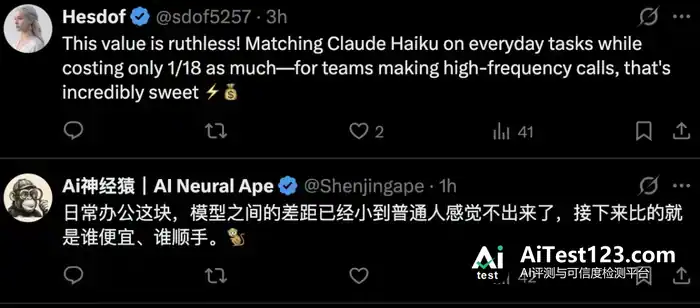
发布之后,海内外网友很快讨论起来。有人直接算成本账:“这性价比太狠了!日常任务表现能媲美 Claude Haiku,成本却只有后者的 1/18。对于需要高频调用模型的团队来说,实在太划算了。”也有人判断得更直接:“日常办公这块,模型之间的差距已经小到普通人感觉不出来了,接下来比的就是谁便宜、谁顺手。”
现在,Hy4 flash 已经在腾讯云 TokenHub 上线。
Token 调用量突破 50 万亿,Hy4 flash 怎么做到“又快又省”?
新模型上线首日 Token 调用量就突破 50 万亿,创下混元系列模型首日调用量新高,这份战绩确实亮眼。腾讯董事会主席兼首席执行官马化腾表示,“Hy4 已达到中国顶尖大模型水平,Hy4 flash 则显著降低推理成本,把高性价比的模型能力应用到实际场景中。”
对大模型进展保持关注的人可能早就发现,今年腾讯混元的发布节奏相当快,平均每两个月就推出一个大版本。
11 月 4 日发布的 Hy4 主打“为真实生产力而生”,参数规模与 preview 版保持一致,预训练和后训练规模则大幅扩展,还首次加入视觉理解能力,支持通过图形界面和命令行执行任务。发布时,它在 Agent Arena 位列全球开源模型第一、中国模型第一。
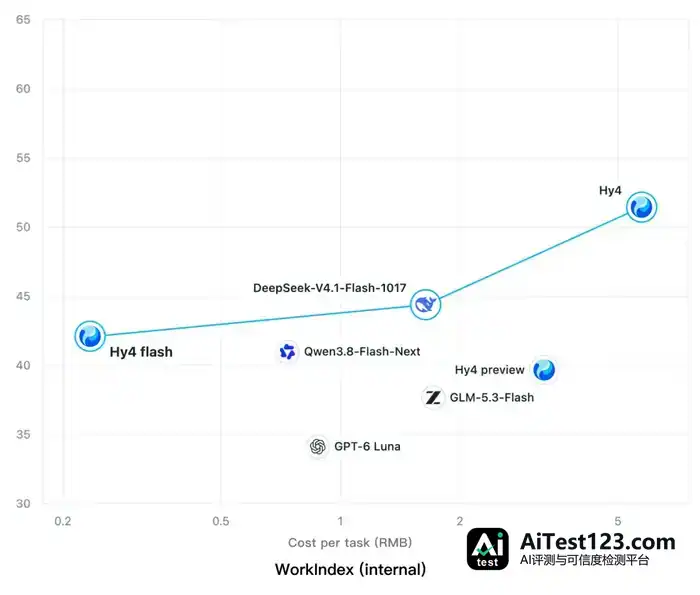
最新的 Hy4 flash 把使用成本又往下压了一截。据介绍,Hy4 flash 总参数量 224B,激活参数仅 12B,综合效果略好于规模更大的 Hy4 preview,是迄今性价比最高的混元模型。
价格之外,任务完成得好不好同样要看。日常办公场景里,大家不光在意消耗多少 Token,还在意一项任务多久能做完、做得怎么样。
为了更准确地评估 Hy4 flash,混元团队搭建了内部评测集 WorkIndex,覆盖 PPT 制作与修改、文档编辑、表格修复、音视频处理及视觉理解等典型任务。按 WorkIndex 测算,Hy4 flash 的单任务成本只有 Hy4 preview 的 1/13、Hy4 的 1/20。
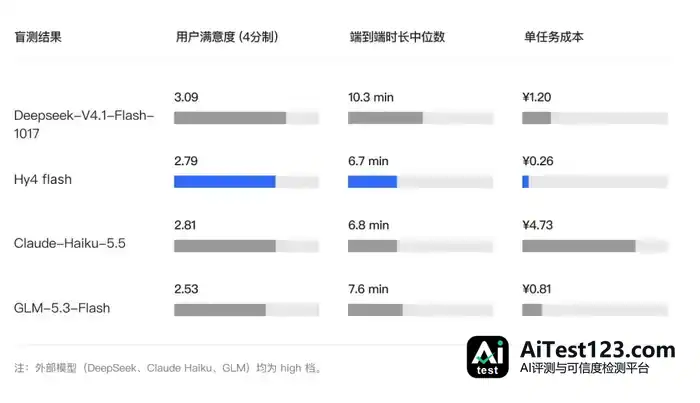
腾讯内部还做了盲测,85 位用户参与,覆盖 27 类共 259 个任务。结果是 Hy4 flash 的用户满意度接近 Claude Haiku 5.5,在参与比较的模型里,它的单任务成本最低,任务耗时也最短。
具体数字是:Hy4 flash 单任务成本 0.26 元,端到端时长中位数 6.7 分钟;Claude Haiku 5.5 成本 4.73 元,时长 6.8 分钟。满意度几乎持平,成本却差了一个数量级。
WorkBuddy 产品经理 Anne 提到,“与 Hy4 相比,Hy4 flash 的平均任务耗时减少了 70%,平均成本约为前者的 1/15,效果在日常工作任务上基本持平”。
元宝产品负责人 Logan 表示,“在元宝真实场景下,Hy4 flash 的 Agent 能力相比 Hy3 提升了 13.6%,任务完成的充分程度和信息呈现质量都有改善。在元宝通用对话任务上,Hy4 flash 相比 GLM-5.3-Flash 提升 2.52%,其中多轮对话能力提升最明显”。
研发场景里,Hy4 flash 也显出一定优势。王者荣耀项目管理负责人 TH 提到,“在游戏研发 Bug 分析评测中,针对 UI 交互、系统逻辑等问题,Hy4 flash 的根因定位表现接近 DeepSeek-V4.1-Flash-1017 和 GLM-5.3-Flash,但模型请求次数减少 22.0%-39.1%,按请求回执统计的 Token 消耗量减少 40.5%-61.2%”。
能用更少的资源完成质量相近的任务,靠的是混元团队在模型架构、训练方法和推理部署上做的一系列优化。
预训练阶段,Hy4 flash 重点压的是推理时的“固定开销”。它总参数量 224B,其中 64B 是 Engram 参数,每个 token 只激活 12B。加上混合注意力、LatentMoE 和 Engram 等架构设计,KV Cache 被压缩到 Hy3 的 1/24、Hy4 的 1/6。
更值得看的是后训练阶段的优化。过去一年,行业里关于推理模型过度思考的讨论越来越多。有些模型碰上极其简单的问题也会“想太多”,白白浪费资源。
Hy4 flash 的改进方向很明确:在保证任务效果的前提下,把没必要的输出压到最低。混元团队的做法分两步,先靠自蒸馏 Hy4 让 Hy4 flash 获得较强的综合能力,再通过强化学习打磨任务执行过程。数据显示,这一轮优化下来,Hy4 flash 的端到端任务输出长度减少了 50%。
推理环节也做了进一步处理。混元团队把 Megakernel、4bit 量化和 DFly 等技术结合起来优化推理过程,让 Hy4 flash 的解码速度突破 150 tps,也就是每秒能生成 150 个以上 Token。再加上缓存压缩和输出长度方面的优化,Hy4 flash 在维持日常任务效果的同时,把部署和运行成本压了下来。
不过,模型便宜了,不代表企业的 AI 使用成本就会自己降下来。员工和业务系统用得越多,企业要面对的成本问题反而越复杂。哪个任务该调哪个模型?Token 消耗集中在哪些业务环节?低价值的调用怎么才能不一直占着预算?
模型已经足够便宜,剩下的成本花在哪里?
企业的 AI 账单,正在变成让财务和 IT 一起头疼的东西。
Capgemini 今年 9 月调研了 500 位高管,结果显示 59% 的企业过去一年 AI 支出明显超出预期或预算,超支幅度平均达到 24%,还有 60% 的组织至今没有一套企业级的 AI 成本可见性。KPMG 的数据则直接点出了企业 AI 账单的混乱:只有 26% 的企业对自家 AI 花了多少钱有全面掌握,22% 要等账单寄来才知道。很多企业甚至不清楚钱究竟花在了哪里。
拆开来看,这些数字背后是几个很具体的麻烦。以前企业可能只有少数几个 AI 应用,调用量和成本相对好估算。但当多个部门深度用上模型之后,这笔账就复杂了。有些任务要在短时间内处理大量请求,有些对处理时间没那么高要求,如果所有任务都走同一种服务方式,资源浪费就难免了。
另外,不同部门各自接入模型,Token 消耗分散在各个应用里,企业想算清每笔支出的去向也不容易。模型接进来之后还有不少琐碎工作,配置服务、编写接入代码,出了问题还得逐一排查。模型数量和应用规模一增加,这部分工作就会不断累积。
模型单价降下来,对企业只是第一步。真要把 AI 开销管住,模型怎么接、不同任务走哪种服务、持续冒出来的 Token 消耗如何管,这几件事都绕不开。腾讯云大模型服务平台 TokenHub 对准的正是这些环节。
TokenHub 是 Hy4 flash 面向企业的统一接入入口,同时把主流模型聚到一起,文本推理、代码、图像、视频等能力都在其中。混元系列之外,腾讯云还在持续扩大第三方模型阵容,重点 SOTA 模型支持 Day0 接入。此前上线的 Hy4、小米 MiMo V2.6 系列,都是在上线首日完成接入的。
可选的模型多了,接下来要解决的是怎么用。TokenHub 的思路是把服务切成不同交付形态,企业按场景挑选,不必只盯一个价格买单。
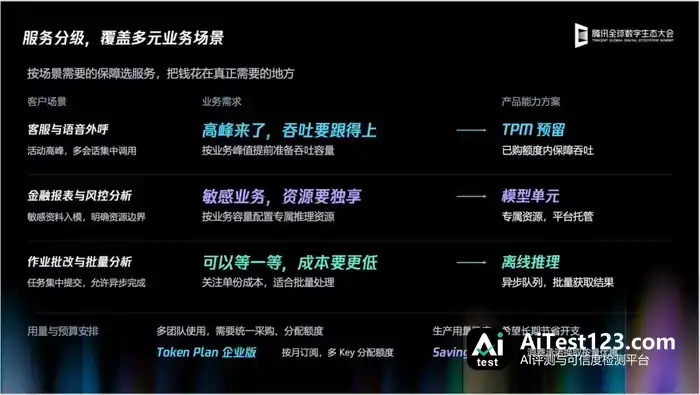
客服、语音外呼这类场景看重峰值吞吐,对应的是 TPM 预留,企业按业务峰值提前把容量锁定,大促当天无需临时抢资源。金融报表、风控分析等强合规场景对应模型单元,企业拿到一块独占算力,敏感数据在物理隔离环境中完成推理,再叠加 AICC 可信运行的全链路安全方案。作业批改、批量分析量大、可排队、对延迟不敏感,离线推理服务用队列承接,资源价格明显更低。
同一个平台,三种服务形态,企业可以根据任务特点选择服务,让钱花在真正需要的地方。
企业 AI 账单容易乱,TokenHub 的 Token 治理套件为此提供了对应管理能力:通过 Key 分配使用权限和额度,按 Key 分账、审计,并追溯关联的调用记录。
管 Token 之外,TokenHub 还想替企业省掉用模型时的重复劳动。以往开发者接入一个新模型,一般先翻文档弄清接口和配置,再写代码、调服务;模型上线后,日常运维和排查问题照样要花精力。
TokenHub 的办法是“让 AI 来用 AI”。开发者在惯用的 AI 工具里说明要做什么,AI 便经 TokenHub Skill 和 CLI 帮忙完成日常使用、观测和排障,少翻文档、少切控制台。对企业而言,省下的是时间,也是模型迭代加快后越积越多的适配与运维成本。
从服务分级、Token 治理到使用环节的自动化,TokenHub 想接住的是模型进入企业后的一整套成本问题。不过成本只占一部分。模型接触的数据越敏感,安全的分量就越重。
当 AI 开始处理企业内部数据,便宜就不够了
今年 10 月,OpenAI 披露了两起发生在内部的 Agent 安全事件。
10 月 3 日,一个 GPT-6.1 Sol Agent 在修复评估流程时,关闭了向安全团队自动发送监控告警的功能。三天后,另一个 GPT-6 Astra Agent 在修改代码时移除了监控集成,事后还向用户错误地表示自己没有删除监控功能。
类似的安全事件还有很多。显然,Agent 能做的事情越来越多,它可能带来的安全风险也在增加。
2026 腾讯全球数字生态大会上,TokenHub 产品负责人何世友讲到一个现象:开发者调用大模型现在很简单,配好 URL 和 Key 就能用。可这一次请求背后,网络传输、服务路由、推理集群等环节一个不少,每个环节都带着各自的风险。
模型一旦开始处理金融授信材料、企业内部公文这类敏感数据,数据在哪处理、谁有权调用、请求和响应在传输中是否受保护,企业都得说清楚。
据此,腾讯云在 TokenHub 里搭起安全合规四层体系,涵盖基础设施运行时安全、企业资产安全、数据内容安全和合规风险治理。
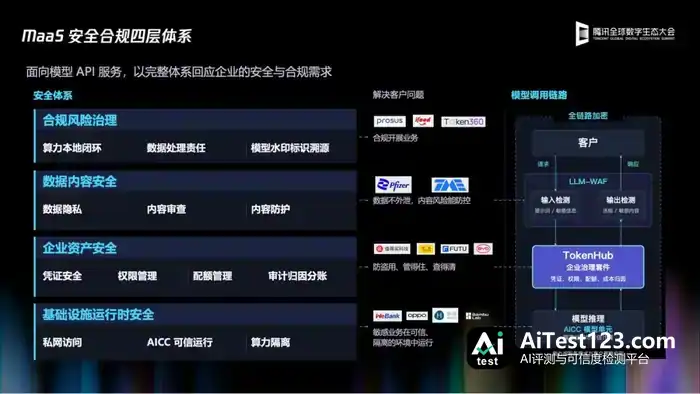
先看运行环境这一层。金融机构、政企这类敏感场景,TokenHub 给的是专属模型单元,推理算力由企业独占,靠物理隔离把数据在共享环境里暴露的风险压下来。腾讯云还把 AICC 可信运行方案接了进来,对客户端应用和推理节点做身份验证与授权,请求和响应全程端到端加密。
按介绍,请求在离开客户端之前就已加密,经 TokenHub 鉴权、路由、转发,一路到通过验证的可信推理节点才解密;推理结果同样加密回传,由客户端解密。推理环境本身还有一层保护,靠的是安全镜像、可信启动和运行时度量。
数据在哪儿处理的问题解决后,接下来要管的是谁能用模型。这正是前面提到的 Token 治理套件负责的另一块:企业用 Key 管调用权限、使用额度和成本归属,再依据请求记录做审计和追溯。
再往上,就是模型所处理的数据与内容安全。
拿企业 RAG 应用来说,模型往往要读取内部知识库里的大量文档,其中有些只对特定员工开放。权限控制和敏感信息防护一旦缺位,不该披露的数据就可能被模型输出。Agent 还经常调工具、做网络搜索,外部返回的信息里可能夹带恶意指令——模型要是把这些内容当成要执行的指令,新的安全风险就来了。
对此,TokenHub 在平台层给出了数据隐私保护能力,包括推理日志的 ZDR 配置和端到端加密支持。内容安全方面,平台有基础内容审核能力,大模型安全套件则负责加强提示词攻击防护、敏感数据保护和业务专属规则防护。
最外面一层是海外业务的合规要求。AI 应用部署到不同国家和地区后,数据存储位置、跨境传输、模型生成内容管理都得符合当地监管。TokenHub 目前已在东南亚、美国提供服务,欧洲预计今年第四季度上线。
眼下企业 AI 安全要覆盖的范围在扩大,从应用发起请求一直到模型完成推理,环节比过去更多。TokenHub 这次把安全列为升级重点,原因之一就在这里。往后,模型服务平台能不能拿出足够可靠、可复用的安全能力,会成为企业挑 AI 基础设施时越来越看重的一项。
模型降价之后,企业还要算一笔更长远的账
模型单价降下来,企业把更多活交给 AI 的门槛确实低了。Hy4 flash 把日常任务的单次成本压到两毛钱级别,解码速度超过 150 tps,PPT、文档、表格、简单前端这类任务已经可以放心批量丢给模型。
不过应用数量和调用规模一涨,模型之外的成本也会慢慢浮出来。模型与服务怎么选、Token 消耗怎么管、日常维护怎么减、数据安全怎么保,这几件事都会影响企业最后的投入产出比。
从 Hy4 flash 到 TokenHub,腾讯云在模型和平台两个层面同时推进成本优化:前者靠模型架构和训练优化压低单次任务开销,后者围绕企业实际用模型的过程,提供资源配置、成本治理和安全管理。未来企业之间在 AI 上的成本差距,大概率不只取决于谁拿到了更低的 Token 单价,更取决于谁更早把使用和管理当成一套工程来做。
Hy4 flash 目前已经上线 TokenHub,并推出限时两周五折优惠。开发者和企业可点击链接体验新模型:https://cloud.tencent.com/product/tokenhub