苹果开源FastFrames系列:单卡36毫秒生成480P视频

资讯 智东西 作者:孙 小雯 全文 4697 字 · 约 12 分钟读完 配图 15 张 分类开源视频生成

主打低延迟480P视频生成。

所属频道 开源生态视频图像生成
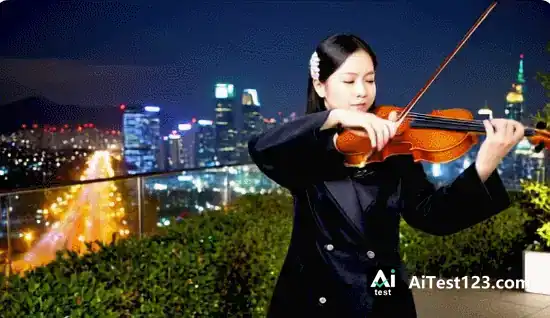
苹果开源FastFrames系列:单卡36毫秒生成480P视频(配图 1)

11月18日,苹果把面向实时交互的视频生成模型FastFrames系列开源了,一共两款:13亿参数的FastFrames-S和140亿参数的FastFrames-L。它们瞄准的是视频生成研究人员和交互应用开发者,主攻低延迟480P视频生成。

按苹果公布的测试数据,FastFrames-S在单张英伟达B200 GPU上生成延迟为36毫秒;生成质量与其基础模型Causal Forcing++接近,速度却达到后者的约7.6倍。FastFrames-L的生成效果与同样基于通义万相Wan2.1-14B开发的实时视频模型Krea-Realtime相当,单卡速度约为后者的10.6倍;换成8张B200,延迟还能进一步降到45毫秒。

▲苹果公布的生成质量与延迟对比(图源:苹果)

苹果开源两大视频生成模型!单卡延迟36毫秒,技术秘籍还能给别家模型提速

这套加速办法能不能用到别的模型上?苹果挑了两款外部模型做验证。蚂蚁灵波团队的LingBot 1.3B优化后,响应速度约为原版的16倍;斯坦福大学等团队的RealWonder优化后,响应速度约为原版的22倍。

两款FastFrames模型的提速训练路径并不一样。S版冻结Causal Forcing++基础生成器的权重,另外训练两个网络,分别负责画面输出和历史信息处理。L版先对阿里通义万相Wan2.1-14B做蒸馏,让它能用更少步骤连续生成后续画面,再训练上述配套网络。

从案例效果看,两款模型生成的画面质感和光影都算细腻。但S版部分案例出现了文字乱码、提示词理解偏差、画面不够稳定的问题。官方给出的女孩拉小提琴案例里,S版细节处理较粗糙,琴弓明显偏离琴弦,女孩面部还随着琴弓来回移动出现变形。L版在人物面部和演奏动作上则稳得多。

▲FastFrames-S生成的女孩拉小提琴视频(图源:苹果)

苹果开源两大视频生成模型!单卡延迟36毫秒,技术秘籍还能给别家模型提速

▲FastFrames-L生成的女孩拉小提琴视频(图源:苹果)

苹果开源两大视频生成模型!单卡延迟36毫秒,技术秘籍还能给别家模型提速

开发者现在可以从Hugging Face下载FastFrames模型权重,配合GitHub代码,在搭载英伟达GPU的Linux设备上跑文生视频任务。苹果同时公开了训练和评测工具,供开发者继续训练、复现实验。权重免费下载,许可限定为非商业科研用途。

GitHub代码仓库: https://github.com/apple-aiml-research/ml-fastframes

Hugging Face开源地址: FastFrames-S:https://huggingface.co/apple/FastFrames-S FastFrames-L:https://huggingface.co/apple/FastFrames-L

一、沙滩写字、羊驼跳舞,S版瑕疵偏多,L版生成更细腻

技术报告地址:
https://apple-aiml-research.github.io/ml-fastframes/

苹果在官方项目页公开了22组文生视频对比,展示FastFrames-S、FastFrames-L及对应对照模型的输出,覆盖文字生成、动物动作和人物场景等任务。

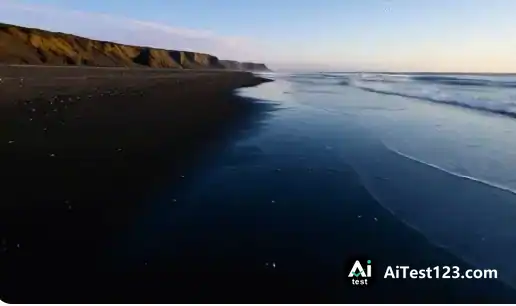
文字生成案例里,提示词要求镜头从空中下降到黑沙滩,海浪泡沫在沙面形成“STAY CURIOUS”字样,并在海水流动时保持文字清晰可读。S版生成的文字出现乱码;L版文字准确清晰,光照、阴影和构图也更精致。

▲FastFrames-S生成的海浪文字视频(图源:苹果)
苹果开源两大视频生成模型!单卡延迟36毫秒,技术秘籍还能给别家模型提速

▲FastFrames-L生成的海浪文字视频(图源:苹果)

苹果开源两大视频生成模型!单卡延迟36毫秒,技术秘籍还能给别家模型提速

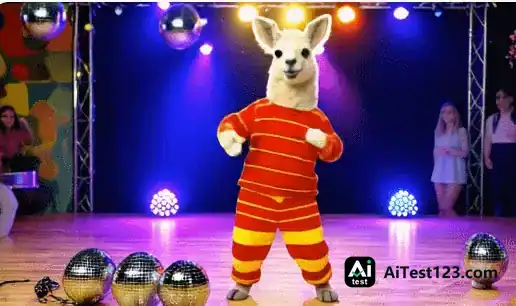
动物动作案例的提示词是:一只穿彩色睡衣的羊驼在舞台上跳舞,腿部和尾巴随动作摆动。这组视频用来对照两款模型对动物动作、服装和身体关系的处理。两款模型对“跳舞”指令的理解不同:S版把羊驼做成双腿站立的拟人形象,让它挥动前肢、左右摆身,舞蹈动作更明显;L版保留羊驼四足着地的体态,毛发和睡衣纹理更清楚,但动作主要是抬起前腿、原地踏步,幅度较小。

▲FastFrames-S生成的羊驼跳舞视频(图源:苹果)
苹果开源两大视频生成模型!单卡延迟36毫秒,技术秘籍还能给别家模型提速

▲FastFrames-L生成的羊驼跳舞视频(图源:苹果)

苹果开源两大视频生成模型!单卡延迟36毫秒,技术秘籍还能给别家模型提速

人物场景案例的提示词要求咖啡馆中的女子缓慢搅拌咖啡,随后看向窗外微笑,镜头先靠近面部、再拉远,呈现咖啡蒸汽、室内灯光和窗外雨景。S版和L版都理解了需求,但S版人物发质纹理还原不够细腻,整体光感也不够自然;L版更符合真实场景中的光学环境。

▲FastFrames-S生成的咖啡馆人物视频(图源:苹果)

苹果开源两大视频生成模型!单卡延迟36毫秒,技术秘籍还能给别家模型提速

▲FastFrames-L生成的咖啡馆人物视频(图源:苹果)

苹果开源两大视频生成模型!单卡延迟36毫秒,技术秘籍还能给别家模型提速

二、苹果将加速方法用于其他模型,提速后最高可达原版22倍

苹果另外选择了两款外部模型进行优化,以检验这套加速方法是否可推及其他模型。其中,蚂蚁灵波团队的LingBot 1.3B经优化后,响应速度约为原版的16倍。斯坦福大学等团队的RealWonder经优化后,响应速度约为原版的22倍。

苹果把FastFrames的加速方法搬到了其他团队已有的模型上,用来检验镜头控制、物理交互两类场景的响应表现。测试对象有两个:蚂蚁灵波团队的世界模型LingBot 1.3B,以及斯坦福大学等团队的物理交互视频生成系统RealWonder。S、L两款新模型的生成效果此前已经展示过。

加速效果的验证先从LingBot 1.3B开始。屏幕左右两侧并排跑原版和加速版,同一时间接收同一组键盘输入。操作者先在巨石阵里往前走、转动视角,接着切到石砌走廊,一直按住前进键。加速版画面更新更快,镜头跟着操作连续向前推进。

苹果开源两大视频生成模型!单卡延迟36毫秒,技术秘籍还能给别家模型提速

▲LingBot 1.3B加速前后的巨石阵导航对比,左为原版,右为加速版(图源:苹果)

苹果开源两大视频生成模型!单卡延迟36毫秒,技术秘籍还能给别家模型提速

▲LingBot 1.3B加速前后的走廊导航对比,左为原版,右为加速版(图源:苹果)

苹果给出的数字是:LingBot 1.3B的生成延迟从原版最快官方配置的842毫秒降到52毫秒,响应速度约为原来的16倍。两种配置分别用2张、8张B200 GPU。

RealWonder的测试里,物体响应速度提升更明显。操作者拖动水面上的灯笼,系统随即生成灯笼移动和水面变化的画面。苹果给它加了更快的画面解码、缓存修正网络,又调整了计算执行方式。生成延迟从原版单张B200上的1141毫秒,降到加速版8张B200上的51毫秒,约为原版的22倍。

苹果开源两大视频生成模型!单卡延迟36毫秒,技术秘籍还能给别家模型提速

▲RealWonder加速前后的灯笼拖拽对比,左为原版,右为加速版(图源:苹果)

三、更换解码器、修正缓存、优化GPU计算,苹果三招降低延迟

S、L两款模型的降延迟工作落在三处:换轻量解码器让画面出得更快,用小网络压掉更新历史信息时的重复计算,再重新安排GPU上的计算。

动手之前,苹果先拆了S版基础模型Causal Forcing++生成视频的耗时。单张B200上,它每生成一组画面约需272毫秒。其中两步去噪占83.2毫秒,缓存更新41.6毫秒,画面解码147毫秒。解码加缓存更新,合起来约占这组画面总耗时的69%。

苹果开源两大视频生成模型!单卡延迟36毫秒,技术秘籍还能给别家模型提速

▲Causal Forcing++生成流程及耗时(图源:苹果)

第一项优化冲着最费时的画面解码去。原来的VAE解码器得反复放大内部特征,在越来越高的分辨率下算,才能吐出完整画面。苹果先试了一层简单计算直接输出像素,画面内容看得出来,细节却糊。

团队随后往上加处理层,做出轻量像素解码器。主要计算放在低分辨率下完成,最后一次性输出完整画面,高分辨率计算少了,头发、雨滴这类细节还留得住。以S版为例,解码耗时从147毫秒降到约1毫秒。

第二项优化针对缓存更新。后续画面要接得上,模型就得存住前面生成的内容。原流程每生成一组画面,都要额外跑一次完整的生成网络,把这组画面的缓存信息整理出来。

苹果改成复用最后一步去噪已经算出的缓存,再用小网络修正,额外跑完整生成网络的开销就省了。S版缓存更新耗时从41.6毫秒降到约2毫秒,L版降到约6毫秒,速度分别约为原流程的20倍、12倍。

第三项优化是让GPU多扛并行计算。视频逐步生成时,每次新增的画面内容不多,GPU算力可能吃不饱。苹果把历史缓存分段,各段同时计算,再合并结果。L版模型上缓存分成5段,单次生成网络计算的延迟降低约13%。

苹果还提前算好反复使用的位置编码、提示词等信息,并把部分原本分开的运算合并。这一轮调整后,S版单次去噪网络计算耗时从41.6毫秒降到16.4毫秒,L版从89.2毫秒降到75.6毫秒。

8卡配置下,苹果把画面内容分给不同GPU,一起完成生成网络的计算。S、L两版的单次去噪网络计算耗时进一步降到5.8毫秒、20.3毫秒。

苹果开源两大视频生成模型!单卡延迟36毫秒,技术秘籍还能给别家模型提速

▲FastFrames-S优化后的生成流程及耗时(图源:苹果)

四、1万条真实视频进行对抗训练,L版对Wan2.1-14B进行蒸馏

训练上两款模型分工不同。S版手里已有能用两步去噪生成画面的基础模型,训练重点放在更快的画面输出和缓存处理模块。L版得先把Wan2.1-14B训练成两步生成器,再配齐相应模块。

训练S版解码器时,Causal Forcing++生成器的权重保持不变,由原生成器和VAE解码器出示范,新解码器学着输出同样的画面。团队生成了约15万轮示范,每轮做4次参数更新,合计约60万次。这一阶段用32张B200,耗时约一周。

之后苹果掺入1万条真实视频做对抗训练,让新解码器生成的画面更清晰、更贴近真实视频。该阶段用8张B200,耗时数小时。S版缓存修正网络则学习原生成网络更新后的缓存,用32张B200,做了14.25万次参数更新。

训练和运行优化都完成后,S版生成速度约为基础模型的7.6倍。评估画面质量、内容是否符合提示词的VBench测试里,S版总分84.23,基础模型84.11,整体表现基本持平。

为了让L版能参照前序画面续写后续内容,苹果先改了Wan2.1-14B的生成方式。做法是先用Wan2.1做48步采样生成示范,把噪声一步步变成画面的过程记录下来;再拿256张B200训练教师模型,供后面的蒸馏学习使用。团队挑中第1700次参数更新的教师模型,投入128张B200做一致性蒸馏,目标是让新模型用更少的去噪步骤,产出接近教师模型的画面。之后又选了第3000次更新的权重,同样用128张B200做分布匹配蒸馏——模型在自己生成的画面上接着练,把连续生成的效果往好里调,两步生成器就是这样得来的。

解码器这块,苹果从S版的解码器权重起步,用64张B200跑了50万次参数更新,让L版解码器学会还原画面,再上8张B200做对抗训练。L版的缓存修正网络则动用64张B200,完成14.25万次参数更新。

训练和运行优化都做完之后,L版的单卡速度大约是同规模模型Krea-Realtime的10.6倍。两者VBench总分分别是84.44和84.42,生成的视频质量相当接近。

结语:实时交互三大难,苹果发力低延迟,加速方案可复用

做实时交互视频模型,绕不开三道坎:用户操作输入后,画面能不能及时跟上;指令连续变化时,模型能不能准确执行,并把人物和场景稳住;长时间运行、同时服务多名用户,算力成本扛不扛得住。苹果这次重点压缩的是画面生成前的等待时间。FastFrames从画面解码、缓存更新和GPU计算三处下手改造,让现有视频模型更快吐画面,加速效果已在LingBot和RealWonder上做过验证。对交互应用开发者来说,这套方法可以拿来复用;对用户来说,画面反馈更及时,连续调整镜头、动作和场景时能少等一会儿,也少返工几回。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 英伟达临时CEO首秀:开源AI战略与Hugging Face收购不变

    英伟达创始人兼CEO黄仁勋突然离职后,公司临时CEO首次公开表态,重申开源AI战略保持完整,并确认仍计划收购AI模型托管平台Hugging Face。分析认为,作为“卖铲人”的英伟达与开源生态利益高度绑定;不过,黄仁勋离场带来的战略连续性问题,以及收购可能面临的反垄断审查,仍是外界关注的焦点。

    来源 AI 科技快讯
  2. Hugging Face遭AI代理攻击后,CEO为何反而力推开源

    Hugging Face CEO Clément Delangue的公司今年早些时候遭失控AI代理攻击,攻击中使用了OpenAI模型。外界以为他会收紧控制,他却公开为开源辩护:AI能力若集中于少数公司,整个人类都将更脆弱。这场事件把开源与安全的长期争论推向新高度。

    来源 AI 科技快讯
  3. Garlic LLM 让越狱 PS4 跑起 90 亿参数模型:最高每秒 43 词元

    科技媒体 Gigazine 今天(11 月 17 日)发布博文,报道称开源项目 Garlic LLM 可以让越狱版 PlayStation 4 运行 90 亿参数的本地大语言模型,最高生成速度可达每秒 43 个词元(Token),且无需联网即可完成 AI 聊天与语音对话。

    来源 IT之家
  4. 反超谷歌王牌模型,决策新王拿下全球榜首,全尺寸开源

    硅谷最卷的新赛道,刚刚杀出了一位开源新王! 最近,即将敲钟的Anthropic在IPO材料中曝出天价算力缺口,给狂卷参数的AI行业当头浇下一盆冷水。 通用大模型虽在编程、数学上大杀四方,可一旦真替人干活,算力账单就成了无底洞。 比生成文本更耗Token的是长链推理,而比推理更烧钱的则是操作浏览器,单次平均开销比复杂推理

    来源 AI 行业观察
  5. 英伟达份额降至28%,摩根大通称CUDA壁垒正被AI攻破

    摩根大通指出,英伟达在2026年算力协议中份额仅剩28%,AMD、谷歌TPU等竞品强势崛起;与此同时,CUDA护城河三天被AI攻破。开源市场则遭遇监管收紧,出口合规风险上升。尽管英伟达当前估值具备吸引力,但支撑高增速预期的两大引擎均已动摇。

    来源 华尔街见闻
  6. 黄仁勋请愿超11.5万签名:英伟达开源与「认知永生」治理难题

    MIT Technology Review《The Download》报道,一份要求黄仁勋回归英伟达CEO岗位的请愿已获逾11.5万签名,包括马斯克,但名单真实性仍待甄别。事件折射AI开源与闭源生态的张力;同日通讯还关注“认知永生”,即用AI模拟人格、延续数字存在的技术与伦理议题。

    来源 AI 科技快讯
  7. 腾讯LightVela实测:多Bot加云电脑,云端个人助理能干什么?

    很奇怪,一款几个月前上线的AI产品,为什么又受到了很多人的关注。 最近这段时间,腾讯的云端AI Agent产品LightVela重新出现在不少人的视线范围内。实际上,LightVela早在今年4月就开启了公测,并在9月底正式面向所有用户开放。 最初,LightVela主要是将开源Hermes Agent搬上云端,让用户

    来源 AI 行业观察
  8. RK3668处理器:6nm工艺,2027Q1出工程样品

    IT之家 11 月 18 日消息,根据开源硬件制造商 Radxa(瑞莎)分享的文档,瑞芯微计划于 2027 年第 1 季度交付下代通用处理器 RK3668 的样品。RK3668 将采用 6nm 制程工艺,CPU 集成 6 个 Arm Cortex-A725、2 个 Arm Cortex-A520,搭配 Arm Mali

    来源 腾讯网
  9. 蚂蚁灵波开源触觉模型LingBot-Touch:不做本体,通用底座值多少钱?

    (本文作者为 AIX财经,钛媒体经授权发布)文 | AIX财经,作者 | 王璐,编辑 | 魏佳具身智能赛道已经从大脑卷到了手指尖。11月10日,蚂蚁集团旗下的蚂蚁灵波科技(以下简称蚂蚁灵波)发布并开源触觉基础模型LingBot-Touch。它能将不同信号转化为同一套触觉表征,让机器人积累的“手感”在不同传感器、灵巧手、

    来源 腾讯网
  10. 摩根大通:英伟达2026年后算力份额仅28%,CUDA壁垒正被AI攻破

    英伟达正面临来自两端的结构性压力,而这与创始人黄仁勋的离任同等重要,甚至可能更为深远。摩根大通策略师Michael Cembalest在最新研报《英伟达与AI的下一步》中指出,前沿AI实验室正将采购重心向AMD、谷歌、亚马逊等多家供应商分散,英伟达在2026年后计算协议中的份额仅占28%。与此同时,开源模型生态圈则面临

    来源 腾讯网
  11. 黄仁勋请愿超11.5万签名:英伟达开源与算力权力之争

    MIT Technology Review《The Download》报道,一份要求黄仁勋回归英伟达CEO岗位的请愿已获逾11.5万签名,包括马斯克,但名单真实性仍待甄别。事件折射AI开源与闭源生态的张力;同日通讯还关注“认知永生”,即用AI模拟人格、延续数字存在的技术与伦理议题。

    来源 AI 行业观察
  12. 腾讯开源Hy4flash:224B参数,三个版本可下载

    腾讯混元官宣开源Hy4flash系列,含标准版、FP8量化版及可从零训练的Base版,GitHub、Hugging Face、ModelScope、GitCode均可下载,并提供GGUF格式便于本地部署。官方预告更大Hy4模型也将开源。该模型走性价比路线,总参224B,含64B Engram参数。

    来源 AI 产业速递
  13. 腾讯混元Hy4 flash开源:2200亿参数、百万Token上下文

    11月18日,腾讯混元宣布开放Hy4 flash系列模型权重,包括Hy4 flash、Hy4 flash-FP8和Hy4 flash-base,相关模型及部署资料已上线GitHub、Hugging Face、ModelScope和GitCode。该模型总参数约2200亿,采用混合专家架构,上下文窗口最高可达100万To

    来源 凤凰科技
  14. 腾讯混元开源 Hy4flash:224B 参数、100 万上下文,多款产品已接入

    腾讯混元2026年11月18日宣布开源Hy4flash模型,主打极致性价比。此次开源含Hy4flash、Hy4flash-FP8、Hy4flash Base三个版本,形成家族矩阵,并支持多渠道便捷部署。为方便全球开发者快速上手与二次开发,腾讯同步开放多个主流代码渠道,助力AI开源生态。

    来源 AI 产业速递
  15. 亚马逊云科技开源File Mover Express:加速本地与S3大文件互传

    最近,亚马逊云科技发布了 File Mover Express,这是一款基于 Apache 2.0 许可的开源应用程序,用于在本地系统与 Amazon S3 之间传输大文件。该工具支持 macOS、Windows 和 Linux 系统,具备并行传输、自动性能调优、重试、暂停和恢复以及文件完整性验证等功能。 File M

    来源 AI 行业观察
  16. 华为云开源CloudRobo-WM1.2:两榜单均列第一

    华为云在杭州发布并开源昇腾原生具身世界模型CloudRobo-WM1.2,采用共享世界模型骨干网络和原生DualAct架构实现动作生成。官方评测显示,其在RoboTwin2.0平均得分88.98%、LiberoPro2.0平均得分81.7%,均位列第一,并围绕世界建模、动作生成等构建五项核心技术。

    来源 凤凰科技
  17. 谷歌开源FashionMind:用全双工语音实现零延迟AI试衣

    Google 开源了 FashionMind,这是一个基于 Gemini Live 2.5 Flash 的实时语音时尚助手。它最大的特点是“快”和“自然”:通过全双工音频流和本地打断技术,用户说话时助手能即时响应,无需等待;商品推荐直接注入上下文,消除了传统工具调用带来的十几秒冷场。此外,它还采用了三层记忆架构,既能记

    来源 AI 应用前沿
  18. 6.3亿参数模型实时生成GTA画面:Summaryformer如何省显存

    Abhishek Sensharma开源了一个能在浏览器里跑的GTA V世界模型。没有游戏引擎,全靠6.3亿参数的Transformer逐帧生成。文章重点拆解了名为Summaryformer的架构,特别是它如何通过“摘要Token”和旋转位置编码来解决长序列显存爆炸的问题。代码和权重已公开,适合对视频生成底层机制感兴趣

    来源 AI 应用前沿
  19. Suno推Visuals视频生成:15秒音画对口型,底层用MiniMax的H3

    财联社11月18日讯(编辑 史正丞)在众多AI生成作品背后默默“配乐”的知名AI音乐生成工具Suno周二宣布,正式将产品线扩展至视频生成赛道,将AI生成歌曲、画面与音画对口型纳入同一创作流程。(来源:公司官网)从生成歌曲,到让画面、口型跟音乐一起走根据公告,Suno新推出的视觉创作工具叫Visuals。Visuals针

    来源 腾讯网
  20. DeepSeek Harness 实战:从零搭建你的第一个 AI Agent 工作流

    DeepSeek Harness (dsh) 是一款开源的 Agent 运行框架,它让 AI 能够直接操作你的本地文件系统和终端。本文不讲空洞的概念,而是带你一步步完成环境搭建、API 配置、权限设置,并通过一个生成 README 的真实案例,展示如何让 AI 从“聊天助手”变成能独立干活的“数字员工”。适合希望提升开

    来源 AI 应用前沿
  21. 浙大与宇树开源500万条机器人预训练数据:总时长超1万小时

    浙江大学与宇树科技具身智能联合实验室等团队从海量互联网人类视频中构建并开源了预训练数据集 Movens-5M,收录 500 万条经仿真执行验证的机器人动作,总时长超过 1 万小时。数据集覆盖行走、深蹲、拖地、拳击等 297 种细分动作,涵盖居家生活、健身训练、户外休闲等 16 类场景。团队将文字指令、视频示范、语音和音

    来源 腾讯网
向下滚动自动加载更多