谷歌不到50天连发4款Gemini 4模型,Neon同日开放Genie 4
OpenAI却有点拉了。
OpenAI时隔75天端出的顶级模型刚亮相,社区吐槽就炸了锅。有人说新模型“几乎没法用”,有人嫌它过分谨慎、难以指挥,还有人觉得它解释自己的工作像在“说外星话”。
甚至有漫画拿GPT-6.2 Astra的语言风格玩梗,讽刺其防御过当。前·赛博义父Tibo在X上透露,关于模型语言风格的反馈他已经收到,OpenAI正在想办法改进这一点。
评论区里,已经有人表态准备弃用OpenAI、转投 Gemini。
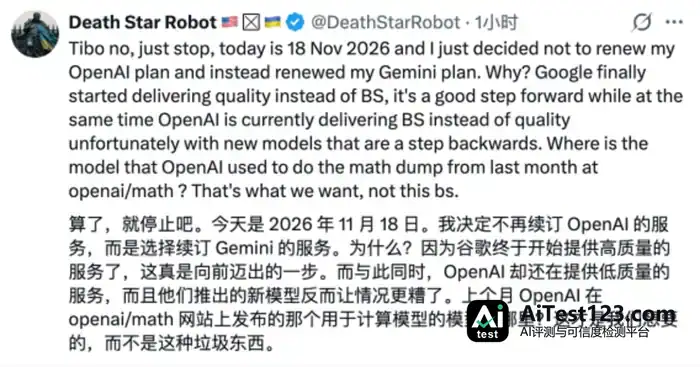
谷歌近来的势头确实凶猛。美国时间11月18日,Gemini 4 Neon(氖/霓虹)正式发布。9月底的Argon(氩)、10月底的Carbon(碳),再加上六天前刚登场的Hydrogen(氢),不到50天,这已是谷歌推出的第四款Gemini 4模型。

谷歌公布的测试结果显示,Neon在编程、办公自动化、科学推理、多模态理解、长上下文等多个领域,几乎全面压过Opus 5.5和刚推出的GPT-6.2 Sol。
同一天,谷歌还宣布向部分付费用户开放世界模型 Genie 4。用户能在浏览器里直接生成并进入虚拟世界,探索过程中还能改天气、加角色,场景和声音随之变化。
两相对比,这一轮我站谷歌。
Gemini迭代有点快
发布Gemini 4 Neon之前,谷歌AI团队成员在社区开了个玩笑:“咱们这么赶着把这些产品都发出去,就是为了腾出时间玩《GTA 6》,对吧?”

甚至在Neon正式发布后,还有谷歌高管专门提醒网友:“赶在《GTA 6》发布前,快来试试吧。”

GPT 6.2表现不咋地,但GTA6可是相当精彩。敢在这两个“大动作”之间把模型发出来,想来谷歌对自家模型还是有信心的。
Neon确实不差。Artificial Analysis综合智能评测中,它拿到61分,超过Claude Opus 5.5的59分和GPT-6.2 Sol的57分,甚至超过了“上一级”Carbon的60分。不过这个61分来自最高思考强度Xhigh,Carbon的60分对应的则是High档;若都用High档,两款模型同为60分。

谷歌公布的模型卡显示,Neon在Carbon基础上适配而来,定位很明确:性能接近旗舰的同时,把执行速度提上去、使用成本压下来。
官方数据称,在默认的High思考档位下,Neon完成同类评测任务的平均成本比Carbon低32%。它还提供四档思考强度,用户可按任务难度自行权衡成本与速度。
这里的成本优势说的是完成任务的平均花费。Neon目前的API价格为每百万输入Token 3美元、输出Token 15美元,论单价要比仍处于促销期的Carbon贵一些。
综合跑分之外,Zapier的办公自动化测试AutomationBench中,Neon拿下56.3%,超过Claude Opus 5.5的42.5%和GPT-6.2 Sol的41.3%。这项测试要求AI独立跑完真实业务流程,包括操作软件、处理数据、跨应用执行任务等,多少能反映Agent的实际工作能力。
考察长期任务执行能力的Vending-Bench 2测试里,Neon同样出色。它要独立经营一家模拟自动售货机,处理采购、补货、定价、供应商谈判等事务。模拟运营一年后,Neon最终留下平均16,843美元的账户余额。
编程方面,Neon在Artificial Analysis Coding Agent Index中拿到58.6分,以微妙的差距胜过了Fable 5.2。

但Neon并不是样样都赢。谷歌自己晒出的成绩单里,Claude Opus 5.5在两项编程测试上仍稍占上风:Terminal-Bench 4.1拿到65.8%,Neon是65.2%;FrontierCode 2.0则是47.3%对46.2%。
眼下Neon已向Gemini App的Pro和Ultra订阅用户开放,开发者想用的话,可以走Google AI Studio、Gemini API和Antigravity三个入口。
在Antigravity里,Neon还多了一个身份——任务协调者:它负责规划、统筹和检查结果,具体活儿分给多个Hydrogen子Agent并行去干。这套协作机制早先在Carbon和Hydrogen之间已经跑通,现在Neon也接了进来。
按谷歌的说法,新模型处理PDF、电子表格、图片这类不同格式的材料更顺手,能结合Gmail、Docs里的信息做报告,也能应付更复杂的多步骤Tasks任务。
从最高端的复杂推理,到简单任务,再到要兼顾性能和成本的Agent工作,谷歌给不同模型划出的分工越来越清晰。
而且,49天里谷歌一口气推出了四款Gemini 4模型。
9月30日Gemini 4 Argon发布,10月28日Carbon接棒,11月12日Hydrogen登场,11月18日又来了Neon。
四款模型接连亮相,不等于谷歌在49天里从头造出了四套完全不同的东西。谷歌DeepMind公布的模型卡显示,Gemini 4系列的技术继承关系很清楚:Carbon基于Argon开发,Hydrogen和Neon又都是在Carbon基础上适配出来的。
后面的模型一路追赶甚至反超前代,最早登场的Argon就有点尴尬了——用户口碑还没攒起来,风头已经被后来的版本抢走。
现在Gemini App里,Neon已经顶替了Argon原来的位置。
谷歌还造了一个“世界”
说实在的,谷歌最近多少有点想当“造物主”的意思。
Argon是氩,Carbon是碳,Hydrogen是氢,Neon是氖……Gemini 4这一系列走的是“元素路线”。
表面看,这跟“文学”的Claude、“天体”的GPT能凑到一桌,可直观程度不如那两家。几乎每场模型发布贴下面都有网友吐槽“看不出和模型性能有什么关系”,还有人调侃“是不是有朝一日要把元素周期表占满”。
(这个梗谷歌自己也玩。现在打开Google AI Studio,真多了一个能在元素周期表里挑模型的互动界面。)

光在元素周期表上点名还不够。就在Neon发布同一天,谷歌宣布向部分付费用户开放世界模型Genie 4,用户可以直接生成并进入一个AI创造的虚拟世界。
Genie 4其实10月27日就亮过相,之前主要给受邀测试者做研究预览。现在它从封闭测试走向普通消费者,开放给符合条件的Google AI Ultra订阅用户,Pro会员可以进等待名单。
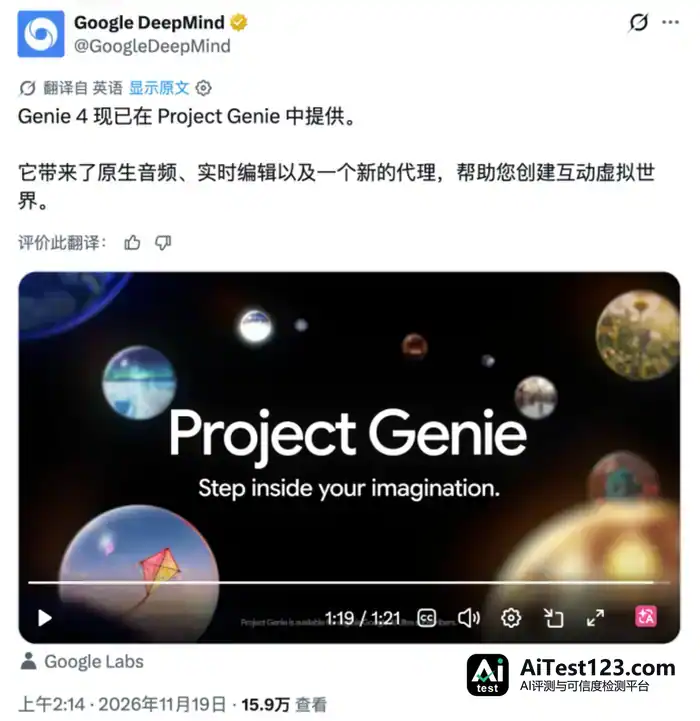
输入文字或图片,Genie 4就能实时生成一个可自由探索、互动的虚拟环境。用户用键盘和鼠标在场景里移动,也能随时敲入新指令,改天气、加角色,甚至调整接下来发生的事件。
声音也是同时生成的——环境里的风声、水声,角色之间的对话,都会跟着场景变化实时调整。
模型卡显示,Genie 4能实时生成最高720p、每秒24帧的画面,并带同步音频。


这次更新还多了一个专门帮用户设计虚拟世界的Agent(Project Genie Agent)。用户像聊天一样描述想要的场景,它就帮忙设计画面风格、搭配背景音乐。
进了虚拟世界,用户还能拉Gemini一起探索。它会观察当前画面,建议接下来去哪、做什么,甚至根据探索过程触发新事件。
谷歌还搭了社区画廊,用户可以浏览、修改、分享别人做的虚拟世界。

跟上一代Genie 3比,Genie 4在画面真实感、物理模拟和交互能力上进步比较明显。但它离真正成熟的开放世界还差得远。谷歌承认,长时间运行、频繁修改场景时,Genie 4仍可能出现物体突然变化、空间细节不一致等问题,复杂物理交互也有待改善。
Genie 4能有这些长进,背后是别的技术在托着。谷歌DeepMind在10月的研究公告里说得很清楚,Genie 4的技术底子来自Gemini系列:画面和行为表现贴近现实,靠的是Gemini Omni;虚拟世界能保持连贯,则靠其他Gemini模型参与推理。
提到Gemini Omni,谷歌在视频模型上近来动作也不少。11月5日亮相的Gemini Omni 1.2 Flash,把单次视频生成的最长时长从10秒拉到15秒,角色和场景的一致性也提高了,生成价格还降了30%。
新版本在角色、场景、动作的连贯性上做了改善。用户能通过多轮对话反复改动视频里的背景、人物或镜头,原有画面的细节尽量留住,修改时画面错乱的情况也少了。

世界模型这条路线还有一个想象空间不小的用途:训练机器人。谷歌已经在试着把通用模型和世界模型凑到一起,用虚拟场景来模拟机器人的行动。
11月10日,谷歌DeepMind拿出Gemini Robotics 2.5,重点是让机器人能执行更复杂的操作,处理更多以前难以完成的精细任务。在与Apptronik、奔驰合作的一项实际生产线概念验证中,搭载Gemini Robotics 2.5的Apollo 2人形机器人可以自主把汽车零件从料箱里取出,再按生产需要放进指定容器。谷歌公布的结果是,这项试验的任务成功率达到了96%。
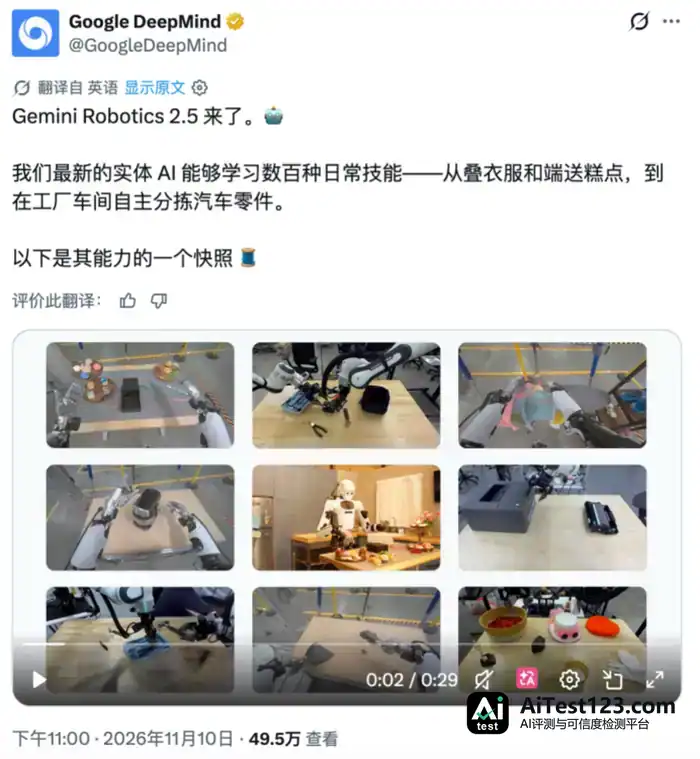
有意思的是,谷歌明确提到,Gemini 4 Argon在Robotics 2.5的研发过程中起了重要作用。研究人员用Argon生成大量模拟训练场景,让机器人在虚拟环境里练习操作,再根据实际任务失败的视频分析问题、尝试改进方案。10月27日发布的Genie 4研究演示中,谷歌还展示了Argon与Genie 4配合模拟人形机器人下跳棋的过程:Argon负责把任务拆成步骤,Genie 4实时生成对应的场景变化。

刚刚还因为模型更新太快而迅速让出旗舰位置的Argon,转头就成了另一项AI研究的帮手。这也让谷歌最近密集发布的这些模型,多了一层意义。
Gemini系列管推理与规划,Omni能生成视觉和声音,Genie试着模拟真实世界,Robotics则让AI进一步控制现实中的机器。不同的研究方向已经开始相互配合,甚至相互加速。谷歌同时在推进多个AI领域的技术研发,可要让这么庞大的研发体系持续运转,光有模型显然不够。
多年家底,开始发力
十多年前,谷歌就开始研发TPU(Tensor Processing Unit,张量处理单元),最初主要用在语音识别、机器翻译等内部业务上。如今TPU已经迭代到第八代,成了谷歌训练和运行Gemini系列模型的重要基础设施。
最近,谷歌连芯片也在加快更新。11月9日,谷歌一口气推出TPU 8tx和TPU 8i Max两套新系统。算上今年4月发布的TPU 8t和8i,谷歌在一年之内扩充了四套第八代TPU系统。
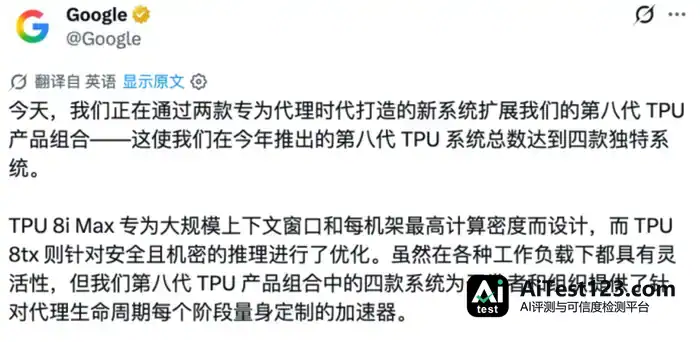
和Gemini 4系列类似,谷歌的TPU也开始明确分工。8t主要负责大规模模型训练,8i针对低延迟推理进行优化;新发布的8tx则专门加强机密计算能力,让企业在处理敏感数据时能更安全地运行AI模型。
8i Max 这边的做法,是把两颗 8i 芯片放进同一封装,算力、片上缓存和高带宽内存带宽都翻了一倍,瞄准的是超长上下文以及多个 Agent 协作带来的算力需求。
这么做也有现实考量。一颗芯片从设计走到量产,常常要花好几年,可AI模型的需求变得比这快得多。谷歌的办法是改封装、改内存、改网络和安全架构,从而更快拿出适配不同场景的计算系统。
谷歌公布的数据显示,TPU 8t的训练性能最高能到上一代产品的2.7倍;8i的推理性价比最高提升80%。
公告里还提到,下一代芯片的设计已经用上了DeepMind研发的AlphaChip和Gemini模型。有些芯片布局工作原本要花数周,现在被压缩到几个小时。
AI帮着设计芯片,芯片又反过来给更强的AI提供算力。一个加速的循环就这样转了起来。
谷歌如今的心思,已经不只是拿TPU训练自家模型。
10月20日,谷歌宣布开源TorchTPU。这项技术由谷歌与Meta的PyTorch团队共同开发,开发者可以用熟悉的PyTorch框架在谷歌TPU上训练和运行AI模型,不必为了换硬件而大规模重写代码。
过去用谷歌TPU,往往意味着还得去适应一套与英伟达GPU不同的软件环境。现在谷歌正在想办法把这笔迁移成本压下来。
11月9日谷歌透露,TPU业务已有接近100家客户,涵盖前沿AI实验室、金融机构、零售企业和大学等。
芯片和模型之外,谷歌手里还有庞大的现成产品体系,能让模型派上用场。最近发布的Hydrogen就是例子:模型几乎刚推出,就被带进了Gemini App和谷歌搜索。
新模型因此能不断进入谷歌已有的产品,直接触达原本就在用谷歌服务的用户。
说到产品体系,这段时间的“加速”,恐怕也和
谷歌DeepMind在8月5日完成了一次大调整。德米斯·哈萨比斯管了DeepMind多年,这次把日常管理权交了出去,改任DeepMind董事长兼Alphabet首席科学家;原首席技术官科拉伊·卡武库奥卢接手管理工作,直接向皮查伊汇报,手上管着Gemini模型开发、前沿AI研究以及相关产品团队。另一边,杰夫·迪恩、奥里奥尔·维尼亚尔斯等谷歌AI老将先后离开,自己出去创业。
那段时间,Gemini的新一代旗舰模型已经比原计划晚了两个月,一些内部测试的成绩还是落在对手后面。再加上几位核心研究员出走,外界不免猜测:谷歌是否打算不再死磕最强模型,把更多资源投向产品商业化。
至少从最近交出的成绩单来看,谷歌已经找到了状态,重新站稳了模型第一梯队。
10月28日,在Alphabet的财报电话会议上,CEO桑达尔·皮查伊提到,AI已经开始帮助谷歌加快模型训练和发布的速度。
他预计,接下来12个月,这种加速还会持续。
再回头看OpenAI,GPT-6.2 Astra的模型能力其实依然强悍,OpenAI也表示正在想办法改进被吐槽的语言风格。
社区里几天的差评,当然不足以说明OpenAI已经掉队。
但谷歌的AI,这回是真的支棱起来了。