2026全球AI芯片峰会上海落幕:60余位嘉宾谈Token与智能体算力
九年磨一“芯”,拆解AI算力产业真实变局。
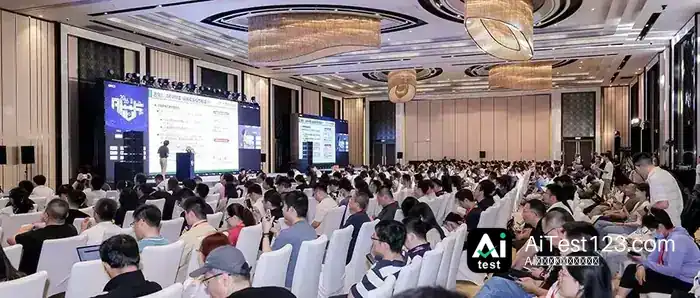
9月21日传来消息,2026全球AI芯片峰会已在上海收官。这场大会由智东西发起,智猩猩主办、芯东西协办,主题定为“芯路求索 聚力致远”,把从TOPS到Token的AI算力关键链路整个梳理了一遍。
两天时间里,60多位嘉宾分布在1场开幕式、3场论坛和5场闭门研讨会上,密集输出技术创新的进展、落地经验与产业走向,其中不少人还借机预告了即将发布的新品。议题紧扣AI芯片前沿,覆盖架构创新、3D堆叠、超节点、KV Cache、新型存储、Token工厂异构混训混推、大模型推理、智能体推理、具身智能推理等方向,现场来了超百家AI芯片生态企业的专业观众。
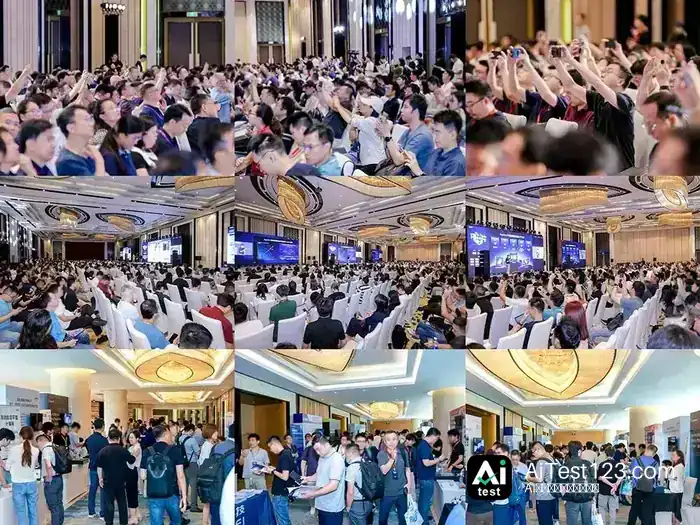
展区一侧,奎芯科技、芯来科技、Imagination、进迭时空、奇异摩尔、星融元、启芯宸光、科华数据、博伦智汇、硅芯科技、先进编译、恒瀚微电子、焱融科技等公司拿出了各自最新的技术产品方案。
智东西联合创始人兼CEO龚伦常在致辞中回忆:“九年前,我们在上海举办了首场全球AI芯片峰会。九年来,全球AI芯片峰会的足迹已遍布北京、深圳和上海。”他说,这也是团队持续关注整个AI领域的一个缩影。
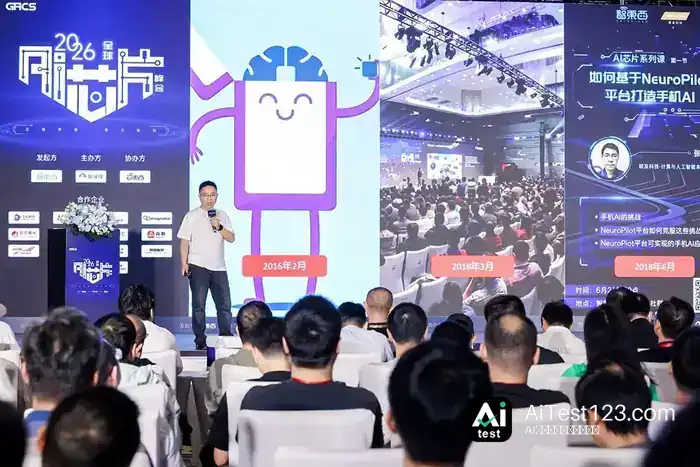
智东西联合创始人兼CEO龚伦常
开幕式以及3场高峰论坛——大模型AI芯片、Agent推理芯片、具身智能芯片——共有30位嘉宾登台,以下是他们分享内容的梳理,重点如下:
一、云端AI芯片论剑!高效算力呼唤新架构CPU杀回智能体时代焦点
智能体爆发之后,全球AI芯片产业格局一直在变:头部模型厂商深度介入芯片架构定制,云计算巨头几乎家家都在自研AI芯片,国产AI加速卡持续放量。算力运营的重心也挪了位置——从不计成本抢高端算力,转向围绕token成本和算力利用率做精细化运营。
大模型训推效率怎么靠技术创新提上去?智能体时代为什么需要“六边形”CPU?算力、内存、网络的瓶颈有哪些新解法?大模型又能怎样帮着提升芯片设计效率?开幕式上,5位演讲嘉宾围绕这些话题谈了各自的成果与思考。
1、中山大学王中风:把AI芯片算力用满,让大模型参与芯片设计
中山大学集成电路学院院长、IEEE/AAIA Fellow王中风谈的是大模型时代AI芯片的设计挑战与演进方向。眼下关键问题在于,怎么把硬件峰值算力变成模型部署时真正用得上的有效算力。为了做到高效部署,他的团队从压缩与量化技术入手压低数据开销,再靠软硬件协同把推理效率提上来。
在模型驱动芯片设计这条线上,王中风团队设计了视觉Mamba高效加速器、超低BitLLM推理加速器、多层次稀疏Transformer加速器,用来应对算子适配、存储调度、稀疏利用等难题;面向大模型辅助芯片设计自动化,他们又提出了性能感知GEMM Verilog生成设计、GEMM图-码转换多模态框架等方案。
王中风判断,提升AI有效算力的演进方向会落在模型、硬件与系统设计的协同创新上,具体包括探索更低比特的模型压缩与精度适配、把算子融合与数据重用放在一起优化、用部署反馈反过来驱动模型迭代。
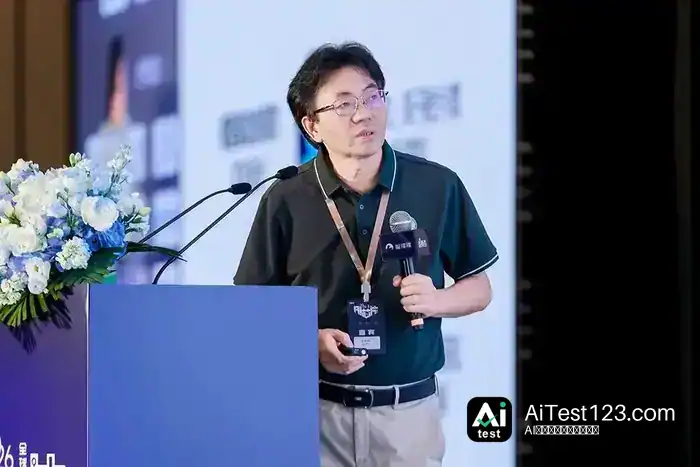
中山大学集成电路学院院长、IEEE/AAIA Fellow王中风
2、英特尔高宇:智能体时代,CPU重回C位
英特尔中国区技术部总经理高宇表示,智能体爆发把CPU、内存、SSD和隐私需求一并带了起来,CPU不再只是给GPU“打辅助”,而是重新回到AI算力体系的C位。
智能体跑起来是一个循环过程,主线程基本落在CPU上。上下文处理、调用大模型、权限检查、工具调用、结果处理这些环节,都得由CPU来管。
能扛住智能体的CPU,不能只拼单点性能,得是“六边形战士”:沙箱并发度、IPC和频率要更高,内存容量要更大,硬件加速和安全能力也不能缺。
高宇还提前透露,两天后的英特尔技术创新与产业生态大会(Intel Connection)上,英特尔会展示内置128张或192张Granite Rapids处理器的高密度CPU机柜设计,单机柜能承载5万个Agent同时并发运行。
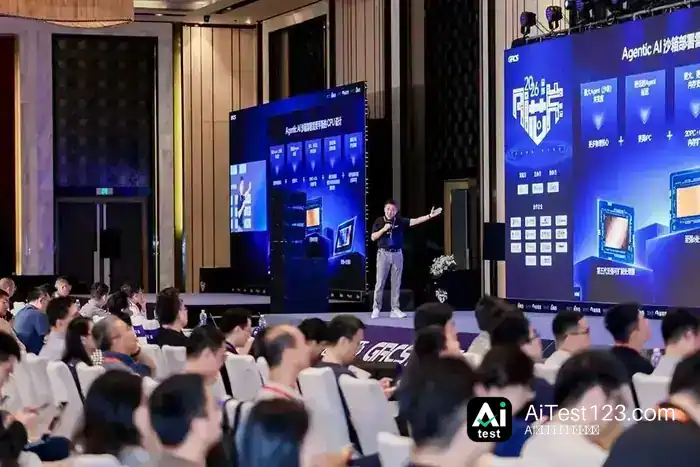
英特尔中国区技术部总经理高宇
3、清华大学胡杨:以晶圆级协同设计提升Token经济性
清华大学集成电路学院副教授胡杨认为,衡量AI基础设施的价值,不能只看单芯片峰值算力,还得把有效Token产出,以及设备、网络、供电冷却等全生命周期的投入一并算进去。围绕Token经济性,他的团队正在做从计算芯粒、晶圆级芯片到集群的全系统协同设计。
通信、功耗、集成密度这三道坎摆在面前,团队的做法是看任务需要什么,再结合面积和功耗的约束,去调配计算、存储、通信三者的比例。到了系统这一层,高带宽通信被搬进晶圆内部,晶圆内外的互连以及供电冷却一起设计,目的就是让通信等待和外围设备的开销都降下来。
报告里提到了模型部署、专家布局、集群组网这几方面的进展。把Token映射和专家负载均衡放在一起调优之后,MoE推理方案在4毫秒输出Token间隔的约束下,单芯粒吞吐做到了对照方案的1.84倍。晶圆间组网方案在所评估配置中,电力成本比基线低了46%。这两项研究,一个盯的是怎么把有效产出提上去,一个盯的是怎么把系统投入压下来,都是围绕晶圆级的经济性在做文章。胡杨也强调,光看性能收益不够,制造和运行的代价得放在一起算。热致翘曲、制造与装配良率、容错、散热约束,这些都已经进了设计环节。团队联合清微智能做出了国产晶圆级芯片样机,大尺寸硅基板设计PDK、芯粒集成与系统验证这几项能力也算立住了。软件基础设施那边,则是和清微智能、浦江实验室一起搭的。
清华大学集成电路学院副教授胡杨
4、后摩智能信晓旭:M50已定点150+产品,3D CIM架构取得阶段性成果
后摩智能联合创始人、产品副总裁信晓旭在分享中说,AI芯片要提升算力、改善访存,这两件事都不好办。后摩智能走的是存算一体这条路,而且是最早一批入局的,六年来一直沿着基于SRAM的存算一体方向做迭代,把这项架构从学术圈带进了产业界。旗舰产品M50量产已有半年,产品定点超过150个,商业闭环算是跑通了。
行业里主流的3D堆叠技术有算力受限、散热不佳这些麻烦,后摩智能干脆自己搞了3D CIM架构,同样面积下算力翻倍,功耗和散热压力也明显好转。信晓旭说,端侧AI对算力、能效、存储带宽都提出了新要求,后摩智能会顺着这些需求往下做技术演进,同时加快3D CIM架构的芯片产业化探索。
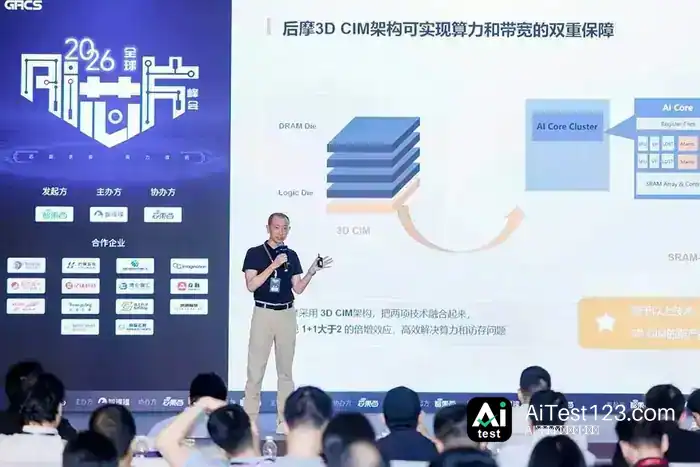
后摩智能联合创始人、产品副总裁信晓旭
5、奎芯科技王晓阳:未来AI芯片或采用定制内存(HBM+HBF)+标准互联新架构
奎芯科技联合创始人兼副总裁王晓阳的判断是,AI芯片设计正在往定制化、异构化、专用化走,内存架构创新因此有了新空间,HBM Base Die定制化和HBF分层存储就是两个新方向。
HBM内存早就不只是标准单品了,它已经变成一个小型子系统,不同工作负载得分别做深度定制。HBF这边用的是NAND Flash定制化堆叠,带宽能到HBM级别,容量却高出一个数量级。将来的AI芯片可能会走NAND Flash(HBF)加HBM的混合架构:KV Cache、Attention这类对延迟敏感的数据留在HBM,可预测的专家权重则放到HBF上。
奎芯科技的内存与接口IP是全栈的,在UCIe、HBM、LPDDR、ONFI/NAND这些接口上积累不浅,能给定制内存加标准互联的架构提供接口底座技术。奎芯M2 UCIe:接口底座的标准封装32G已经完成硅验证,它做的Chiplet产品ML100 IO Die可以把HBM和xPU解耦,目前已经流片并交付客户。
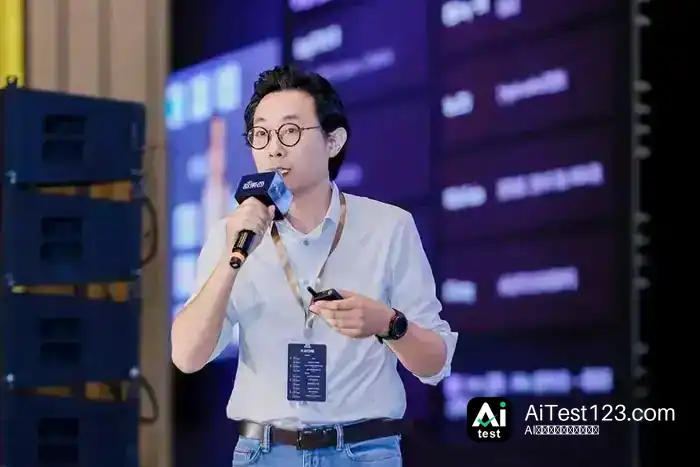
奎芯科技联合创始人兼副总裁王晓阳
二、经纬圆桌:AI的平民化及端侧模拟计算的未来
这场经纬圆桌的主持人是经纬创投合伙人童倜,晰见科技创始人杨哲宇、安纳智芯首席科学家孙仲、芯词元创始人詹翊、后摩智能AI系统总工陈仲铭四位嘉宾到场,聊的是“AI的平民化及端侧模拟计算的未来”。童倜给圆桌划了两个重点。一个是AI平民化——AI服务面向富人只是中间阶段,往后肯定会有大量产品和服务是给普通人用的。另一个在端侧,传统GPU、数字NPU是“老登”,以后得靠更多新技术来解决眼下的问题。
计算芯片公司有了水,还得有配套的管子,这里的管子说的是芯片能支撑的模型规格能力。童倜的看法是,企业自己有核心计算能力是前提,至于存储架构怎么选,得看具体应用场景,根据对应模型的参数规模以及系统需要来定。
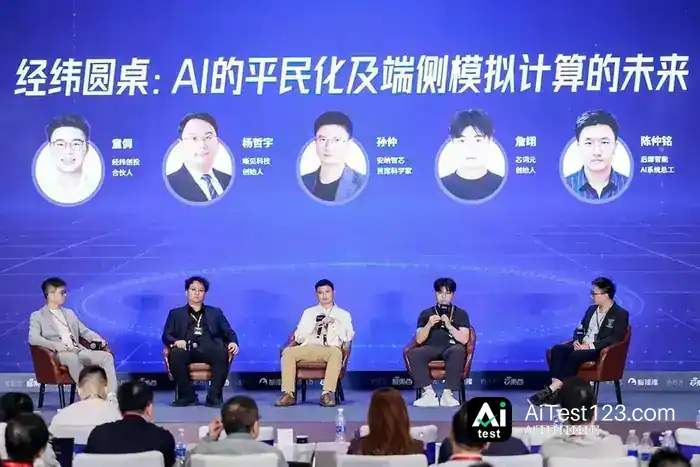
从左到右:经纬创投合伙人童倜,晰见科技创始人杨哲宇,安纳智芯首席科学家孙仲,芯词元创始人詹翊,后摩智能AI系统总工陈仲铭
1、晰见科技杨哲宇:天眸芯成果荣登Nature封面,实现物理通用智能(Physical AGI)
晰见科技创始人杨哲宇说,端侧智能,或者说范围更大的Physical AGI,是比肩AI Coding的下一个机会,晰见科技想做的事就是让AI有眼睛能看世界。天眸芯是一颗感存算传一体的3D IC芯片,能直接输出token,相关论文登上了国际顶刊Nature封面。
天眸芯的结构建立在3D堆叠技术上,感光阵列下面堆的是高密度存储阵列和运算单元,靠模拟计算把ADC的转换频次降下来,功耗只有同规格芯片的几十分之一。
杨哲宇还透露,现在头部具身智能企业打网球、踢足球、打乒乓球的视觉方案,要么直接来自天眸,要么已经进入深度评估。具身运动人形机器人在未来3-6个月内,都会用上晰见科技的天眸芯或者Token Camera。
今年11月,晰见科技要发布基于天眸芯的多模态大模型。内部测试显示,用了天眸芯的稀疏Token之后,这个模型的首token延迟(TTFT)只有传统基础模型的二十分之一,性能可以直接对标国内外头部多模态大模型,而且率先支持主动感知与视觉注意力,是未来Physical AGI时刻的基座模型。
2、安纳智芯孙仲:用模拟计算芯片把机器人时延压到几毫秒
安纳智芯成立至今还不满一年,主攻方向是模拟计算芯片设计。该公司首席科学家孙仲表示,这类芯片有望把相关应用的时延从百毫秒级压缩到几毫秒——人对延迟的感知门槛在几十毫秒,机器人若能把延迟控制在几毫秒,动作就会顺畅许多。
端侧大模型的数据量相当庞大,做3D堆叠是应对这一问题的自然选择。安纳智芯的强项在矩阵计算,面对端侧设备微调这类具体应用,数据存储可以走DRAM或HBM,再由模拟计算芯片完成数据处理和微调,这也是该公司接下来要探索的方向。
孙仲透露,工程样片很快就要回片。下一步安纳智芯会与银河通用等具身智能企业联合做运动规划和实时控制Demo,同时和科大讯飞等端侧AI公司一起打造信号处理、大模型微调等应用。
3、芯词元詹翊:庖丁解牛式拆解AI平民化三道坎,正联合小米打磨超高速AI推理终端产品
芯词元创始人詹翊把AI平民化拆成三个维度:AI值不值得用、用不用得起、能不能显著提升生产力。头一个维度跟基座模型相关,后两个落到硬件上,就是压成本和提推理速度。
芯词元打算基于全新一代存算架构,做出速度更快、成本更低的AI推理芯片与推理算力集群。按计划明年上半年会发布MO-I1,展示接近万tokens/s的端到端推理速度,并联合小米等产业伙伴,把超高速AI推理硬件真正落到现实应用场景里。
詹翊的看法是,未来的AI推理硬件会是一个把各种存储介质长处都收进来的综合系统。芯词元的eDRAM管片内高带宽和高速计算;片外的3D DRAM和HBF在带宽和密度上各有优势,各自都有适配的场景。因此AI推理硬件在不同场景下会采用不同的搭配,但片内方案里,芯词元的eDRAM存算一定是最优的那一个。
4、后摩智能陈仲铭:M50芯片10W功耗跑122B大模型,下一代旗舰芯片已流片
后摩智能AI系统总工陈仲铭认为,3D堆叠能把内存带宽做大,带来极高的数据吞吐,放到物理AI场景里,有机会实现实时交互。不过他也提到,眼下相关供应链还没成熟。
面对HBM高昂的成本,HBF是一条技术思路。陈仲铭觉得HBF没法完全取代HBM,更多是起互补作用,将来3D堆叠技术可能走向HBM+HBF这类混合堆叠架构。
后摩智能走的是3D CIM(存算+3D DRAM)路线,其下一代旗舰芯片A20已经流片,具备端测超实时思考和互动能力。
这家公司同样在盯模拟存算,可能放到下一代或下下一代产品上实现大规模生产。
三、大模型AI芯片狂奔3D堆叠、新型存储、模拟计算风起云涌
大模型参数往万亿级膨胀之后,峰值算力已经不再是衡量AI芯片能力的唯一标尺。数据搬得动、存得下、连得快,以及芯片能不能以可接受的功耗和成本真正落地,同样在制约系统效率。访存带宽、互联效率、软件生态和工程化能力,正共同决定一颗AI芯片的有效算力。
AI芯片的创新正从单点提升计算性能,转向计算、存储、互联、软件与设计工具的系统级重构。从架构创新到规模量产、从理论性能到真实应用,这条链条怎么打通?在大模型AI芯片高峰论坛上,8位嘉宾给出了各自的答案。有人用软件定义、3D堆叠和近存计算去突破内存墙,有人押注存算一体、HBF与现代模拟计算,也有人把战场推到融合GPU、STCO和AI赋能EDA上。
1、东方算芯彭贵强:用“软件定义+3D堆叠”创新绕过系统瓶颈
东方算芯董事长特别助理彭贵强表示,“更聪明的模型”要的是大算力和高访存带宽,“更低成本的应用”要的是高访存带宽加低成本推理,算力的评价标尺正由峰值算力转向有效算力。芯片性能不只看计算单元本身,还受制于访存带宽、互联延迟、调度效率等系统因素。
东方算芯把重心放在软件定义芯片上,从计算、存储和互联架构三方面入手创新:(1)软件定义Tile,提升硬件利用率,降低编程复杂度;(2)采用逻辑-存储三维匹配的3D IC设计,提供极致带宽并突破内存墙,这一过程需要应对应力与晶圆翘曲控制、热管理和良率成本损失三大工程化挑战;(3)通过Infinity Chiplet 3.5D,实现更强算力和更大互连规模。
东方算芯董事长特别助理彭贵强
2、亿铸科技熊大鹏:三大定律,指引通用存算一体
亿铸科技创始人、董事长兼CEO熊大鹏认为,通用存算一体是突破AI芯片算力与内存瓶颈的关键。围绕这一点,他提出三大核心定律,为行业落地提供理论支撑。
(1)搬运代价定律:AI数据搬运功耗与延时远高于计算本身,存算一体核心是尽可能消除数据搬运频次与距离。
(2)通用边界定律:通用存算一体需兼容CUDA主流生态,全覆盖通用GPU算力,适配各类模型迭代。
(3)异构终局定律:存算一体与GPU架构逻辑不同,二者融合能力直接决定芯片商业化成败。
熊大鹏提到,做存算一体,关键还是落在存储上。亿铸科技挑的是大容量、成熟度高、成本又低的3D DRAM路线,接下来会铺开多种形态的全栈算力产品,把云、边、端各类算力场景都覆盖进去。
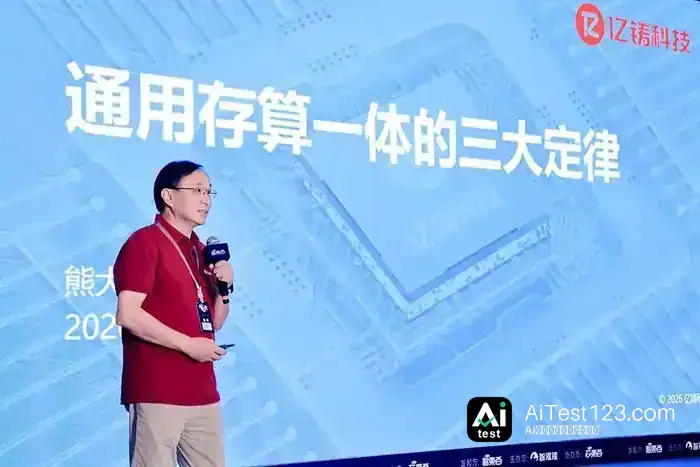
亿铸科技创始人、董事长兼CEO熊大鹏
3、迈特芯李凯博士:端侧模型有“三座大山”,3D近存计算可破局
深圳迈特芯科技芯片产品经理李凯博士把端侧大模型推理面前的难题概括成“三座大山”:功耗、算力与成本凑成的“不可能三角”;内存墙的束缚;通用方案和专用芯片之间场景适配不容易。
迈特芯的办法是把张量脉动架构和3D近存计算叠在一起,去拆掉“内存墙”,带宽利用率能拉到80%左右。按测算,同样做到600GB/s带宽,传统2D方案功耗大概30~50W,3D方案则能压到3~7W。
李凯博士透露,迈特芯3D TPU芯片今年已经流片,预计今年11月回片并点亮,首批适配2B至9B模型,平均功耗约6W,推理速度预计能到80tokens/s。
深圳迈特芯科技芯片产品经理李凯博士
4、Imagination艾克:端侧芯片需要融合GPU
Imagination应用工程总监艾克看到,端侧芯片如今已经要一并扛起感知、计算、推理和图形渲染这些活,老一套异构架构的毛病就露出来了——数据搬运、内存吞吐、任务调度、软件适配都跟不上。模型和应用需求在5-10年生命周期里一直变,怎么接住,成了端侧芯片设计的新考题。
业界在试更灵活的异构融合计算架构,路子是让GPU不再只管图形,而是往通用计算与AI计算中心靠。ImaginationE系列GPU IP把矩阵乘法直接塞进GPU核心,以此抬高GPU利用率;AI计算、通用计算和图形处理交给固件统一调度,多任务相互隔离;再靠算子库、图优化和多格式量化支撑轻量化部署,把计算单元之间的数据搬运和调度开销压下来。
Imagination应用工程总监艾克
5、硅芯科技赵毅:3D芯片EDA是“无人区”,需要STCO+AI开路
硅芯科技创始人兼总经理赵毅博士说,3D IC EDA这块地方算得上是“无人区”——2D时代攒下的设计方法学和工具链,到了三维堆叠场景里要动大手术,工具链和设计范式都得重来。眼下3D DRAM多层堆叠与存算芯片企业缺的就是一套全新工具链;信号、电源、热这些多物理场仿真,也得从单点后置改成协同前置。
芯片设计正在从单芯片时代的DTCO(芯片设计与硅工艺协同),往端到端深度协同的STCO(系统-工艺协同优化)走。硅芯科技的STCO闭环协同流程把架构、设计、工艺和制造串起来,翘曲、电源完整性这类量产风险提前管住。
另一头,AI也会给EDA带来新范式。硅芯科技拿出了3Sheng Integration平台,核心AI Agent“Chips Z”能自动迭代、闭环寻优,研发周期被大幅压缩,芯片产品上市也跟着提速。
硅芯科技创始人兼总经理赵毅博士
6、启芯宸光陈文超:以DeepChip平台推动AI赋能芯片设计全流程
启芯宸光副总裁、EDA智算平台首席架构师陈文超讲了DeepChip平台的技术布局和落地情况,也谈了怎么让AI智能体、行业知识库和EDA工具配合起来,把芯片设计、验证、测试的效率往上提。
启芯宸光DeepChip平台下有DeepEDA、DeepIP、DeepATE与DeepEDU四大业务模块。DeepEDA把EDA智算平台和AI²C智能体平台合到一起,靠算力调度、参数优化和流程自动化来加快设计仿真;DeepIP连接本地或云端大模型,搭配企业知识库与EDA工具,覆盖系统设计、RTL生成、功能验证和调试优化;DeepATE盯着测试程序生成、测试向量转换与引脚自动匹配,让芯片测试自动化程度更高;DeepEDU把产业级AI工具和真实项目搬进教学实训,培养既懂AI又懂芯片设计的复合型人才。
现场演示了搭建测试平台、完成指定驱动代码生成与验证的案例,说明AI能帮工程师甩掉重复劳动,研发迭代也更快。
启芯宸光副总裁、EDA智算平台首席架构师陈文超
7、九天睿芯刘铮:HBF AI芯片国内外研发竞速中
九天睿芯副总裁刘铮表示,MoE模型参数量越滚越大,存储容量也越来越吃重,基于HBF高带宽闪存的方案因此愈发关键。照他预计,国内外厂商会在2027年上半年完成计算、存储层流片,HBF AI芯片有望在2027年下半年推出。
在先进“存算+近存”这条技术路线上,国内厂商摸索出了三维堆叠芯片设计方案,能把TB级大模型权重放进超高容量存储层;再配上SRAM存算一体技术,存储墙、功耗墙的问题一并处理。这套方案可以支撑超高参数量MoE大模型在云端推理场景和AI手机等智能终端场景落地,用户的智能体验也会更好。
九天睿芯的云端推理芯片,据副总裁刘铮介绍,能高效完成FFN阶段计算;Attention阶段既可以自己独立处理,也能跟其他GPU方案搭配,在系统层面搭出一套A/F分离的异构高效计算架构。
8、安纳智芯向锐:矩阵方程“一步”求解,现代模拟计算让AI训练少绕弯
安纳智芯联合创始人兼CEO向锐的看法是,AI训练绕不开矩阵方程求解这道数学基础题,可数字芯片直接去解效率不高,落到工程上还得先转成一连串矩阵乘法。同样的精度下,现代模拟计算在运算速度和能效比上都比先进数字芯片高出一大截,面对大量的矩阵方程求解需求,称得上是一种颠覆性方案。
安纳智芯拿出的办法就是“现代模拟计算”——借物理法则天然并行的特性,把计算压到一步完成。2025年,这套方案做到了24位定点精度。向锐说,这是全球第一个全模拟的高精度矩阵方程求解方案。
落到应用上,面向云端,这颗芯片计划支持二阶优化器——眼下几乎所有开源大模型厂商都开始用这类训练方法,为的是压低大模型训练成本;面向端侧,则打算靠近百倍的能效优势撑起后训练,同时探索具身智能采训推一体化和在线自进化。
安纳智芯联合创始人兼CEO向锐
四、Agent推理需求爆发,AI算力不再押注单一芯片,CPU、异构算力、RISCV成下一程关键
智能体一步步走向规模化落地,AI产业也进入推理算力说了算的新阶段。跟传统AI模型的交互方式不同,智能体能自主决策、持续运行,还要处理长任务,推理算力需求因此成倍往上翻,行业里Token供给不够、推理成本高、端云适配脱节这些老问题也越发扎眼。
产业走到这个关口,6位嘉宾出现在Agent推理芯片高峰论坛上,围绕推理芯片落地难在哪、产业未来怎么走,各自亮出了前沿技术方案和实战经验。
1、光羽芯辰张晴:拿异构算力替掉单一结构,端云协作与云端推理路线出炉
光羽芯辰联合创始人、董秘张晴表示,AI推理需求正在指数级增长,可推理侧的Token供给被卡得很死。光羽芯辰的思路是3D堆叠、异构计算加存储分层三管齐下,把端侧推理能力抬上去,推动能真正落地的端云协同;云端则靠PD分离把推理成本大幅压下来。
这套方案的第一步已经迈出:TC1000系列芯片实现量产部署,低功耗下能高性能跑35B MoE模型。第二代TC2000系列明年量产,功耗更低,面向AI手机等手持设备;第三代TC3000系列专攻超大规模模型的端侧部署和云端PD分离市场,目标是单芯片吃下万亿参数模型,同时把HBM需求和云端推理成本降下来。
光羽芯辰联合创始人、董秘张晴
2、博伦智汇张磊:从“有卡”到“用好卡”,异构算力调度是关键一环
国内算力需求涨得快,可供给和需求之间缺口不小,大量CPU闲着。博伦智汇技术架构师、资深算力架构专家张磊觉得,根子在于异构GPU规模化部署之后,软件生态和调度能力在国产芯片上还没适配到位。
博伦智汇的解法是用DRA Proxy把厂商设备插件和K8S接起来,统一转换、补全设备信息再上报,让异构GPU的资源能被发现和调度。同时自研的TOLD架构盯住Token,以低时延、高吞吐、低成本为目标,把资源规划、资源管理和推理服务部署串成一条线。
再往上,博伦智汇的MIX调度平台复用厂商设备插件,芯片接入成本降了下来,不同厂商的GPU也能把算力价值释放出来。
博伦智汇技术架构师、资深算力架构专家张磊
3、灵睿智芯李华庆:智能体时代,CPU要扛起Agent Harness这面旗
灵睿智芯联合创始人兼副总裁李华庆的判断是,Agentic AI正把计算范式从以GPU为中心的计算密集型,推向以CPU为中心的控制密集型和I/O密集型。模型推理主要交给GPU或其他AI芯片,长短期记忆管理、工具调用、多智能体调度、安全隔离这些Harness环节,则得靠CPU来顶。
在他看来,智能体爆发会给CPU带来大机会。往后业务越来越长尾、越来越碎,底层芯片的需求也会五花八门。摩尔定律慢下来、工艺红利变薄、能耗约束越来越紧,光靠工艺演进已经撑不起计算效率和能效的继续提升,得照着不同业务特性去定制芯片。所以智能体时代的CPU得做到高性能、高并发、高可靠、AI增强和可扩展,而指令集上最合适的选择就是RISC-V。
灵睿智芯联合创始人兼副总裁李华庆
4、芯来科技胡振波:RISCV是AI芯片时代最好的ISA,NI系列IP为AI芯片赋能
芯来科技创始人、董事长胡振波指出,AI芯片对通用辅助算力的需求正不断攀升,而RISC-V凭借开放灵活的架构特性,能够在AI芯片里扮演主控核、算力核和启动核三种角色。算力核的地位如今越来越关键。
芯来科技在今年发布了NI1000系列RISC-V处理器IP,该产品面向AI推理场景,可支持1024至4096位向量宽度,并融合了算力内核,通过RWV、VME、SFU实现全域加速,推动AI芯片发展。
相较于单纯的传统RVV架构,RVV加VME的方案只多出约15%的芯片面积,却能换来约2.5倍的矩阵运算性能提升,与纯标量计算相比提升幅度超过100倍。NI系列还兼容现有的RVV软件生态。胡振波认为,RISC-V的开放性及自定义扩展能力,能帮助AI芯片企业在共享软件生态的前提下实现差异化创新,同时降低开发和学习成本。
芯来科技创始人、董事长胡振波
5、沨呵智慧丁阔:Token工厂进入精益运营阶段,两大指标形成飞轮效应
沨呵智慧智算产品总监丁阔表示,围绕能耗、产能和售卖效率等维度,他们依托两大指标搭建起了Token工厂的运营指标体系。
其中,TEF(Token效率因子)用于衡量GPU集群生产Token的效率,由GPU可用率、算力占用率和有效计算效率三者共同决定;TFI(Token工厂指数)则用来评估商用Token平台的售卖情况,把TEF与服务交付率、Token售出率、价格实现率结合在一起考量。
借助TEF和TFI,Token工厂能够形成飞轮效应。企业通过对这两大指标中参数进行诊断和调整,可以改善Token业务的利润,以达到自身的经营目标。沨呵智慧当前的产品交付形态,已从底层的算力资源一步步转向标准化的Token产能。
沨呵智慧智算产品总监丁阔
6、IO资本俞枫:芯片创业机会相对平权,硬件公司需要懂模型、懂芯片、懂系统
IO资本联合创始人俞枫对AI芯片及半导体领域的创业持乐观态度。在他看来,Agentic AI正处在指数级膨胀的阶段,旧有的生态壁垒正加速瓦解。模型快速迭代的同时,AI芯片的需求也在走向差异化,大公司没办法垄断所有创新场景,市场正在充分奖励创新带来的效能提升,创业公司因此获得了与大公司相对平权的机会。
不过机会增多之后,创业门槛也比以前高了不少。团队不光要懂芯片,还得懂模型、懂工艺、懂系统。他谈道:“没有模型公司能预测未来两年会发生什么变化,但硬件公司却要提前下注,这对创业公司管理层判断提出了更高要求。”
IO资本联合创始人俞枫
五、不止堆算力!具身智能产业还要拼架构与生态
具身智能正一步步从实验研究走向工业制造、家庭服务等实际应用场景。但机器人端依然要同时处理高维视觉信息、动态三维场景以及生成式的动作策略。面对计算量大、数据翻译频繁、存储开销高、实时性要求严格以及功耗受限等多重难题,传统通用计算平台很难在性能、能效和持续运行能力之间取得平衡。
围绕AI芯片在具身智能赛道的落地,在具身智能芯片高峰论坛上,6位嘉宾分享了各自的最新实践与思考。
1、复旦大学朱浩哲:具身智能的核心是物理世界下“理解行动”的实时闭环
复旦大学芯片与系统前沿技术研究院助理教授朱浩哲提出,具身智能的关键性能指标通常不是平均的TOPS或者吞吐率,专用芯片说到底要服务于机器人的端到端闭环。
报告从“感知—建模—决策—行动”闭环切入,分析三维场景表示、实时定位建图和视觉—语言—动作模型各自的计算特点。他介绍了三维高斯泼溅的训练、渲染与硬件加速方法,也讨论了VLA模型的推理流程、实时性需求及部署挑战。结合团队在3DGS、SLAM和VLA芯片架构方面的研究,报告阐释了算法与体系结构协同设计的必要性,并就具身智能专用计算平台的发展方向展开交流。
复旦大学芯片与系统前沿技术研究院助理教授朱浩哲
2、迈特芯谢齐家:以3D-IC芯片破解端侧VLA落地难题
迈特芯科技具身智能产品经理谢齐家,介绍了公司面向端侧VLA模型落地打造的3D芯片方案。他提到,VLA模型眼下有三个走向:数据飞轮让模型参数越做越大,快慢系统配合让动作更顺,Few-shot模型会最先落地。落到端侧算力上,就得在实时性、功耗和带宽之间取得平衡。
迈特芯的核心技术是3D-IC。在等带宽条件下,传统2D方案功耗最高约40多瓦,很难满足端侧要求,而3D-IC方案最高只需约7W。在PPA微架构上,传统3D/2D IC共用统一总线,数据必须先经过总线traffic再分发至各PE,耗时明显。迈特芯采用3D直连架构,让上层IO直接对应下层PE,大幅缩短了带宽访问路径,带宽利用率可提升至80%以上。
另外,谢齐家还提到,针对Transformer的算术特性做优化、避免算子间的 reshape overhead,是PPA提升的关键贡献点。
迈特芯科技具身智能产品经理谢齐家
3、天数智芯夏广武:具身智能主控芯片下一步是“大小脑”融合
天数智芯边端产品线副总裁夏广武表示,大模型接下来要从数字世界跨入物理世界。具身智能可以看作物理AI的具体呈现,主控芯片在其中扮演核心引擎的角色。
谈到技术特点,夏广武说眼下是算力分层对应模型分层:大脑管规划,小脑管运控,两者在物理上各归各的。下一步首先要做的是在物理层面把二者合到一起。他还介绍了天数智芯在具身智能方向的产品布局与方案特色。至于怎么推动这个产业往前走、落下去,他归纳了四条:开放软件栈平台与工具链、开发者生态社区、产业链协同、具身落地的工程化思路。产业推进得小步快跑,重点是把某个具体场景的端到端业务先跑通,积小成至大成。同时各方还得合作,建起人才培养的资源池,把具身智能发展的底子打牢。
天数智芯边端产品线副总裁夏广武
4、进迭时空陈俭东:RISCV同构融合计算,打造机器人软硬同构算力平台
进迭时空芯片产品总监陈俭东的看法是,行业已经走进机器人计算机的新阶段。眼下具身机器人大多用多异构计算方案,痛点不少:软件生态被割裂、数据来回搬运、硬件冗余、开发门槛偏高。
围绕这些问题,团队基于RISCV架构做同构融合计算,靠统一的架构、内存和软件系统,让CPU算力、AI算力和实时算力按需分配。
进迭时空的两代芯片目前都已量产发布。第一代K1的AI算力为2T;第二代K3是八核CPU,主频达到2.4G,AI算力达60T,支持部署30B模型。陈俭东透露,后面还会开发算力更高的平台,做大小脑融合芯片。
进迭时空芯片产品总监陈俭东
5、维泛智能殷积磊:不只拼算力,还要构建具身算力生态
维泛智能创始人兼CEO殷积磊提到,“大脑”芯片现在有两个难题:算力不够、能效失衡。百TOPS算力只是具身大模型在端侧跑起来的起步门槛,另外还得兼顾FP8、BF16、FP16等混合精度计算,以及实时响应和7×24小时稳定运行。
所以他提出仿生类脑芯片BiGPU架构,用新的计算范式把数据搬运和存储带来的能耗压下来,并原生支持FP8及脉冲神经网络,去适配具身场景里不同的模型和计算任务。
殷积磊说,目前规划的芯片算力在100~1000TOPS之间,但机器人芯片的较量不只看峰值算力,有效算力、能效和部署效率同样要看。未来维泛智能会探索搭建面向机器人的“Brain OS”,推动多方生态一起发展。
维泛智能创始人兼CEO殷积磊
6、肇观电子周骥:降低视觉处理功耗和成本,有利于具身智能更快落地
具身智能能不能落地,低功耗、低价格是关键,而把视觉处理的功耗和复杂度降下来又是其中重要一环。人类视觉处在生物进化的顶端,给具身智能视觉系统的设计提供了参考和启发。肇观电子CTO周骥认为,视觉芯片以后不该一味追大吞吐与大分辨率,而要借助时域信息和生成式模型来提升性能。视觉系统与语言/运动之间靠高度压缩的Token传递信息,用生成式模型替代传统ISP(传统信号处理),大分辨率图像只在需要解释智能体行为时才输出。
现阶段的视觉芯片有四个问题待解:机器人感知能力还需补全,缺了其他感官输入不利于降功耗;软硬件架构得靠业界一起改;VLM在端上跑起来还是吃力;现有Token压缩效率跟人脑比差距还不小。
肇观电子CTO周骥
六、结语:奔赴智能体时代AI算力开启精细化、场景化新周期
从芯片架构革新、3D堆叠先进制程,到KV Cache优化、异构混训混推这类算法算力协同技术,再到智能体、具身智能这些全新推理场景的探索,2026全球AI芯片峰会覆盖了当下AI算力产业的热点、难点与痛点议题。
智能体技术眼下全面爆发,正逼着全球AI芯片产业格局重新洗牌。过去单看峰值算力这一个指标,已经配不上大模型时代复杂的算力需求。数据存储、传输、交互、互联的全链条效率,加上功耗控制、成本可控性、工程化落地能力,一起决定了新时代AI芯片的“有效算力”。
架构创新继续深化,软硬件生态逐步完善,场景落地不断渗透,AI芯片有望进一步跳出“重参数、高消耗、低效能”的瓶颈,让算力、功耗、成本、场景匹配得更好。
往远看,AI算力是AI产业的核心底座,它的迭代进化会一直牵引整个AI产业的走向。