26B参数循环Transformer模型Inkling 2 Mini开源,支持本地离线运行
Thinking Machines Lab发布Inkling 2 Mini,采用循环Transformer架构,总参数26B。该模型支持文本和图像输入,可在配备32GB内存的MacBook上离线运行智能体任务,如编写代码或驱动虚拟角色。权重已按Apache 2.0许可开放,适合开发者部署本地编程助手。
把大模型塞进笔记本:Inkling 2 Mini 来了
就在大家还在讨论 AI 能否证明黎曼猜想时,Thinking Machines Lab(TML)扔出了一个更接地气的项目:Inkling 2 Mini。这是一个总参数量 26B 的多模态模型,最特别的地方在于它能在你的笔记本电脑上跑起来,而且不需要联网。
TML 已经按照 Apache 2.0 许可公开了模型权重。这意味着开发者不仅可以下载部署,还能通过 Tinker 工具进行推理和微调。官方给出的定位很明确:展示个人电脑上的模型到底能干什么。
断网也能写代码、建小镇
为了证明这不是纸上谈兵,TML 的研究人员做了两个演示。第一个场景很有画面感:研究人员带着一台配备 48GB 内存的 M5 Pro MacBook Pro 登上飞机,断开网络,让 Inkling 2 Mini 在几分钟内写出了一个可玩的飞行模拟器。整个推理过程完全在本地完成,没有依赖任何云端算力。
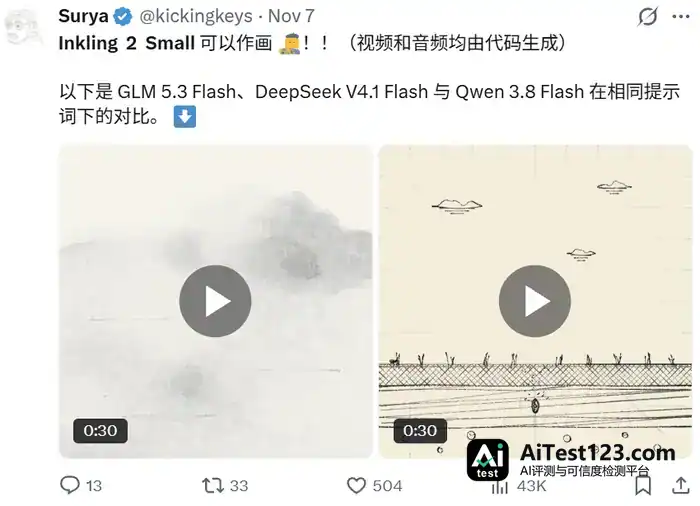
第二个演示更有趣,他们构建了一个叫 Thinkyville 的微型像素小镇。在这个小镇里,同一台离线 MacBook 上的 Inkling 2 Mini 同时驱动着 20 位村民。这些虚拟角色不是只会站桩的 NPC,他们会规划一天的生活,互相闲聊八卦,甚至举办烘焙比赛。如果你在游戏里给他们留便条,他们还会读取内容并做出回复。
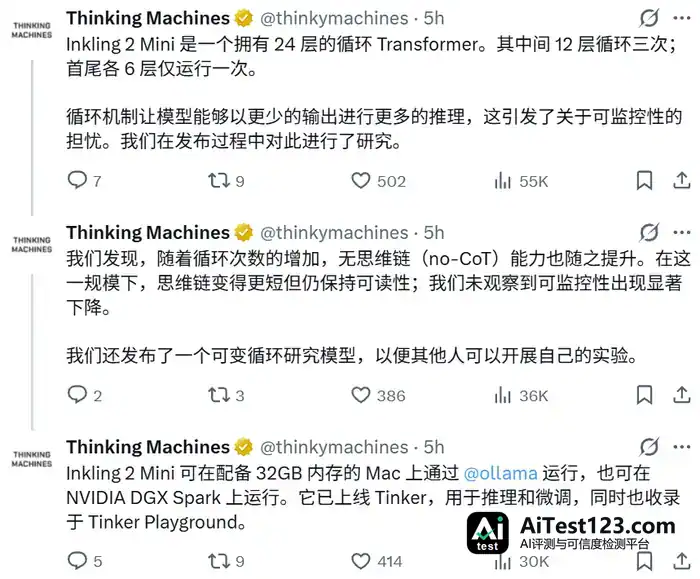
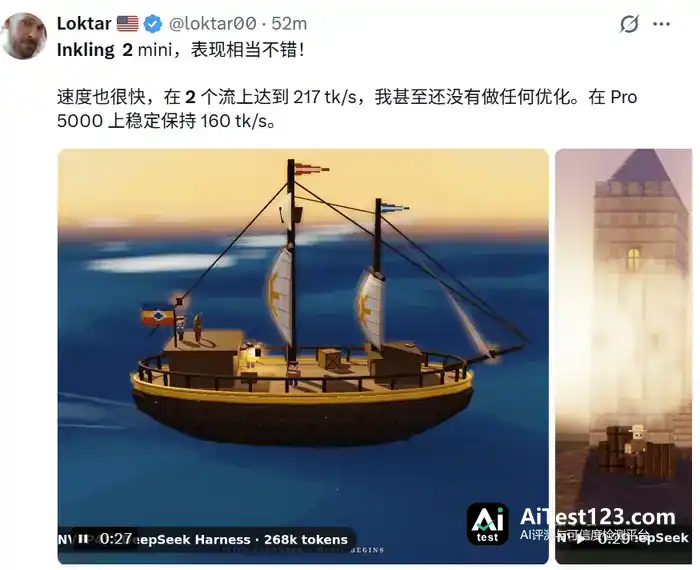
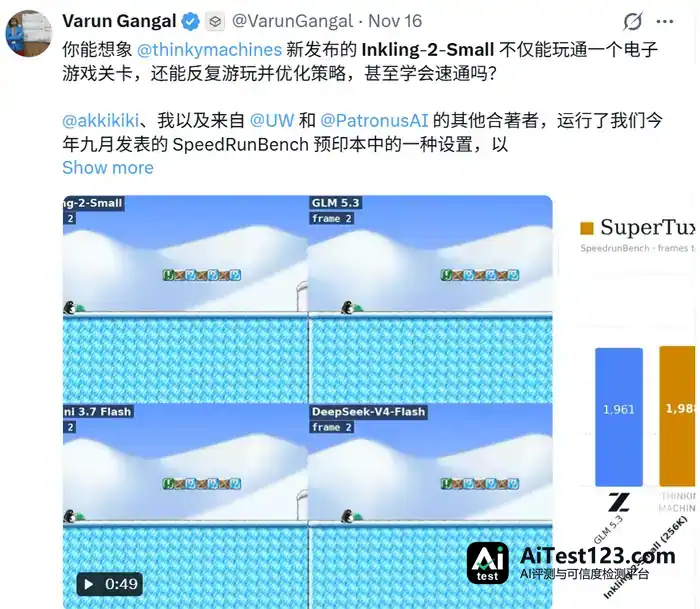
模型发布后,社区的反应很快。有人把它接入 DeepSeek Harness,发现推理速度飞快;还有人让它玩电子游戏,它不仅通关了,还学会了优化策略和速通。甚至生成动画 MV 这种多模态任务,它也能胜任。
核心技术:循环 Transformer 与混合专家
Inkling 2 Mini 之所以能在有限硬件上跑出这样的效果,核心在于它的架构设计。它没有沿用传统的线性 Transformer 结构,而是采用了循环 Transformer(looped transformer)。
什么是循环 Transformer?
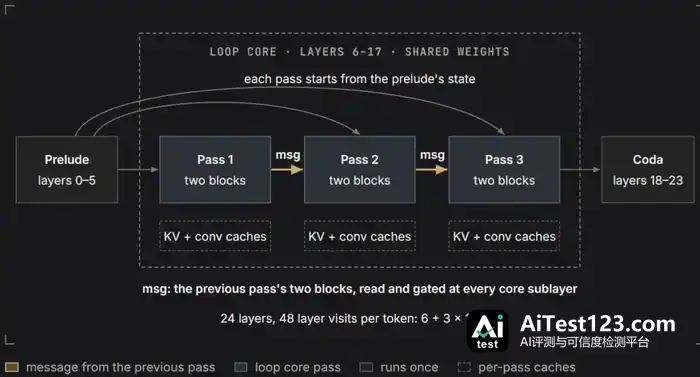
普通的 Transformer 模型在生成每个 token 时,数据会依次经过一组固定的网络层,每层只计算一次。Inkling 2 Mini 则不同,它把中间的一段网络层重复利用了起来。
具体来说,这个模型共有 24 层。最前面的 6 层和最后的 6 层各运行一次,而中间的 12 层会运行三次。在后续的循环轮次中,模型还会读取上一轮传来的信息。这样一来,虽然模型只需要存储 24 层的权重,但每个 token 实际上经历了 48 次层计算(6 + 12×3 + 6 = 48)。
这种设计增加了内部计算的深度,为需要连续推导的任务提供了更多处理空间,同时控制了权重文件的体积。对于本地部署来说,这意味着你用更小的存储空间,换来了更强的推理能力。
混合专家(MoE)进一步压缩激活量
除了循环结构,Inkling 2 Mini 还采用了**混合专家(MoE)**架构。在处理每个 token 时,模型不会激活所有参数,而是只调用部分“专家”参与计算。
数据显示,模型的激活参数约为 3.4B。如果将循环中的重复计算计入,有效参数激活量约为 5.4B。这种稀疏激活机制大大降低了单次推理的计算负载,使得在消费级硬件上运行成为可能。
编程与智能体能力评测
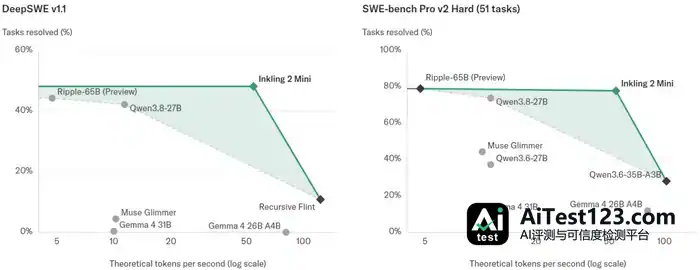
从 TML 公布的评测数据来看,Inkling 2 Mini 的长处主要集中在智能体编程、搜索和工具使用上。
在 DeepSWE v1.1 基准测试中,它的任务解决率为 48.2%,作为对比,参数量更大的 Qwen3.8-27B 为 42.2%。在更严格的 SWE-bench Verified 测试中,Inkling 2 Mini 取得了 79.2% 的成绩,略高于 Qwen3.8-27B 的 77.8%。
这些数据表明,尽管参数量只有 26B,但在特定的编程和智能体任务上,它的表现并不逊色于一些更大规模的模型。
低精度格式优化存储
要把这样的模型塞进笔记本,权重的存储方式也很关键。Inkling 2 Mini 的专家层主要使用 NVFP4 低精度格式,最后 4 层采用 MXFP8。重要的是,它在训练阶段就使用了这些精度,并以同样的精度部署。这减少了交付时再次转换精度的环节,避免了精度损失带来的性能下降。
发布的检查点文件大小约为 20GB。官方建议的运行配置是:至少配备 32GB 内存的 Apple 芯片设备,或者其他提供至少 32GB 显存的 GPU 平台。目前,Ollama、vLLM、SGLang 等主流本地推理工具都已经支持该模型。
思维链与研究版本
循环计算还有一个值得关注的副作用:模型可以在输出文字之前,完成更多的内部处理。这就引出了一个问题:我们看到的“思维链”(Chain of Thought)在多大程度上反映了模型的真实思考过程?
为了研究这一点,TML 同步开放了一个名为 TML-d24-varloop-research 的研究版本。与固定循环三次的 Inkling 2 Mini 不同,这个版本允许在推理时动态调整循环次数。研究者可以利用它在同一组权重上比较增加计算量对结果的影响。
官方明确指出,TML-d24-varloop-research 仅用于研究目的,实际产品应用仍推荐使用标准的 Inkling 2 Mini。
能力边界与适用场景
当然,Inkling 2 Mini 也有明确的短板。根据 TML 的说明,它在多轮对话和多重约束指令上的表现仍有不足,复杂推理能力与更大参数的模型存在差距。此外,增加循环次数并不会直接扩大权重中储存的事实知识,它更多是提升推理的深度,而非知识的广度。
这次发布的意义在于,它探索了在有限权重体积下增加推理计算的路径,并把模型真正交给了开发者。对于那些希望搭建本地编程助手、或者需要长期运行离线智能体的用户来说,Inkling 2 Mini 提供了一个新的、可行的选择。
你不需要昂贵的服务器集群,只需要一台内存足够的笔记本电脑,就能拥有一个能写代码、能玩游戏的本地 AI 伙伴。这或许比那些遥不可及的数学证明,更让普通开发者感到兴奋。
感兴趣的用户可以访问 Hugging Face 获取模型权重,或通过官方博客了解更详细的技术细节。