Karpo开源决策模型与浏览器框架,Agent推理成本降至十三分之一

资讯 AI 应用前沿 全文 2934 字 · 约 8 分钟读完 配图 16 张 分类决策模型开源智能体大模型

MachinePulse AI开源Karpo Decision系列模型及karpo-browser框架。通过System 1+2架构,将网页操作决策时延压至毫秒级,Browserbase基准测试成功率89%,单次任务成本约0.64元,显著低于通用大模型方案。

所属频道 模型发布智能体与 Agent开源生态前沿研究

决策模型不再黑盒:Karpo开源31B参数模型

做Agent落地时,开发者经常卡在一个两难上:所有逻辑都交给通用大模型处理,响应慢、Token费用也高;换成闭源的高速决策接口,又没法私有化部署,数据隐私也没保障。
文章配图

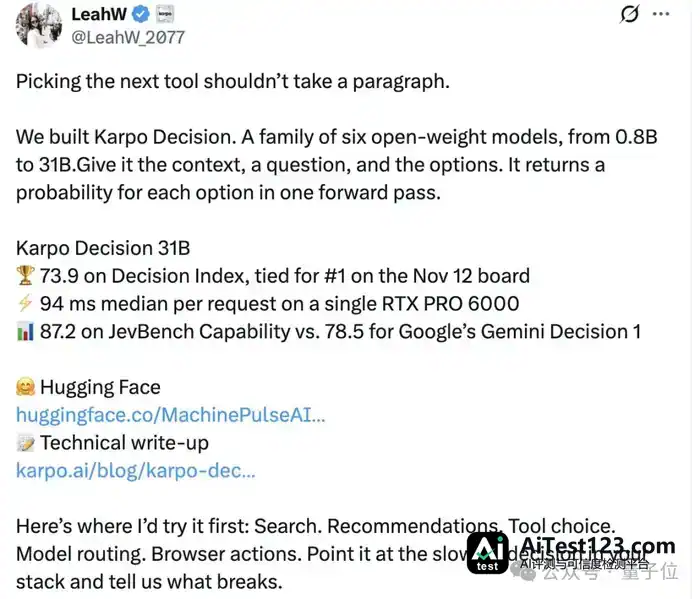
2026年11月,MachinePulse AI把Karpo Decision 31B模型和配套的浏览器操作框架karpo-browser一起开源了。这套方案想解决的就是上面那个痛点:高频、低延迟的判断任务交给专门的决策模型,通用大模型则专心做复杂推理。
文章配图

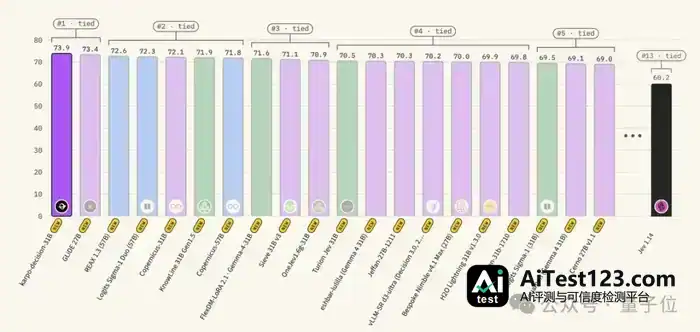
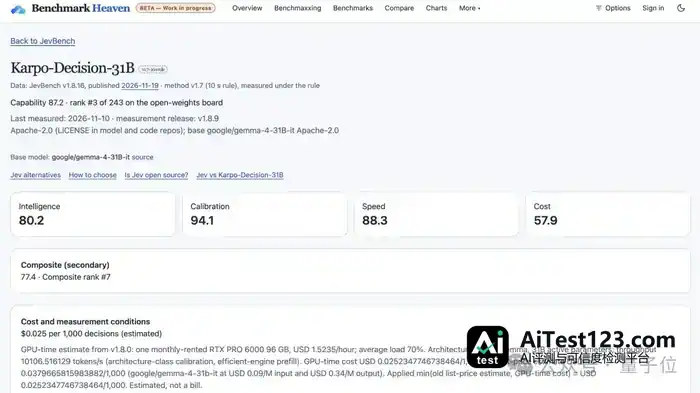
在Decision Index评测里,Karpo Decision 31B拿下73.9的Full分,排在首位。它最大的长处是推理延迟和成本都压得很低。公开数据集上做了14万次请求测试,中位响应时间只有94毫秒。Agent场景要实时交互,毫秒级的反馈速度对用户体验来说是质的变化。
文章配图

为什么Agent需要专门的“决策脑”?

文章配图

Agent能力越强,工作流里琐碎的判断环节就越多。比如浏览网页时该点哪个按钮,从搜索结果里挑出符合特定条件的条目,或者判断当前任务有没有做完。
文章配图

每一步都调通用大模型逐字生成答案,速度慢不说,算力也白费。这就像拿重型卡车去送一封信,信能送到,效率却低得离谱。
文章配图

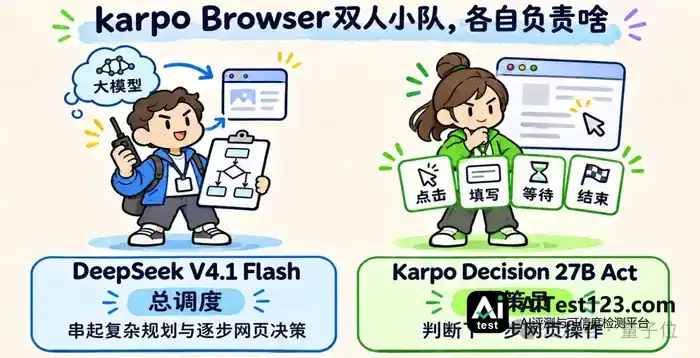
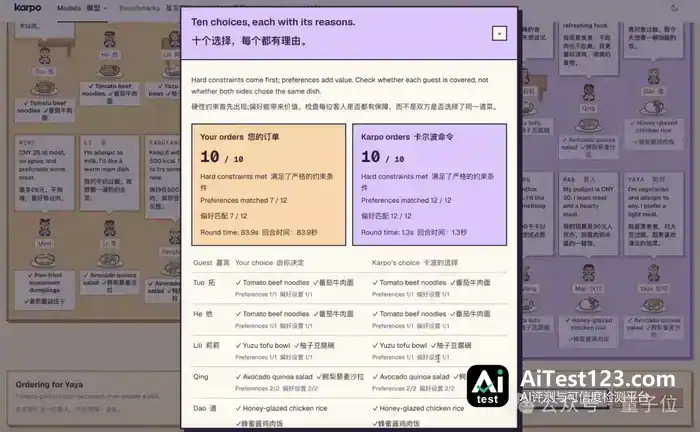
Karpo的思路是把“思考”和“行动”拆开。理解用户意图、拆解复杂任务这类活交给通用大模型(System 2);具体的、高频的动作决策由Karpo Decision模型来做(System 1)。
文章配图

拿订餐厅来说,“我要订一家人均200元、靠近地铁站的法餐”这句话,由DeepSeek V4.1 Flash等通用模型来理解并提取关键信息。接着karpo-browser框架接管页面,网页上点哪个输入框、选哪个日期、按哪个确认按钮,由Karpo Decision 27B Act模型来定。实测下来,网页上约78%的操作是决策模型完成的,而这些操作只占总耗时的14%、总成本的13%。
文章配图

技术架构:一次推理,多个决策

文章配图

Karpo Decision 31B跑得快,靠的主要是两项技术:Readout Head和Branch Attention。
文章配图

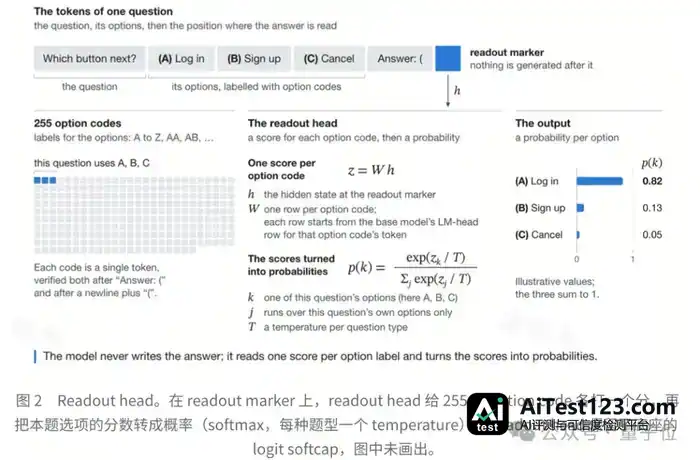
传统大模型做选择题,得逐个Token把选项文字生成出来,再由程序解析。Karpo换了个做法,用Readout Head机制在模型输出层直接给每个候选选项打分、转成概率。全程只做一次前向推理,输出Token数为零,生成文本那段时间开销被彻底去掉。
文章配图

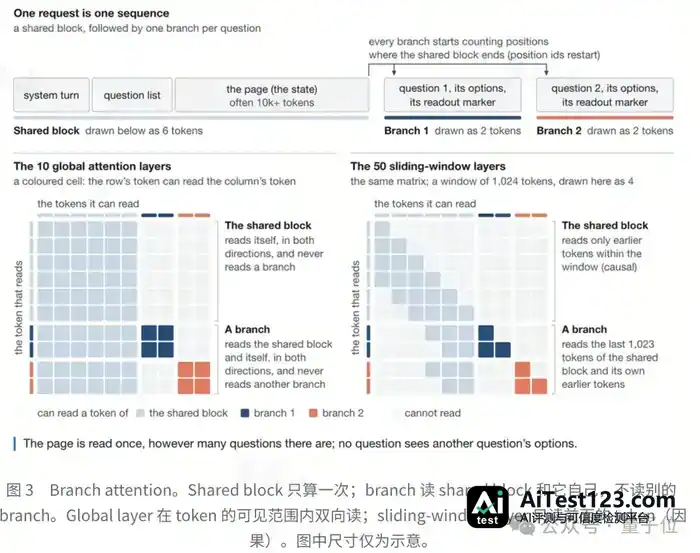
另外,Agent常常要同时处理多个决策,比如从50个搜索结果里选出最相关的5个。逐个判断的话,上下文要重复算50次。Karpo用Branch Attention架构,支持256K上下文:任务说明、网页内容这类共享背景信息放进Shared Block,只算一次;不同的题目和选项各自放进Branch。这样一来,几十道判断题可以并行处理,彼此不干扰。
文章配图

用RTX PRO 6000跑16到63道题,中位耗时653毫秒,题量涨上去,时间并没有跟着线性往上走。
文章配图

校准与泛化:别让模型“盲目自信”和“偏科”

文章配图

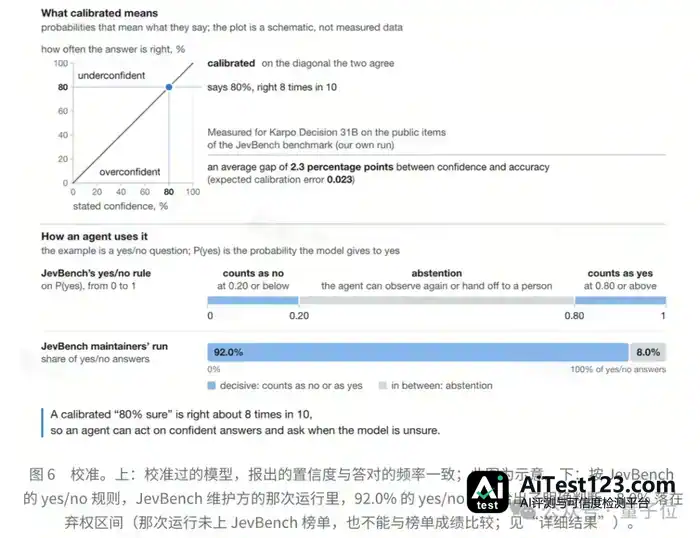
快只是其中一面,模型还得清楚自己把握有多大。要是答错了还给出高置信度,Agent就可能照着错答案往下执行。
文章配图

为此Karpo用上了RLCD,也就是面向校准决策的强化学习。做法不只是奖励选对,还按预测概率分布来算奖励,让模型如实交代不确定性。JevBench测试里,它的预期校准误差(ECE)只有2.3%。对开发者来说,这意味着可以设一个阈值:置信度掉到某个值以下,就把控制权交回人工或通用大模型。

训练集上表现好、换个陌生领域就掉准确率,是另一类常见毛病。Karpo团队观察到,训练越往后,模型在公开测试集上的分数在涨,可在13个陌生领域的准确率却从72.1%滑到了70.7%。

针对这种“偏科”,团队搬出了RSI(递归自我改进)训练框架:先训出多个候选模型,看它们在各领域的表现,再用Model Fusion把早期模型的泛化能力和后期模型的专精能力揉到一起。融合后的模型保住了公开测试的高分,陌生领域准确率还升到72.3%,超过KnowLine、Sieve等竞品。

浏览器Agent实战:速度与成本一起压

决策模型之外,MachinePulse还开源了karpo-browser框架和KBB评测集。这套东西在Browserbase Benchmark v2上跑出了明显效果。

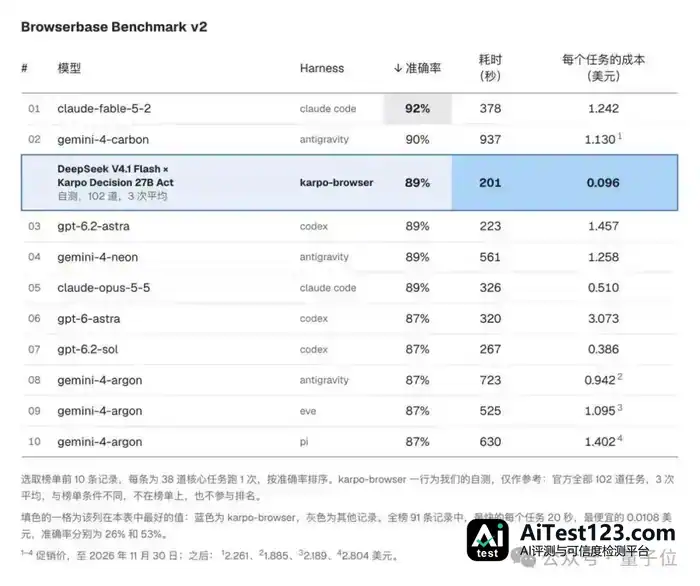
102道核心任务的测试结果是:Karpo方案平均成功率89%,平均耗时201秒,单任务模型成本约0.096美元(约合人民币0.64元)。换成Claude Fable 5.2 + Claude Code,速度慢约1.9倍,成本高出13倍。

测试标准其实更严:每道题跑3次取平均,而其他榜单模型一般只跑1次。条件这么苛刻,Karpo仍是唯一能在成功率80%、耗时250秒内、成本0.15美元内同时达标的方案。

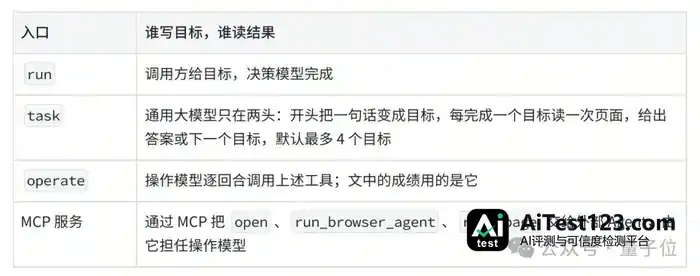
karpo-browser框架用TypeScript写成,能通过MCP协议接进Claude Code、Codex等现有Agent平台。开发者不用从头写浏览器控制逻辑,直接复用这套验证过的操作能力。

实际体验:搜索筛选与情绪识别

我们做了两项简单测试,看看Karpo实际能干什么。

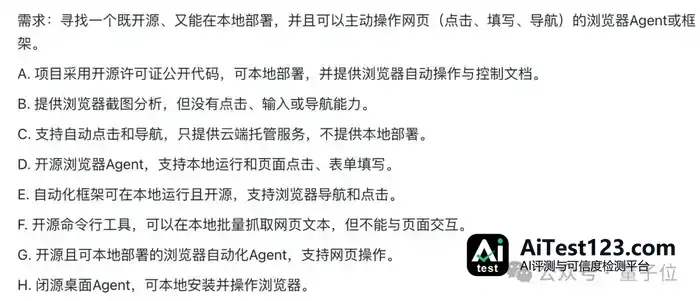
第一项是筛技术结果。给了8条“开源本地部署浏览器Agent”的搜索结果,里面混着云端工具和非开源项目。Karpo Decision 31B用308毫秒挑出4个符合条件的选项,没有误判。

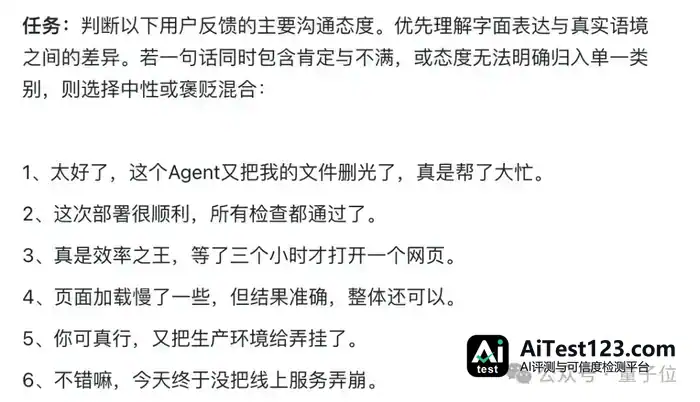
第二项是辨语气。“太好了,这个Agent又把我的文件删光了,真是帮了大忙!”这种反讽,Karpo在232毫秒内读出88%的负面概率;换成“页面加载慢了一些,但结果准确,整体还可以”这种中性评价,它给出91%的中性概率。这种细粒度的情绪感知,放到客服Agent或用户反馈分析场景里挺实用。

开源生态与后续打算

这次开源包括0.8B到31B共6种尺寸的Karpo Decision模型,外加27B参数的网页动作专用模型Karpo Decision 27B Act。工具链配套的是karpo-browser框架,以及覆盖584个真实网站、23,075步操作的KBB评测集。

对开发者来说,低成本搭高性能Agent有了现成路径。按JevBench的成本估算,1000次决策大约只要0.025美元;同样的运营预算,能撑起原来5到30倍的用户规模。

MachinePulse团队说,Karpo这个名字来自拉丁语“Carpe Diem”(把握当下)。他们的想法是让Agent接住琐碎决策,把人从繁杂操作里腾出来,去做更有创造性的事。决策模型逐渐成为AI基础设施的一部分,这种“快慢系统”分工的路子,或许会变成未来Agent开发的常见做法。

模型权重已经传到Hugging Face,代码库放在GitHub上,开发者可以按自己的需求挑不同尺寸的模型来部署和微调。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. ARTEX开源:AI Agent驱动渗透测试,Planner与Worker如何分工

    ARTEX 是一个基于 LLM Agent 的自动化渗透测试平台,采用 Go 和 Next.js 构建。它通过 Planner 和 Worker 协作,自动梳理资产、生成攻击向量并记录流量。本文介绍其核心架构、部署流程及在授权测试中的实际应用,强调人工复核的重要性。

    来源 AI 应用前沿
  2. 张博开源Linger:零token费本地跑125B模型,12GB显卡够用

    11月19日,前DeepSeek-VL项目负责人张博在X宣布开源个人Agent Linger,开发主体是张博创办的SIMPLEX AI TECHNOLOGIES PTE. LTD.(以下简称“Simplex AI”),代码已上传GitHub。按项目文档,Linger读取本地邮件、日历和文件,操作用户已登录的浏览器;连接

    来源 腾讯网
  3. DeepSeek-VL前负责人张博创业,Simplex AI开源个人智能体Linger

    一位DeepSeek早期核心成员,创业了。 11月19日,DeepSeek-VL前项目负责人张博(Tony Zhang)宣布,其创办的AI公司Simplex AI正式开源个人智能体产品Linger。这款产品能在用户自己的电脑上运行,替人操作软件、处理邮件,甚至让多个AI助手共同完成任务。 为了降低普通电脑运行大模型的门

    来源 AI 行业观察
  4. Metric AI开源亚美尼亚语模型Ayb 0.5:90亿参数跻身前三

    Metric AI团队推出了Ayb 0.5系列开源语言模型,包含0.8B、4B和9B三个版本。该系列基于Qwen3.5架构,针对亚美尼亚语进行了深度适配,在ArmBench基准测试中表现优异,甚至超越了部分参数量更大的模型。Ayb 0.5不仅支持文本生成和指令遵循,还保留了完整的视觉语言能力,能够用亚美尼亚语描述图片。

    来源 AI 应用前沿
  5. DeepSeek-VL前负责人张博创业:高瓴投600万美元,押注低门槛大模型

    高瓴投了600万美元。一位DeepSeek早期核心成员,创业了。11月19日,DeepSeek-VL前项目负责人张博(Tony Zhang)宣布,其创办的AI公司Simplex AI正式开源个人智能体产品Linger。这款产品能在用户自己的电脑上运行,替人操作软件、处理邮件,甚至让多个AI助手共同完成任务。为了降低普通

    来源 腾讯网
  6. 信通院张立锋出席AICon北京站:讲智能体身份国际标准化

    当 Agent 真正进入企业流程,哪些工作可以交给 AI ?50 + 实战案例揭晓答案! AI 正在从回答问题的辅助工具,走向理解目标、调用系统、完成任务的工作承担者。当 Agent 真正进入企业流程,问题不再是 “如何把 AI 做出来”,而是哪些工作可以交给 AI、结果如何验收、权限、成本与风险如何收住。随着大模型向

    来源 AI 行业观察
  7. 豆包网页版上线Agent工作模式:八大功能覆盖PPT生成与AI搜索

    本文介绍豆包AI网页版的访问方式及2026年最新升级的Agent工作模式。该模式支持自主拆解任务、操作浏览器及生成文档。文章详细解析了PPT制作、图像生成、深度搜索等八大实用功能,并结合QuestMobile数据探讨其用户规模,为不同场景用户提供具体操作建议。

    来源 AI 应用前沿
  8. 张博开源Linger本地版Muse:个人电脑跑Agent,准确率95%

    智东西(公众号:zhidxcom)作者 | 黄菲编辑 | 江宇智东西11月20日报道,昨夜,前DeepSeek研究员、Simplex AI创始人张博(Tony Zhang)宣布开源个人Agent Linger,号称要让Agent摆脱对云端数据中心的依赖,直接运行在用户自己的电脑上。项目发布后迅速引发关注,GitHub星

    来源 腾讯网
  9. 苹果招聘曝光AI Agent计划:Siri要从动嘴变动手?

    苹果招聘信息透露,公司正开发可跨应用操作、独立规划并执行多步骤任务的 AI Agent,并强调隐私与权限管理。据彭博社报道,项目仍处早期阶段。面对已积累用户与收入的竞争对手,苹果正争夺下一代计算入口。

    来源 爱范儿
  10. 苹果押注自主式AI Agent:Siri要从动嘴变动手

    Siri 可能终于要从「动嘴」进化到「动手」了。让 Siri 查天气、设置闹钟、打开应用,早已不是什么新鲜事。但如果你现在让它安排一次出差,查好机票和酒店,再根据日历整理行程,恐怕还是得自己动手。苹果最近的一系列动作,透露了它想改变这种状况的野心。11 月中旬,苹果官网出现了两则与自主式 AI Agent 有关的招聘信

    来源 腾讯网
  11. 光禾AI推企业级智能体平台,FDE模式破解企业改造难题

    大模型进入企业后,如何与内部知识、业务系统和工作流程结合,成为企业推进AI应用的一道实际门槛。员工可以借助通用工具完成问答和内容生成,但涉及内部数据、多系统协作和具体业务执行时,企业仍需要解决系统接入、权限管理和持续运维等问题。 光禾AI选择以企业级智能体平台为底座,通过FDE项目改造服务,将AI能力嵌入企业实际业务。

    来源 AI 行业观察
  12. 蔚来重写NOMI底层架构:告别九年旧代码,3000项整车能力接入AI

    蔚来NOMI产研团队重写沿用九年的传统规则架构,转向以大模型主智能体为核心的原生技术架构,取消传统单向指令分发流程。新架构4月完成实车概念验证,8至9月完成3000项整车原子能力工具化改造,依托SkyOS·天枢系统运行,更多技术细节与推送计划将在11月25日公布。

    来源 凤凰科技
  13. OpenAI开放GPT-Live-1.1 API:实时双向对话,智能体边聊边干活

    OpenAI 今日宣布向开发者开放 GPT-Live-1.1 API 语音模型,允许第三方开发者将其集成到自己的应用程序中,构建能够实时聆听、回应并执行复杂任务的 AI 语音智能体。 据 OpenAI 介绍,GPT-Live-1.1 是 GPT-Live-1 的升级版本,具备全双工语音交互能力,可以

    来源 AI 开发者社区
  14. 亚马逊封堵AI购物助手,马斯克放话:也许该做个对手

    AI刚学会替你干活,亚马逊、摩根大通、嘉信理财就开始堵门了! 10月18日,@trikcode在X上列出了一份「AI碰壁清单」,点名达美航空、摩根大通、嘉信理财、Yelp和亚马逊。 他吐槽: 那些本该替我们搞定一切的AI智能体,开始被互联网挡在门外。 人愿意买,AI愿意跑腿,但最后一公里却卡在了平台不肯放行上! 而亚马

    来源 AI 行业观察
向下滚动自动加载更多