Anthropic开放Opus 5.5极速模式:一行代码换2.5倍手速
Claude Opus 5.5极速模式全面开放,提速降价附避坑指南。
刚刚, Claude最强的极速版模型向所有人开放了。
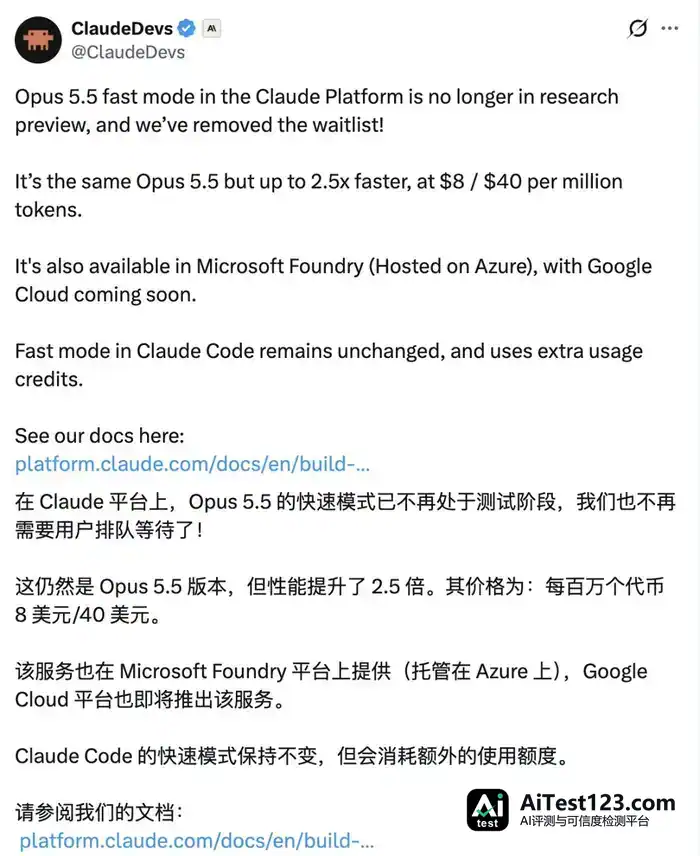
 Anthropic正式确认,Claude Opus 5.5的「极速模式」不再处于研究预览阶段,等待名单全部取消,开发者可以直接使用。
能力没有缩水,也没有做功能裁剪。只要加一行代码,Claude就能跑出2.5倍的手速。
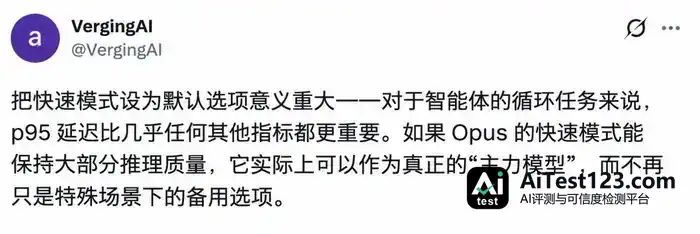
有开发者在体验后直言:我宣布, Opus 5.5现在就是我的神。还有人一句话点到了关键:「对于Agent循环来说,p95延迟比什么都重要。」
官方文档里提到的价格细节、网络配置要求,以及怎么避免账单失控,下面一并说清楚。
极速模式到底强在哪
先别急着下判断,极速模式并不是那种砍掉参数的「轻量版」。速度和效果之间,这次不用做取舍,Opus 5.5的极速模式走的是全都要的路线。
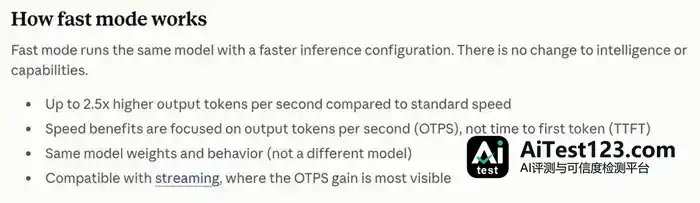
Anthropic方面透露,极速模式用的模型权重和智力水平和标准版一模一样。它不属于「低智」的阉割版本,而是通过优化底层API和推理配置,把资源倾斜到响应速度这一侧。
换来的效果是:每秒输出Token速度(OTPS)最高提升2.5倍。
用起来适合哪些场景?快速迭代爆款代码、实动态调试,还有时间紧任务重的极限冲刺。
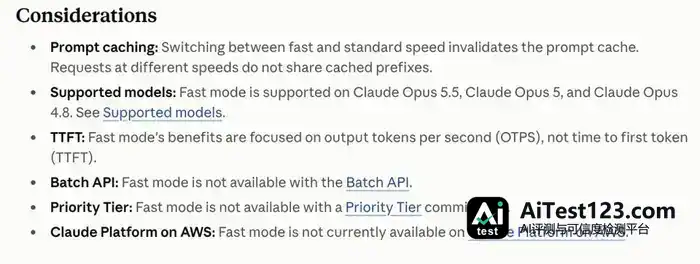
目前这一模式只覆盖Opus 5.5、Opus 5和Opus 4.8三款。Sonnet、Haiku以及其余模型都不支持。此前Opus 4.7的极速版已经在2026年6月停用。
怎么开启?操作没什么门槛。在API请求里加上一句:
speed: "fast"
就能直接调出极速版。
用Claude Code的话,在CLI里敲 /fast 就能随时开关;VS Code用户通过插件也能一键切换。
提速还降价?账单对比让人极度舒适
速度提了2.5倍,价格是不是也跟着涨?实际情况正好相反,Anthropic这回还顺手做了一轮「提速降费」。
最核心的价格对比看这里(每百万Token):
Opus 5 和 Opus 4.8 在极速模式下,输入每百万 Token 收 $10、输出 $50;到了 Opus 5.5 极速模式,这两项分别降到 $8 和 $40。
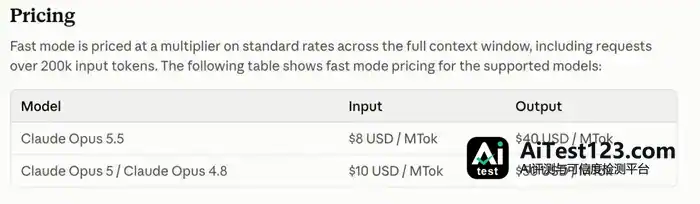
对,最强的那版,价格反倒更低。
避坑指南
下面这几条得留神,都是容易踩的坑。
极速模式走的是独立速率限制,不会跟别人抢资源。
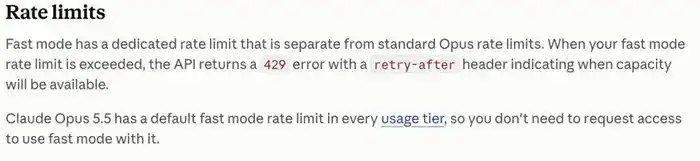
万一用力过猛顶到上限,系统会平顺地退回标准速度,冷却期一过又自动切回极速,不会让你彻底卡住。
Prompt Cache 在极速模式和标准模式之间是不互通的。
官方的建议很直接:会话一开始就把极速模式打开。要是中途才切,很可能得重新掏一笔没有缓存的输入费用。
这笔初始费用一次对话只收一回,之后不管你怎么反复开关极速模式,都不会再收。
使用额度怎么扣
Pro/Max/Team/Enterprise 的订阅用户要注意,极速模式单独走使用额度计费,不含在原有订阅额度里。
账单去哪儿看
钱到底花在哪了?先敲 /status 命令,确认自己是用哪种方式登录的。
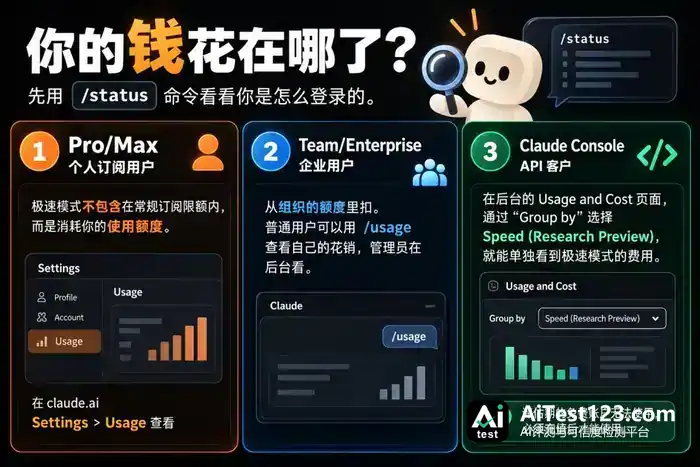
1.Pro/Max 个人订阅用户:极速模式不在常规订阅限额内,扣的是「使用额度」,得去 claude.ai 的 Settings > Usage 查看。
2.Team/Enterprise 企业用户:从组织额度里扣。普通用户用 /usage 看自己的花销,管理员则去后台查。
3.Claude Console(API 客户):进后台的 Usage and Cost 页面,在「Group by」菜单里选 Speed (Research Preview),极速模式的花费就单独列出来了。评估期的免费账户用不了,必须先充值。
极速模式怎么开
这回开放最实在的一点,就是不用申请。
API 开发者不用发邮件、不用填表,直接在请求里加个参数——speed: "fast" 就行。
目前 API 和微软 Azure Foundry 已经上线,Google Cloud 马上跟进。AWS Bedrock 等平台暂时还不支持。
Claude Code (CLI) 用户在终端里的体验相当顺。
敲 /fast,按空格键切换开/关,回车确认。
打开之后,终端会显示「Fast mode ON」,提示词旁边也会多出一个闪电图标 ↯。
甚至可以在 Claude 正输出思考内容的时候敲 /fast,它会用标准速度把当前这轮答完,下一轮自动提速。
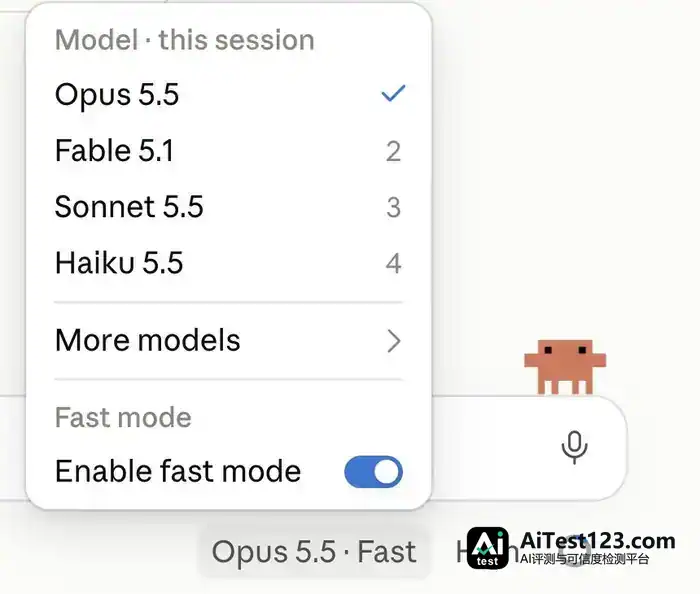
在 Claude Code v2.1.280 及其之后的版本里,极速模式默认调用的就是 Opus 5.5。用户配置文件同样支持把 "fastMode": true 写死,直接锁定这一档。
模型切换跟极速模式之间还存在一套联动关系。
一旦你在开启极速模式的状态下用 /model 换到不支持它的模型(譬如 Sonnet),极速模式会自行关掉;反过来,只要切回 Opus 5.5,而此前保存的偏好是开着的,闪电图标 ↯ 就会重新亮起。
云端会话的用法是输入 /fast on,作用范围仅限当前这一轮会话。
企业级管控,怎么防破产?
消息传开后,评论区不少人表达了担心,有人原话是:「最可怕的是默认开启,我们中一半的人可能在还没发现之前,就烧掉了200美元的Token。」
为了避免员工的把公司预算一次性打光,Anthropic 拿出了一套粒度很细的企业级管控办法。
强制按会话开启
管理员可以在 settings.json 或服务器级配置里写上 "fastModePerSessionOptIn": true,这样每开一个新会话,极速模式都默认处于关闭状态,员工想用就得自己敲 /fast。
对那些一口气开十几个终端并发跑任务、疯狂消耗额度的员工来说,这招能起到约束作用。
速率限制与优雅降级
极速模式配有独立的速率限制池。请求量过猛触到上限时,它不会直接报错卡住,而是自动退回标准速度。
此时闪电图标转灰,进入冷却。等冷却结束,2.5 倍速会自动回来。
另一种情况是「使用额度」在会话进行到一半时耗尽,它同样会降到标准速度接着跑,终端会提示你额度已经用完,不至于让手头的活儿白做。
One More Thing:一个帮你省钱的神仙功能
说到省钱,还得提一下 Claude 近期上线的另一个热门功能:空闲压缩。
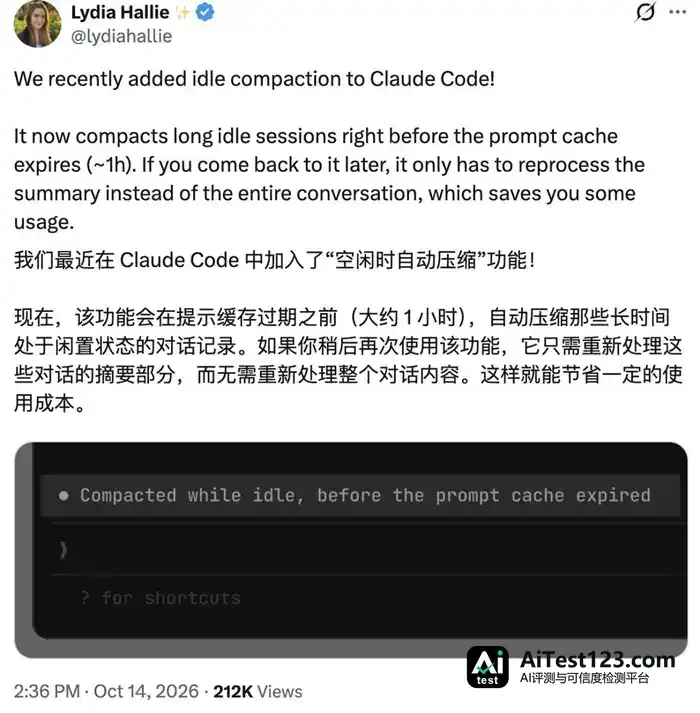
过去面对一个 20 万 Token 的长会话,开完会回来,提示词缓存已经失效,这时哪怕只是让 AI 写一行代码,它也得把这 20 万 Token 从头「读」一遍,几美金转眼就没了。
现在 Claude 会「自动存盘」了:在缓存失效前(大约连续闲置 54 分钟),它会把长篇对话压成一份精炼摘要,等你回来接着干活,只需读摘要就能续上思路,Token 的重复消耗因此大幅下降。
注意,需满足以下条件:
要触发这套省钱机制,得同时凑齐几个条件:会话在终端里跑够 1 小时、提示词缓存被用上,上下文规模得顶到 20 万 Token,机器不能进入睡眠,还得连续空转大约 54 分钟——说白了就是趁那 1 小时缓存还没过期赶紧动手。
可省下的钱并不是白拿的。GitHub 上就有开发者吐槽,一晚上 7 个长会话被系统自动压缩,底层的技术决策细节被 AI 直接忘掉了。
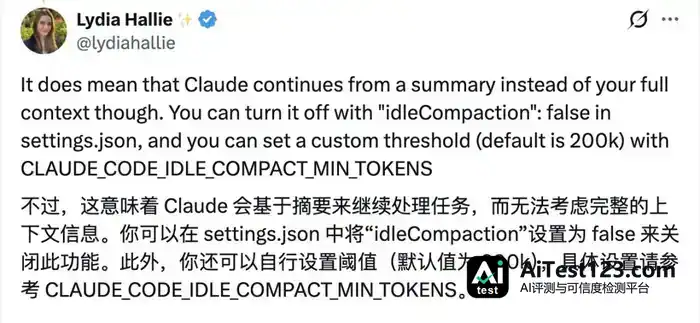
Anthropic 这边反应不慢,很快把关闭选项补上了。改 settings.json 里的 "idleCompaction": false 就能停掉;触发门槛也能通过环境变量自己定,默认值仍是 20 万,控制权交回用户手里。
更大Boss: Fable 5.5即将来袭?
同一天还有消息传出,Fable 5.5 据称已进入早期访问,向一批公司和个人开了灰度。眼下它只差把测试收尾,就能正式对外发布。
圈内不少人觉得这个时间点挑得挺合适——Anthropic 在 IPO 之前正好多留些时间造势。但也有人泼冷水:Fable 5.5 得真的足够能打,才对得起它吃掉那么多用量,否则用户没理由放着 Opus 不用。
对没走 API 的普通订阅用户而言,Fable 5.5 的价格恐怕高得吓人:几个长提示词扔进去,5 小时的额度就见底了。也就是说,初期真正用得起的,可能只有那些肯为每百万 Token 掏 50 美元以上的企业客户,这个「性能怪兽」暂时还离普通人有点远。
无论如何,2.5 倍性能的 Opus 5.5 极速版已经摆在面前了。不说了,赶快去蹬吧。
参考资料:
https://platform.claude.com/docs/en/build-with-claude/fast-mode#supported-models