OpenAI解散机器人团队:通用大模型接管,Astra仿真成功率74.8%
GPT-6掀了具身模型牌桌,这个缺口逼疯全行业!下一个估值千亿新..

新智元报道
新智元报道

Fortune前几天独家爆料,OpenAI把独立的机器人团队给解散了。
消息传开,AI圈刷屏。不少人第一反应是:奥特曼这是不打算碰机器人了?
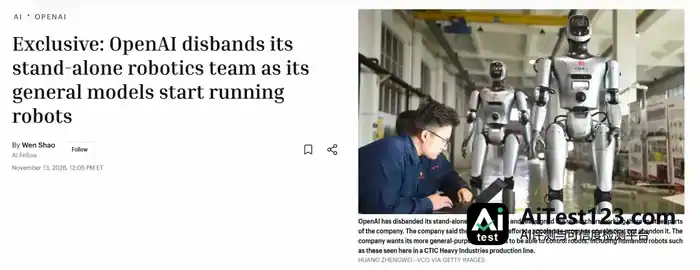
可再细看,与其说是「放弃」,不如说是「升维」——
背后的道理在于,通用大模型已经能直接操控机器人,单独养一支「特种部队」没必要了。
英伟达一项研究显示,Astra在仿真操作基准上的成功率是74.8%,专用机器人模型的最好成绩为51.0%。
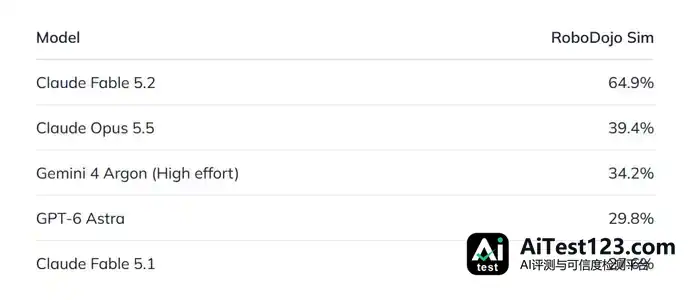
Anthropic这边更激进:Fable 5.2在RoboDojo上自测拿到64.9%,超过Astra两倍多。
国内具身智能圈子的第一反应是:降维打击来了。
不过先别慌。把能找着的数字都算一遍,结论反倒跟这个判断相反——大模型厂商下场,并不是来砸场子的。它们做的,是给具身智能这张牌桌多添了几把椅子,而且新来的这几位,手里攥着最大的算力和最厚的钱包。
具身的「 GPT时刻」会因此提前!可这些大佬刚坐下,就撞上了一堵墙,跟六年前那堵一模一样——数据。
相同的地方在于,做物理世界的AI照样被数据卡着脖子;不同的地方在于,这一回市场上已经「长出」了专门生产数据的基础设施公司。这场仗的打法,已经完全不一样了。

大模型怎么忽然就这么会操控机器人了?说白了,它是在用「写代码」的路子去控制机器人。
强的地方确实强得离谱。听懂任务、拆解步骤、规划先后,这类「上半身」能力过去被具身公司当作壁垒,如今通用模型拿过来就能直接用。
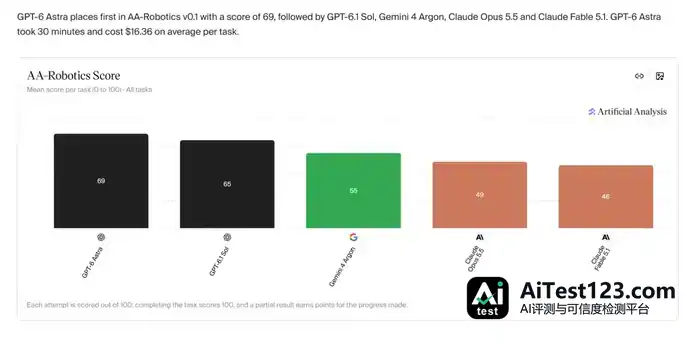
可弱点同样扎眼。AA-Robotics公布过一组数字:Astra平均完成一个任务要30分钟,花掉16美元。好家伙,这速度和成本要是搬到工厂里拧一颗螺丝,厂长怕是会先把机器人拧下来。
问题出在哪?云端大模型反应太慢了。机器人关节的控制频率是每秒上百次到上千次,云端大模型想一步却要好几秒。
碰上要快、要准、还得靠手上力道反馈的活儿,有头部机器人团队实测过,通用大模型的成功率接近于零。

卡内基梅隆大学石冠亚认为,反应慢、离不开网络,是云端大模型的两个短板,因此机器人身上还得配小而专的模型。
换个说法,更贴近实际的画面是分层协作:顶层由大模型负责「想」,承担长程推理与规划;中间层是一批批练出来的动作技能,供它当工具调用;最下面一层,则是毫秒级的电机控制。
最上面这一层,大模型厂商已经先拿下了。可要往下一层走,他们手上偏偏缺一样东西:动作数据。
于是眼下的真实变化落在名单上:做具身基座模型的公司,越来越多了。
过去坐在这张牌桌旁的,是Physical Intelligence、Figure、Generalist这类「原生具身玩家」。
如今OpenAI也进来了。奥特曼称,2027年要拿出自研人形机器人的演示。Anthropic和谷歌的模型,同样已经出现在榜单上。
国内这边,投入也在加码。
8月,DeepSeek出资约1.41亿元,参与宇树科技IPO战略配售;更早之前,字节已把Seed Robotics纳入多模态交互与世界模型体系。蚂蚁旗下灵波、小米、京东,也各自发布了具身模型。
把全球范围加起来,练具身模型的公司接近一百家。
新入场的这几家和老玩家有一处根本不同:模型直接奔着万亿参数去,预算按百亿美元计,算力集群还是现成的。
大语言模型这些年,从来没为数据发过愁。
互联网三十年沉淀下来的文字,拿来就能用。主流大模型做预训练,语料规模大约100万亿token,比的是算力和算法。
具身智能走的是另一条路,恰好倒过来。物理世界不存在一个「互联网」,人手怎么抓、怎么拧、使多大劲儿,这类操作过程始终没人系统记下来。
2024年底,全球最大的真机数据集不过3000小时上下;到2025年下半年,Generalist拿约30万小时训出了GEN-0;今年Dyna、智元等头部玩家的训练集已经越过百万小时。
两年间涨了几百倍,数字看着唬人。可语言模型那边是100亿小时,一比就露底,中间还隔着三四个数量级。
数据喂进去到底管不管用?效果来得相当直接。
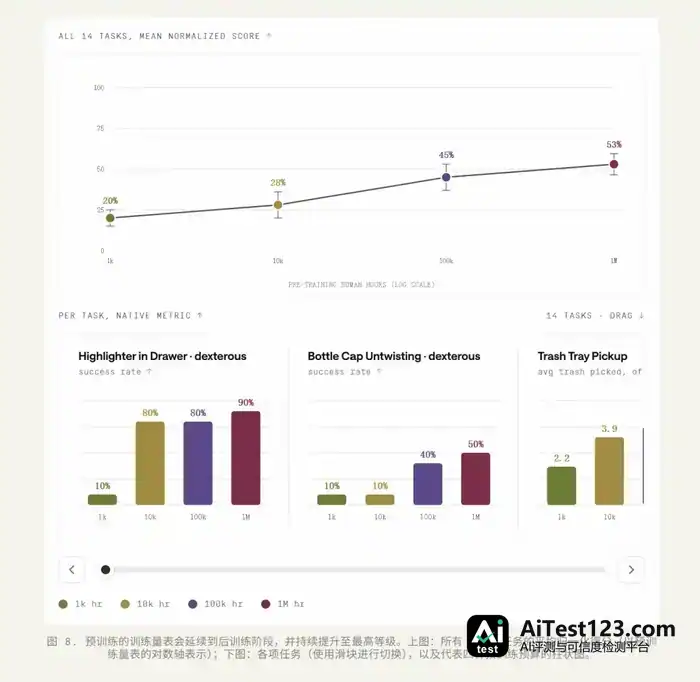
Dyna Robotics 8月给出的结果是:预训练数据由1000小时扩到100万小时,模型在14项机器人任务上的平均得分从20%升到53%。
业内估算,训一个万亿参数的具身基座,起码要1亿小时;到2030年,全球大约有20个这样的基座同时在练,总需求落在数十亿小时。
风投机构Stellaris的算法差不太多:未来两三年,Frontier Lab需要1亿到10亿小时的第一视角数据,对应的支出是15亿到500亿美元。
麻烦在于,这些数据没法靠「拍」攒出来。
今年4月,Build AI把约100万小时的工厂第一视角视频开源,允许免费商用。按说数据荒能松一口气,可头部厂商照样到处抢货。
原因在于,机器人真正要掌握的是三维空间里每一毫秒的轨迹:手在什么位置、朝哪个方向、又是怎么动的。
要把2D视频变成3D轨迹,得让多路相机在毫秒级上完成对齐,把手部姿态重建到毫米级,再折算成不同机器人各自的关节动作。
具身数据,其实是造出来的。
可让模型厂商自己去采,同样不现实。
OpenAI在旧金山的实验室雇了约100名数据采集员,一年算满也就20万工时;按数采厂普遍8小时才出1到4小时有效数据的水平,全年有效产出不过几万到十万小时,跟千万小时相比差着两个数量级。
所以钱再多,也只能往外买。
摆在行业面前的现实是:模型公司对数据质量、颗粒度和稀缺场景的要求,只会一轮比一轮高。
每一轮AI浪潮,都会长出体量可观的数据公司。
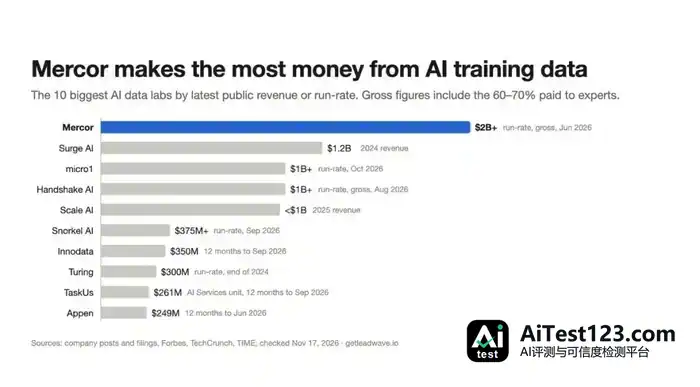
自动驾驶那一轮跑出来的是Scale AI:2024年F轮融了10亿美元,估值138亿美元;去年Meta花143亿美元入股,估值随之升到290亿美元。
到了大语言模型这一轮,跑出来的是Surge AI和Mercor。Surge AI没融过资,2024年收入就过了10亿美元;Mercor年化收入超过20亿美元。
国内这边,一家叫UniPat的评测数据公司成立还不到一年,就有消息说阿里打算领投3亿美元,估值给到25亿美元。具身智能这一轮,我们的判断是会跑出体量更大的数据平台。支撑这个判断的有三条理由。
头一条,具身智能的数据壁垒更高。前两轮的原始语料,不是互联网上现成摆着的,就是车队自己跑出来的,数据公司卖的无非是标注和专家工时;具身这边,连预训练语料本身都得掏钱从零生产。
再一条,具身数据更难拿到,也更稀缺,投入的优先级更高。自动驾驶是车先上路,司机天天都在产生数据;机器人不一样,没有好模型就进不了场景,进不了场景就没有数据,只能先有数据,才有模型,再有应用。数据公司的角色,也就从配套服务变成了前置基建。
还有一条,数据范式会变,需求却一直在,这买卖不是做一锤子。基座预训练只是第一单,每落地一个场景,就得补真机数据做后训练。部署之后还有回流、补采、再训练。等模型把应用打开,垂直小模型、集成商、方案商还会接着来买。
这个规模放在市场里看很惊人:按现在的价格,第一视角数据每小时一两百元,千万小时算下来就是10到20亿元;而IDC预计2026年中国AI基础数据服务市场整体为78亿元。也就是说,单是一家头部客户的一张订单,就占到该市场的八分之一到四分之一。
不过这笔钱不好挣,买家买的并不是「小时数」。行业里流传着一个「大冤种」案例:某家公司上半年买了100万小时数据,拿回来一验,当场傻眼——能用的只有一两成!
表面上看,标价只有100元一小时,可算上报废的那些,折下来真实成本到了500到1000元。
便宜反而更坑,这话放在这里再合适不过。
细看这些数据,里面的门道和隐患不少。
有的场景是假的,数采厂的格子间里,人就对着桌子叠衣服;有的画面质量差,掉帧、过曝,手还经常跑出画面。处理上也粗糙,几路相机没对齐到毫秒,轨迹误差有好几厘米。
看得出来,具身智能数据这一行已经变了:过去是低质数据卖来卖去,现在客户盯的是精度和场景。
说到底,没有技术能力的公司会被淘汰出局。
数据稀缺到这个程度,头部买家掏钱前主要看三件事。
头一件,品类够不够全。
行业里的共识是:打底要用百万小时级的人类第一视角数据,动作适配靠几万小时真机数据,最后再补少量现场数据落地。只做其中一种的供应商,就只能参与其中一段。
第二件,交付能力稳不稳。
客户那边的数据标准其实比较统一,多数公司送样后不是质量不达标,就是交付跟不上,大单自然吃不下。
这样一来,能稳定供货交付的数据公司更容易留住客户。谁证明自己接得住大单又不掉链子,大厂就愿意跟谁长期绑在一起,别人想挖都挖不走。
第三件,看能不能闭环。
模型团队一旦发现某项能力存在短板,供应方就得依照指定任务去补充采集,并且要拿出证据说明补采之后确实管用。

眼下国内涉足具身数据的公司数量在持续增加。
可要是细看,这条赛道并没有表面上那么挤。
为什么会这样?说到底,门槛摆得相当高。
要做具身数据,三种能力得同时具备:一是硬件制造,设备必须自研,能批量生产,一致性也要过关;二是算法处理,从原始视频中算出三维轨迹,精度要够用;三是场景运营,能进入工厂、商超、医院这类真实环境,还得把采集生态网络搭起来。
这三种能力,背后其实是不同的基因。于是出现了一个反差:看起来做数据的公司越冒越多,数据本身却变得极为稀缺。
真正能做到端到端交付、让头部客户验收签单的,数下来没有几家。
公开信息显示,觅蜂科技是当下少数把这三件事同时做成规模化的公司。它被看作「最懂模型和场景需求」的物理AI数据基础设施平台,真机、仿真、无本体三类训练数据都能一站式提供。
它走的路子和多数数据公司不同。行业里常见的打法,是先攥住一批设备或场景资源,采上一批数据,再拿着数据去找客户。
觅蜂的打法跟这相反。它先看海内外头部模型客户要什么:精度到什么水平、场景怎么配比、数据用什么格式,然后据此回头定硬件和管线的设计。

后厨

宠物洗护
方向这么一倒过来,往后的差距就显出来了。
采集这一端最要紧的,是设备大批量铺开之后还能不能保持一致。
做数据采集,单台设备跑得顺不算本事。2万台设备散在几十个城市、几千名采集员手上,还要保证每一台出来的精度、时序、格式都能对得上,这才难。
行业里经常出现的是另一种局面:一百台设备发下去,二三十台会出问题,工时大量花在修设备、调参数上面。
觅蜂则把采集设备按消费级硬件的标准来做量产:记录精度到毫米级,无线连接,机身轻,电池能快换,零部件能快拆。
别看这些设计平平无奇,落到工业场景里全是要命的坎:分布式部署能不能稳住,出故障能不能立刻替换,多台设备采回来的数据能不能彼此对齐。
靠这套思路,觅蜂4月发布、6月量产,到8月底已经做出两万套。这样的节奏,业内找不出第二家。
设备铺开了,产能自然跟着往上走。
百万小时的无本体数据,他们只用三个月就完成,平均一天能产出过万小时。

这百万小时数据
对比一下,Scale AI披露的口径是每天采集1000多小时,2025年全年交付15万小时,和觅峰的数据差了一个量级。
数据管线真正要解决的问题,其实不是能不能处理,而是处理得有没有效率。
前面提过,行业里采回100万小时,能用的往往只有一两成。觅蜂的有效率却做到了90%以上。
觅峰的百万小时由哪些部分构成
说到底,他们赢在把每个细节都抠到位,在各个环节上拉开差距。设备端,手部空间定位精度达到毫米级,多路传感器信号对齐做到亚毫秒。
质检分成三层来做。采集端先把六成明显问题挡下来,云端再用视觉语言模型自动做语义判断,最后人工抽检,偏差控制在1%以内。整条管线里,最吃算法功力的一环是轨迹重建。
觅蜂自研的HandPose算法把精度做到了亚厘米级。遇到遮挡、交互、快速运动这些真实场景,重建误差比业界次优方案低了一大截。搁在行业里看,这个水平已经处在第一梯队。
效率上,整条管线一天能吞吐上万小时,从原始数据到可训练资产,全程自动跑,不用人一条条处理。同样的时间能给客户交出多少可用数据,直接由这一步决定。
美甲
还有一层最容易被忽视,壁垒却最高,那就是闭环能力。多数供应商的服务到「质检合格,交付签收」就结束了。数据交出去以后,模型训练效果如何、哪些数据有用、哪些是噪声、缺口又在哪,供应商往往并不清楚,也没本事去验证。
觅蜂的做法是自己研发端到端模型,自己上真机部署,用这套东西检验数据有效性,研究配比和补采策略。部分场景的测试显示,每跑一轮数据闭环,任务成功率能涨5到10个百分点。第一视角运动重建框架MEgoVista也是在这条思路下做出来的。
这样一来,客户模型团队一旦察觉某项能力欠缺,觅蜂便可围绕指定任务进行定向补采,还能证明补采之后确实管用。双方由此形成联合迭代的协作关系,而非一锤子买卖的数据交易。
公开信息显示,觅蜂已与数十家客户建立合作,覆盖大模型平台、具身与世界模型公司以及机器人本体厂商。腾讯Robotics X、蚂蚁灵波都公开用过它的数据,智元GO3基座模型的训练数据里同样有其贡献。在海外市场,它已跻身多家头部科技公司的核心供应商行列。
模具维修
不过,数据量要从百万小时跃升到一亿小时,仅靠数采厂做线性复制显然撑不住。
觅蜂选择的是众包路径。9月推出的觅蜂派让普通人戴上设备、一边干活一边采数据,眼下注册用户超过20万,覆盖50多个城市;酒店、商超、医院、工厂等50多家场景方也已加入其数据联盟。
下一步的关键看点在于:众包能否在把有效率维持在90%以上的同时,将规模再提升一个数量级。
说回开头那个问题:大模型来了,对具身智能算不算「降维打击」?
可仔细分析下来,答案正好反过来——这对具身行业是好消息!
牌桌会变大,钱会变多,整个行业的推进节奏也会被带快。
业内原先预计,具身智能的GPT-3时刻大约会在2030年前后出现。
然而这几个月榜单刷新的速度说明,这个时刻会来得更早。每多一个带着万亿参数大模型入局的玩家,市场对数据的缺口就会再扩大一轮。
道理很简单:模型跑得越快,要的数据就越多。
OpenAI曾两次解散机器人团队。头一次是缺数据;这一回模型已经就位,最缺的仍然是数据。
不一样的地方在于,已经有人把生产数据当成一门正经生意在做。