

OpenAI自曝AI研发AI闭环成型,研究员日均智能体开销2400美元
OpenAI毫无征兆地宣布:「递归自我提升」(RSI,Recursive Self-Improvement)的齿轮,已经正式开始转动。
OpenAI突然对外发声:「递归自我提升」(RSI,Recursive Self-Improvement)的齿轮,已经正式转起来了。
说白了,OpenAI这是亲口作证:AI已经开始研发AI了。
超级人工智能(ASI)哪天会来,人们猜了很久。大家的注意力一直放在大模型的跑分上,放在参数量的飙升上。
但OpenAI给出的说法很明确:通向ASI的真正拐点,并非模型跑分超过人类,而是「AI开发AI」这个闭环成型。
算力狂欢,每天烧掉2.3万美金的「超级打工人」
在OpenAI内部,研究员用AI智能体的频率已经彻底失控——当然是往上的失控。
按API标价算,今年9月花在智能体上的钱,中位数研究员是每人每天1500美元。
只过了一个月,10月这个数字就冲到了2400美元,增幅高达62%。

这还只是平均水平。排在前10%的「重度用户」呢?他们每天在智能体上烧掉的额度高达23000美元,环比暴增105%。
一天两万多美金。对API价格有概念的人就明白,这背后是何等庞大的代码生成量、逻辑推理推演和并发任务执行。敲键盘的不是人类,是成百上千个「硅基大脑」在不知疲倦地全速运转。
为了更直观地衡量,OpenAI引入了一个概念:「智能体工作日」(每8小时的智能体使用算作一个工作日)。
数据显示,每位研究员每天平均的「智能体工作日」,已经从最初的0.5个飙升到了5.7个,足足增长了11倍!
在最核心的预训练和后训练团队,这个数字更是达到了8个。

也就是说,一个人类研究员每天工作8小时,他的「AI分身们」在同一时间里并发完成了相当于64个小时的工作量。
到了10月中旬,超过十分之一的研究员,每天手头都有至少16个智能体在同时处理任务。
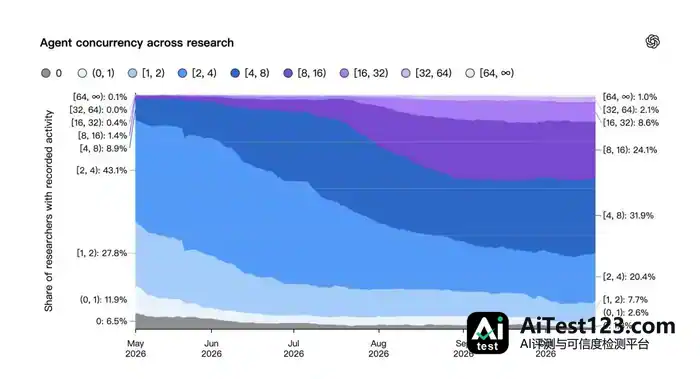
人类工程师对这些AI工具的依赖,已经到了近乎「成瘾」的地步。
OpenAI内部做过一项匿名调查,研究员们被问到一个极其尖锐的问题:「如果未来3个月内,没收你们所有优于GPT-5.2的编码智能体,你愿意拿什么条件来换回它们?」
中位数的回答让人震撼:他们宁愿裁掉团队40%的人手,或者削减当前团队30%的核心算力。

在最顶尖的AI研究员眼里,几台昂贵的H100算力集群,甚至身边活生生的同事,都已经比不上一个前沿编码智能体的价值。
真正让人后背发凉的细节:AI开始拥有「科研品味」
真正让硅谷大佬们惊呼「疯狂」的,是GPT-6.2 Astra的研发内幕。
在过去,大想法(Big Ideas)总是人类的专属领地。
更早的GPT-6 Astra版本开发期间,OpenAI的研究员还带着几分自豪:真正核心的科研思路都由人想出来,模型不过是个高级码农,任务是把这些想法落成代码。
但到了GPT-6.2 Astra,情况发生了微妙但致命的变化。
预训练团队的研究员在访谈里提到,那个核心洞见其实是在跟模型(Codex)反复对话的过程中冒出来的。
有位研究员说得很直接:大家一起推进某个想法时,Codex把关键洞见准确地点了出来。
另一位核心成员也承认,自己起初的思路走进了死胡同,「只有在Codex建议做出改变后,整个想法才真正开始奏效。」
AI开始有了直觉,能看出人类没注意到的盲点,甚至反过来教人怎么造出更好的AI。
这套本事被叫作「科研品味」(Research Taste)。
找问题通常比解问题更难。等AI能分辨「什么样的数据更好」、「什么样的架构更有前途」,潘多拉的魔盒才算真正打开。
一名开发者发推,把这个反馈循环(Feedback Loop)画了出来:
- 研究人员希望AI模型在逻辑推理上更强。
- 他们召出几十个智能体,让它们写底层代码、配环境、跑海量实验,再测出到底哪几行改动真的管用。
- 被智能体验证成功的那些改动,会被打包塞进下一个版本的模型。
- 新版本因此更聪明,反过来又能帮研究人员去啃上一个版本根本看不懂的、更难的代码Bug。
就这样一圈接一圈,停不下来。
每一个更好的AI,都在用前所未有的速度帮人类造出下一个更强的AI。这就是真正的「递归自我提升」(RSI)。
一旦这个飞轮转到某个临界点,AI的发展速度就会彻底甩开人类习惯的线性认知,呈现出近乎垂直的指数级爆炸。
崎岖的前沿:「闭环」已成,但人类依然是瓶颈
不过,现在就宣布AI已经完全自主,未免过于耸人听闻。
OpenAI也坦承,眼下的技术仍有巨大的局限。他们把当前阶段称为「崎岖的前沿」(Jagged Frontier)。
什么叫崎岖?就是偏科得厉害。
智能体处理复杂研发任务的表现有明显变化。3月到10月,那些预计要花2到4小时才能完成的活,在人类完全不插手的情况下,「零干预成功率」从23%升到了46%,翻了一倍。长线任务难度更大、要4到8小时,成功率同样往上走,从13%提高到了35%。

可把任务拆细来看,AI的能力边界就参差不齐了。监控训练运行问题,成功率79%;编写底层推理和服务栈代码,成功率只有25%。
数据说明,任务一旦涉及高度抽象的「从零构建」,AI的成功率就会骤降。
沟通(69%)和分析(58%)上它极其出色,开发(43%)上却依然像个莽撞的学徒。

内部访谈里,人类研究员对AI的吐槽依然密集。
为了修一个小Bug,AI会去重构整个模块,钻牛角尖;它会写出看着华丽、实际跑不通的「AI垃圾」PR(拉取请求);它还会产出不可用的数据,甚至做出极其荒谬的分析假设。
一位做后训练评估的研究员,说起自己现在的工作流,语气里透着无奈:
「以前我试过直接跟AI讲『你把这个任务做成那个任务那样』,结果被坑了太多回。它总会理解偏,最后还得我去给它收拾残局。
所以现在换了打法。我说:『你先做一个,我来审、我来改。等我确认没问题了,你再去把剩下那一万个做完。』」
这就是眼下的现实。人类仍然是AI研发闭环里绕不开的一环,只是身份变了——从「创作者」成了「审核员」。
最开始的判断力和容错底线由人来给,AI要做的,是把这条底线放大一万倍。
可这种平衡非常脆弱。报告里一位研究员留下过一句话,意味深长:「我确实认为,我现在在科研想法上比AI更有品味。但我完全没有信心,这种情况还能在多长的时间内继续成立。」
终局已定?OpenAI的紧急呼吁与新秩序
报告末尾,OpenAI少见地发出了一项颇有压迫感的行业呼吁:强制公开RSI指标。
他们的主张是,所有顶尖AI实验室都该被要求追踪并公开报告「递归自我提升」的核心指标。AI加速开发未来AI系统的过程究竟走到了哪一步,公众和监管机构有权知道。
公开的理由很直接:进步的速度,已经快到传统直觉跟不上。
报告披露,用来衡量通用AI能力进步趋势的OpenAIECI(内部能力指数)显示,自2025年8月以来,OpenAI模型的ECI前沿正以每年16.4点的速度狂飙,高于行业平均的14点。

更让人吃惊的是,这么惊人的进步,只动用了OpenAI总研发算力的2%来部署内部智能体。
试想,当这个比例变成20%、50%甚至80%,会发生什么?
传统的「人类研发周期」正在被打破。过去迭代一个模型,要半年收集数据、三个月训练、两个月微调。如今智能体靠着并发的算力,几小时就能干完人类几周的活。
报告里的警告是:历史趋势,可能已经无法预测未来。
数学领域,前沿模型近期已经出现了突然而快速的突破,AI领域的「突变」随时可能到来。
参考资料:
https://x.com/vishalsingh2972/status/2123210078224617890
https://openai.com/index/research-acceleration-jagged-frontier/












